Capítulo 13: Recuperación ante Desastres con Multi-Agentes en Producción
La resiliencia no es la ausencia de fallos; es la capacidad institucionalizada de recuperarse de ellos más rápido de lo que se producen.
El problema de la continuidad en sistemas que piensan
Sección titulada «El problema de la continuidad en sistemas que piensan»Cuando un sistema distribuido tradicional falla, el daño es predecible: un servidor deja de responder, una base de datos se vuelve inaccesible, un servicio devuelve errores 503. Los procedimientos de recuperación ante desastres (DR, por su acrónimo en inglés) clásicos (normalizados por el NIST SP 800-34 Rev.1 y la ISO 22301:2019) fueron concebidos para este modelo de fallos discretos y localizados: detectar, aislar, restaurar, verificar.
Los ecosistemas multiagente introducen una dimensión de complejidad cualitativamente diferente. Un agente orquestador no solo falla; puede fallar mientras mantiene estado distribuido parcialmente consistente, mientras coordina transacciones de saga con compensaciones pendientes, mientras otros agentes del enjambre esperan instrucciones o han tomado decisiones basadas en información que ya es inconsistente. La recuperación, en este contexto, no consiste en restaurar un servicio; consiste en restaurar un estado cognitivo coherente de un sistema distribuido que tiene memoria, intenciones en curso y compromisos incumplidos.
Patterson et al. (2002), en el proyecto Recovery-Oriented Computing (ROC) de la Universidad de California en Berkeley, argumentaron que los sistemas modernos deben diseñarse asumiendo el fallo como condición normal, no excepcional. Esta premisa (radical en 2002) es una verdad operacional cotidiana en los ecosistemas multiagente de producción de hoy. El informe DORA 2023 (State of DevOps Report) registra que las organizaciones de élite recuperan servicios en menos de una hora ante incidentes de cualquier complejidad, mientras que las organizaciones de bajo rendimiento tardan más de una semana: una brecha de 168x que es, en gran medida, una brecha en la madurez del DR.
Versión académica: La distinción fundamental entre el DR clásico y el DR agéntico radica en la naturaleza del estado que debe recuperarse. En los sistemas de software tradicionales, el estado es predominantemente datos persistidos en almacenamiento estructurado; su recuperación se reduce a restaurar una instantánea y repetir transacciones pendientes. En los sistemas multiagente, el estado incorpora una dimensión cognitiva (el contexto de razonamiento, las intenciones en curso, las memorias a corto y largo plazo de cada agente) que no es directamente serializable mediante los mecanismos de checkpoint de las bases de datos convencionales. Esta asimetría impone la necesidad de protocolos DR especializados que traten el estado cognitivo distribuido como un artefacto de primera clase en la planificación de continuidad.
Definiciones operacionales: el vocabulario del DR agéntico
Sección titulada «Definiciones operacionales: el vocabulario del DR agéntico»Antes de proceder, cabe establecer precisiones terminológicas que el sector emplea de forma inconsistente:
| Término | Definición operacional | Dimensión agéntica específica |
|---|---|---|
| RPO (Recovery Point Objective) | Máxima antigüedad de datos tolerada tras la recuperación | Incluye el contexto cognitivo de los agentes, no solo datos persistidos |
| RTO (Recovery Time Objective) | Tiempo máximo desde el fallo hasta la restauración del servicio | Incluye el tiempo de reconstitución del estado de los agentes |
| MTTR (Mean Time To Recovery) | Promedio real observado de tiempo de recuperación | Indicador de rendimiento; RPO y RTO son objetivos de diseño |
| Pilot Light | Solo los componentes mínimos activos en la región DR | Agentes mínimos (orchestrator + health monitor) en standby |
| Warm Standby | Versión reducida pero funcional en la región DR | Enjambre completo en baja carga, sin procesar tráfico de producción |
| Active-Active | Ambas regiones procesan tráfico simultáneamente | El enjambre se distribuye geográficamente con consenso distribuido |
Taxonomía de desastres en ecosistemas agénticos
Sección titulada «Taxonomía de desastres en ecosistemas agénticos»Los fallos que afectan a ecosistemas multiagente se clasifican en cinco categorías con tratamientos DR cualitativamente distintos:
| Categoría | Descripción | Impacto agéntico específico | RTO recomendado |
|---|---|---|---|
| Fallo de infraestructura | Datacenter, zona de disponibilidad, región cloud | Estado de agentes perdido; coordinación rota | 15–60 min |
| Fallo de modelo | API de LLM no disponible; modelo degradado | Agentes cognitivo-dependientes no ejecutan | 5–30 min (fallback determinista) |
| Corrupción de estado | Memoria agéntica inconsistente; contexto corrompido | Decisiones basadas en contexto inválido | 30–120 min |
| Fallo en cascada | Un agente compromete a otros en el enjambre | Propagación de errores a través del grafo de dependencias | Variable (≥60 min) |
| Ataque dirigido durante DR | Adversario aprovecha el caos del incidente | DR como vector de exfiltración o propagación de ransomware | N/A (prevención) |
Los fallos de modelo (específicos de los sistemas agénticos) carecen de equivalente en los marcos DR tradicionales. El NIST SP 800-34 Rev.1 no contempla el escenario en que el servicio de inferencia del que depende el sistema para razonar se vuelve temporalmente indisponible o produce salidas degradadas. Esta brecha obliga a extender el framework DR clásico con una capa de resiliencia cognitiva: la capacidad del enjambre de operar en modo degradado determinista cuando los modelos de IA no están disponibles.
DR para arquitecturas cloud puras
Sección titulada «DR para arquitecturas cloud puras»El dilema de la replicación geográfica
Sección titulada «El dilema de la replicación geográfica»En una arquitectura puramente cloud, el DR se articula alrededor de la replicación geográfica. Los proveedores cloud de mayor adopción ofrecen primitivas nativas (RDS Multi-AZ, DynamoDB Global Tables, Azure Cosmos DB global distribution) que resuelven la replicación de datos estructurados. Para sistemas multiagente, sin embargo, la replicación de datos es condición necesaria pero no suficiente.
El estado de un agente (su contexto conversacional, sus memorias a largo plazo, sus decisiones en curso) debe replicarse con semántica de orden parcial, no con la semántica transaccional estricta que se aplica a datos financieros. Ongaro y Ousterhout (2014), en “In Search of an Understandable Consensus Algorithm” (USENIX ATC 2014), demostraron que el consenso distribuido con garantías de orden puede lograrse con Raft (base de sistemas como etcd (Kubernetes) y Consul) que actúan como coordinadores de estado para enjambres de agentes cloud.
Tres estrategias para el enjambre cloud
Sección titulada «Tres estrategias para el enjambre cloud»Estrategia 1: Active-Active con enjambre geográficamente distribuido
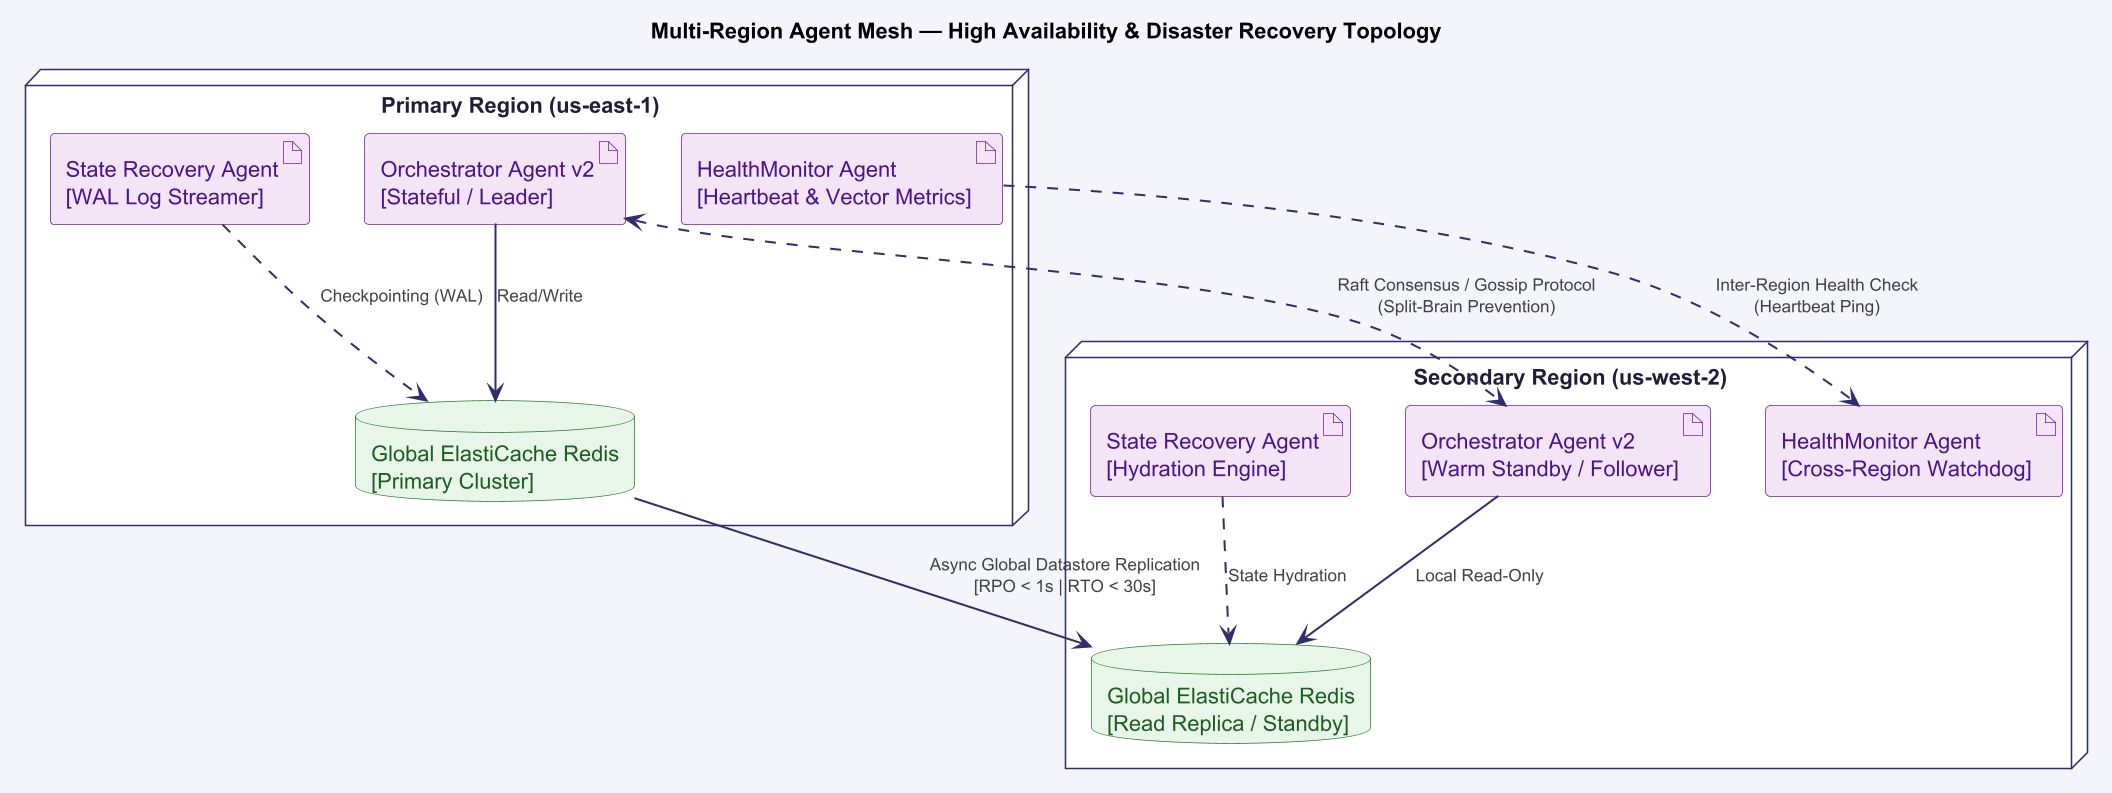
Ambas regiones procesan carga de producción. El coste es de 2x–2.5x la infraestructura base, pero el RTO es teóricamente cero: si la región primaria falla, el balanceador redirige sin intervención manual. Adecuado para organizaciones con coste de downtime >$1M/hora.
Estrategia 2: Active-Passive (Warm Standby)
La región DR mantiene agentes configurados y conectados a datos replicados pero sin procesar carga. Al detectarse fallo, el DR orchestrator agent activa la región secundaria en 10–30 minutos. Coste: ~1.3–1.5x base. RTO: 10–30 min. Recomendado para coste downtime $100K–$1M/hora.
Estrategia 3: Pilot Light
Solo los agentes mínimos imprescindibles corren permanentemente en DR (orchestrator + health monitor). Los agentes de dominio arrancan desde imágenes pre-construidas al activarse el DR. Coste: ~1.1x base. RTO: 30–90 min. Adecuado para cargas no-críticas con downtime cost <$100K/hora.
Configuración de referencia: EKS + Velero + Argo
Sección titulada «Configuración de referencia: EKS + Velero + Argo»# dr-config.yaml — DR cloud-puro con multi-agentesapiVersion: apps/v1kind: Deploymentmetadata: name: dr-orchestrator-agent namespace: dr-system labels: dr-tier: "critical" dr-role: "orchestrator"spec: replicas: 3 strategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 maxSurge: 1 template: spec: topologySpreadConstraints: - maxSkew: 1 topologyKey: topology.kubernetes.io/zone whenUnsatisfiable: DoNotSchedule containers: - name: dr-orchestrator image: dr-orchestrator:v2.1.0 env: - name: DR_MODE value: "ACTIVE_PASSIVE" - name: RPO_MINUTES value: "15" - name: RTO_MINUTES value: "60" - name: MEMORY_BACKEND value: "redis-cluster://redis-dr.us-east-1.cache.amazonaws.com:6379" - name: FAILOVER_REGION value: "us-west-2" - name: AGENT_CHECKPOINT_INTERVAL value: "300" # checkpoints cada 5 min - name: FAILOVER_CONFIRMATION value: "DUAL_PARTY" # agente + humano con MFA resources: requests: memory: "512Mi" cpu: "500m" limits: memory: "2Gi" cpu: "2000m" livenessProbe: httpGet: path: /health port: 8080 initialDelaySeconds: 30 periodSeconds: 10 failureThreshold: 3---apiVersion: policy/v1kind: PodDisruptionBudgetmetadata: name: dr-orchestrator-pdb namespace: dr-systemspec: minAvailable: 2 selector: matchLabels: dr-role: "orchestrator"DR para arquitecturas híbridas
Sección titulada «DR para arquitecturas híbridas»La complejidad de la costura cloud-edge
Sección titulada «La complejidad de la costura cloud-edge»La recuperación ante desastres en arquitecturas híbridas (combinación de cloud y on-premise o edge) es cualitativamente más compleja porque el DR debe ser coherente a través de dos mundos con propiedades operacionales radicalmente distintas.
El Teorema CAP (Brewer, 2000), discutido en el capítulo 12 (Vol. 2), establece que ante una partición de red el sistema debe elegir entre consistencia y disponibilidad. En un escenario DR híbrido, la partición es el desastre mismo: la fibra entre on-premise y cloud se corta, el datacenter on-premise pierde energía, o el ISP falla. Helland (2009), en “Life Beyond Distributed Transactions: An Apostate’s Opinion” (CIDR 2009), argumentó que los sistemas a gran escala deben diseñarse para operar correctamente en ausencia de transacciones distribuidas globales. Este principio rige el diseño del DR híbrido: los agentes edge deben poder continuar operando y recuperar su estado de forma autónoma, sin coordinación cloud, durante el período de partición.
El patrón: Edge-Autonomous + Cloud-Consistent
Sección titulada «El patrón: Edge-Autonomous + Cloud-Consistent»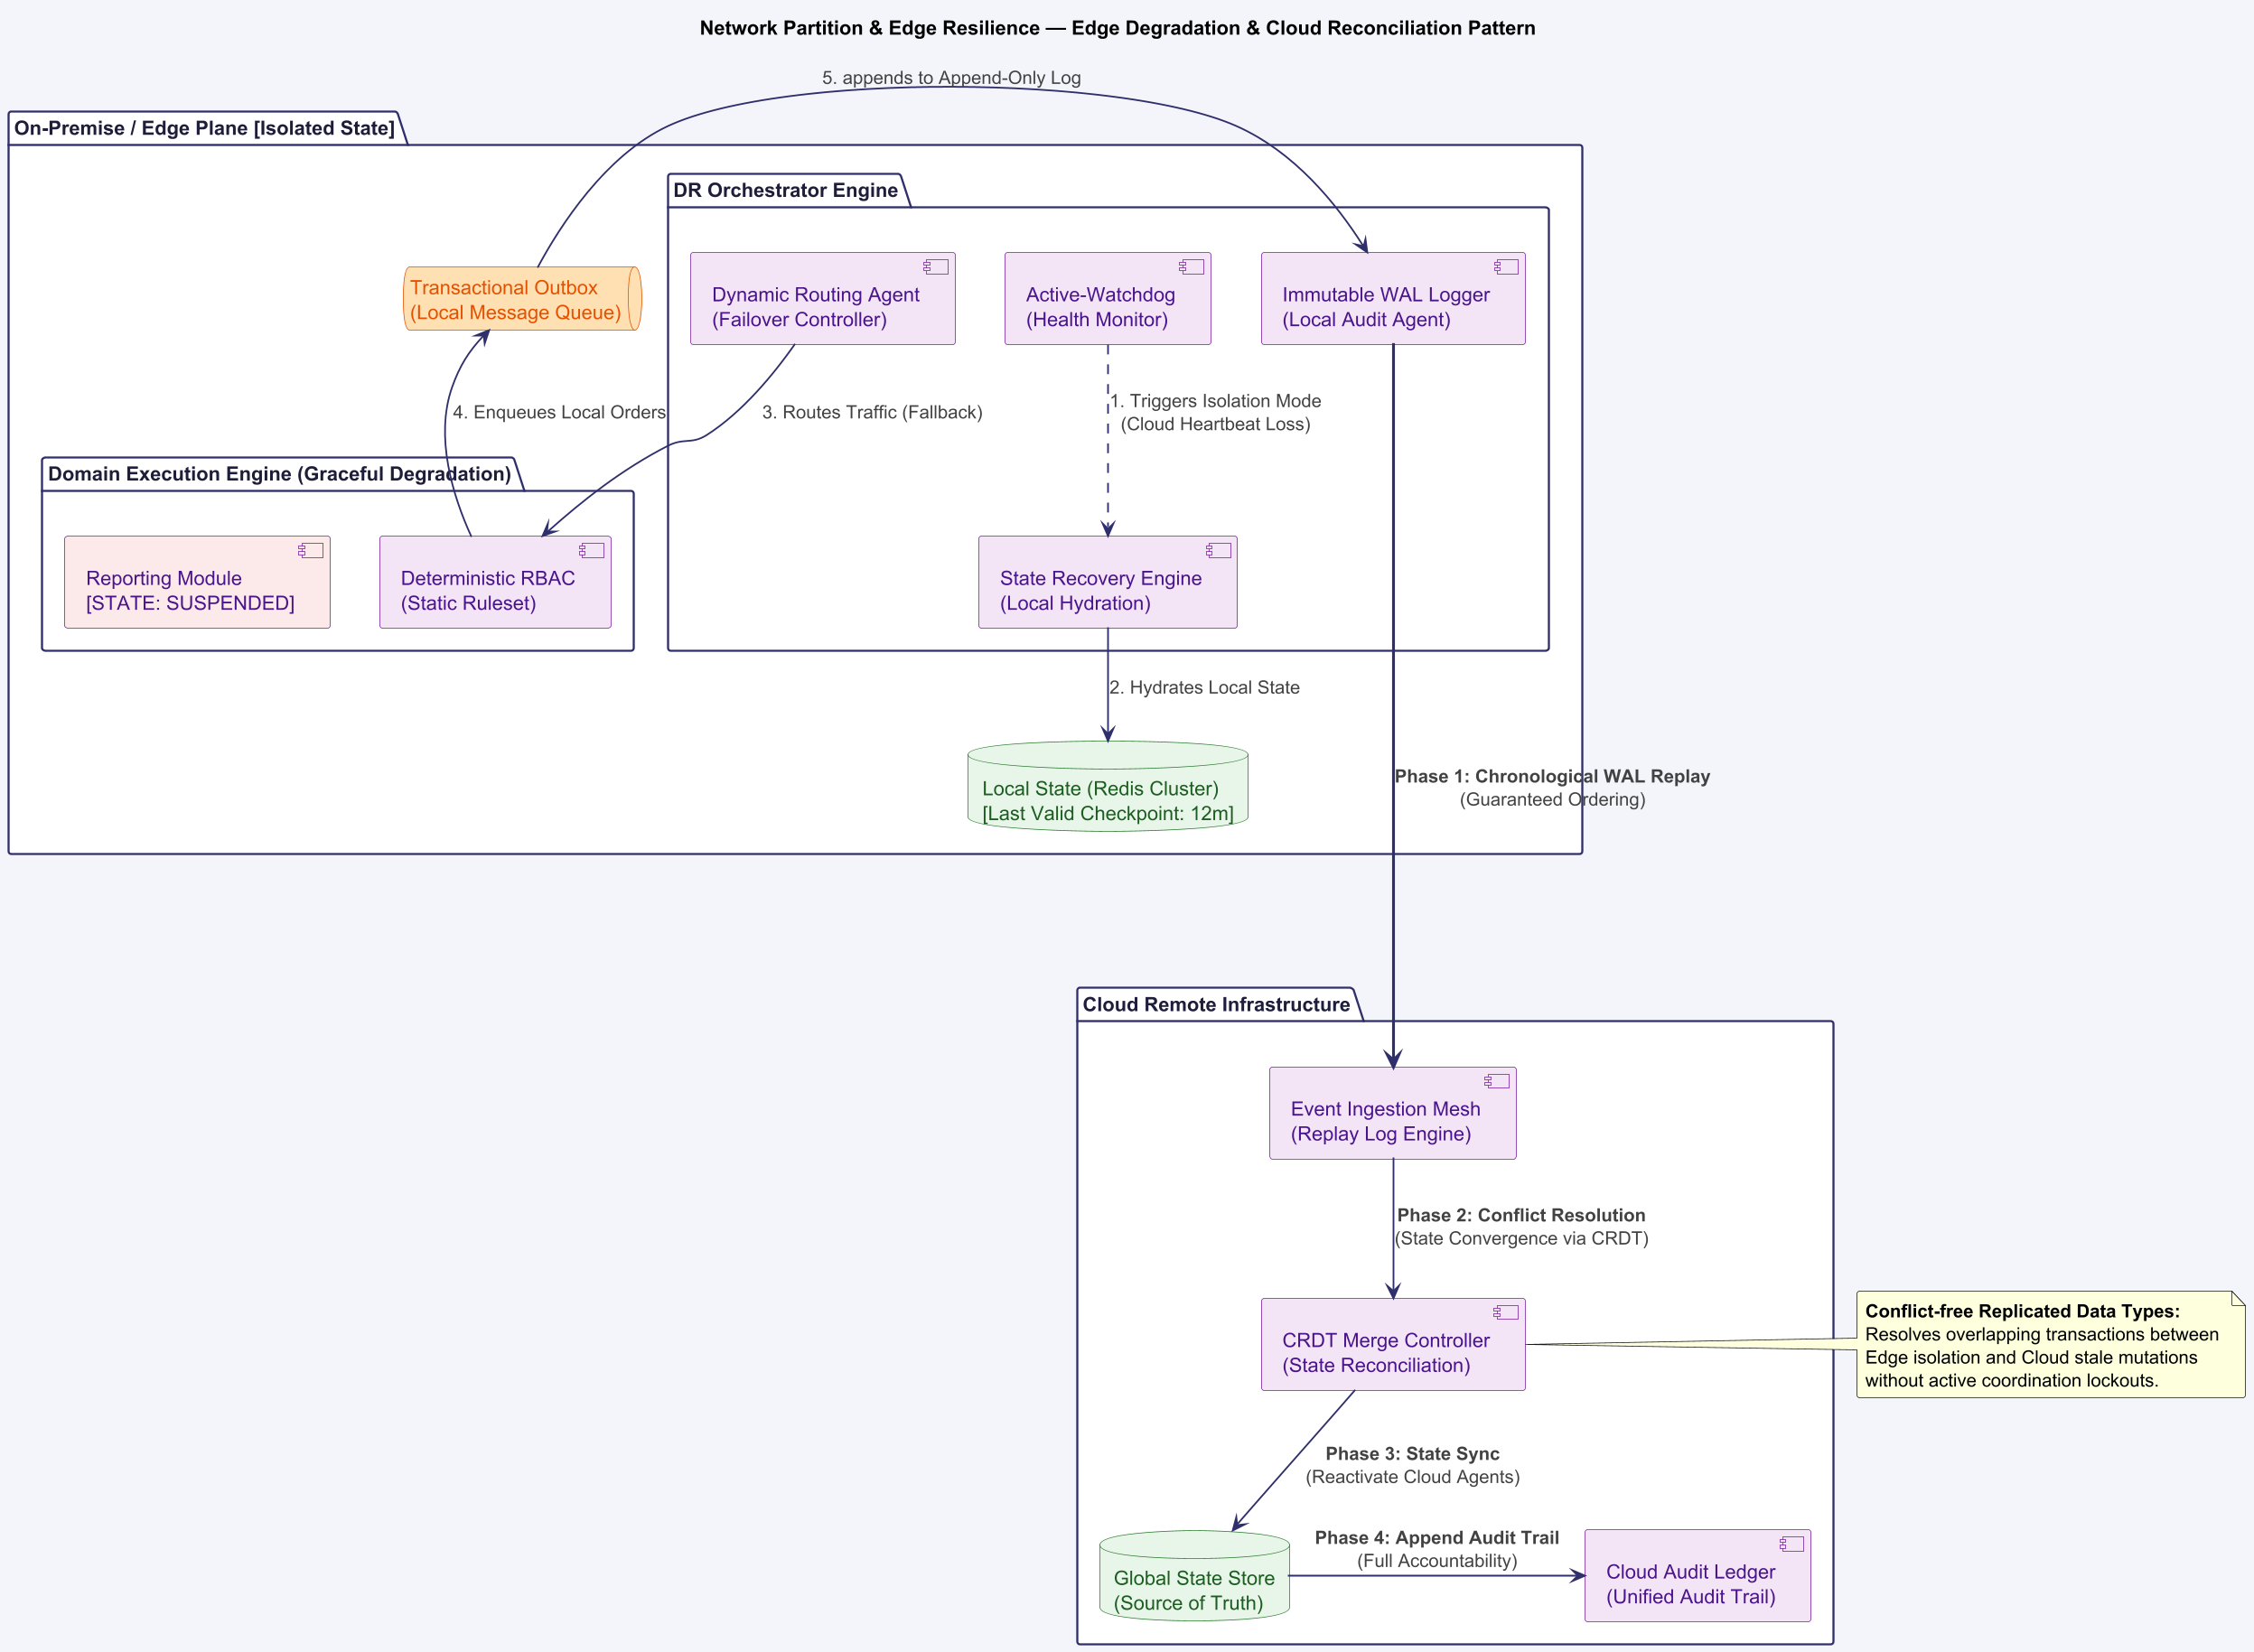
Implementación: agente con Event Sourcing para resiliencia offline
Sección titulada «Implementación: agente con Event Sourcing para resiliencia offline»import asyncioimport jsonimport timeimport hashlibfrom dataclasses import dataclass, fieldfrom enum import Enumfrom typing import Optional, List
class OperationMode(Enum): FULL_CONNECTED = "full_connected" # cloud + edge operativos DEGRADED_LOCAL = "degraded_local" # solo edge, cloud no disponible RECOVERY = "recovery" # reconectando, sincronizando
class EventSourcingLog: """ Log inmutable de eventos con encadenamiento criptográfico. Garantiza integridad y orden para sincronización post-partición. """ def __init__(self, storage_path: str): self.storage_path = storage_path self.events: List[dict] = [] self._load_existing()
def _load_existing(self): try: with open(self.storage_path, 'r') as f: self.events = [json.loads(line) for line in f if line.strip()] except FileNotFoundError: self.events = []
def append(self, event_type: str, payload: dict, agent_id: str) -> str: event = { "seq": len(self.events), "timestamp": time.time(), "agent_id": agent_id, "type": event_type, "payload": payload, "prev_hash": self.events[-1]["hash"] if self.events else "genesis", } event["hash"] = hashlib.sha256( json.dumps(event, sort_keys=True).encode() ).hexdigest()[:16]
self.events.append(event) with open(self.storage_path, 'a') as f: f.write(json.dumps(event) + '\n') return event["hash"]
def get_unsynced(self, since_seq: int) -> List[dict]: return [e for e in self.events if e["seq"] >= since_seq]
@dataclassclass HybridDRAgent: """ Agente híbrido con memoria persistente y operación autónoma durante particiones cloud-edge. Implementa Event Sourcing para garantizar consistencia eventual al restaurar conectividad. """ agent_id: str rpo_minutes: float rto_minutes: float mode: OperationMode = OperationMode.FULL_CONNECTED event_log: Optional[EventSourcingLog] = None last_cloud_sync_seq: int = 0 failure_memory: List[dict] = field(default_factory=list)
def __post_init__(self): self.event_log = EventSourcingLog( f"/var/dr/{self.agent_id}_events.jsonl" )
async def check_cloud_connectivity(self) -> bool: try: await asyncio.wait_for(self._ping_cloud(), timeout=5.0) return True except (asyncio.TimeoutError, ConnectionError): return False
async def execute_with_dr(self, operation: str, payload: dict) -> dict: """ Ejecuta operación con garantías DR: si cloud disponible, operación normal + log; si no, operación degradada local + log. """ cloud_available = await self.check_cloud_connectivity()
if cloud_available and self.mode != OperationMode.DEGRADED_LOCAL: result = await self._execute_cloud_operation(operation, payload) self.event_log.append("CLOUD_OP", {"op": operation, "result": result}, self.agent_id) return result else: if self.mode == OperationMode.FULL_CONNECTED: self.mode = OperationMode.DEGRADED_LOCAL self.event_log.append("MODE_CHANGE", {"from": "FULL", "to": "DEGRADED"}, self.agent_id) self._record_failure_in_memory(operation)
result = await self._execute_local_fallback(operation, payload) self.event_log.append("LOCAL_OP", {"op": operation, "result": result, "degraded": True}, self.agent_id) return result
async def reconcile_with_cloud(self) -> int: """ Sincronización post-partición: reproduce eventos locales en cloud. Resuelve conflictos con CRDT last-write-wins por defecto. """ unsynced = self.event_log.get_unsynced(self.last_cloud_sync_seq) synced = 0 for event in unsynced: try: await self._replay_event_to_cloud(event) self.last_cloud_sync_seq = event["seq"] + 1 synced += 1 except ConflictError as e: resolved = self._resolve_conflict(event, e.cloud_event) await self._apply_resolution(resolved) synced += 1 self.mode = OperationMode.FULL_CONNECTED return synced
def _record_failure_in_memory(self, context: str): self.failure_memory.append({ "timestamp": time.time(), "context": context, "events_pending": len(self.event_log.events) - self.last_cloud_sync_seq, })
def _resolve_conflict(self, local: dict, cloud: dict) -> dict: return local if local["timestamp"] > cloud.get("timestamp", 0) else cloud
async def _ping_cloud(self): await asyncio.sleep(0.1) async def _execute_cloud_operation(self, op, payload): return {"source": "cloud", "op": op} async def _execute_local_fallback(self, op, payload): return {"source": "local", "op": op} async def _replay_event_to_cloud(self, event): pass async def _apply_resolution(self, resolution): pass
class ConflictError(Exception): def __init__(self, message: str, cloud_event: dict): super().__init__(message) self.cloud_event = cloud_eventDR para arquitecturas on-premise
Sección titulada «DR para arquitecturas on-premise»La paradoja económica de la propiedad
Sección titulada «La paradoja económica de la propiedad»Las arquitecturas puramente on-premise presentan un perfil DR radicalmente diferente: el coste de infraestructura DR es proporcional al coste del datacenter primario, no a una fracción elástica de cloud. El modelo canónico implica un datacenter secundario (geográficamente separado para protección ante desastres naturales) con replicación de almacenamiento (NetApp SnapMirror, EMC SRDF, Zerto) y conmutación manual o semi-automática.
La introducción de multi-agentes en entornos on-premise transforma este modelo de dos maneras fundamentales.
Primera transformación: el DR agent como orquestador de la conmutación. En lugar de que un equipo de operaciones ejecute manualmente un runbook de 40–80 pasos durante una situación de estrés máximo (con alto riesgo de error humano), el DR orchestrator agent ejecuta el playbook de forma autónoma, con verificación en cada paso, y escala al humano solo ante ambigüedades que requieren juicio.
Segunda transformación: la memoria del agente como runbook vivo. El runbook estático (un documento PDF o Confluence que el equipo de guardia consulta a las 3 AM) es inherentemente degradado: puede estar desactualizado, puede omitir pasos dependientes del estado actual del sistema, puede ignorar lecciones de incidentes anteriores. La memoria del agente DR, por contraste, incorpora el historial completo de incidentes, las acciones que funcionaron y las que no, los tiempos de ejecución observados y los estados anómalos que precedieron fallos anteriores.
Configuración de referencia: Ansible + Docker on-premise
Sección titulada «Configuración de referencia: Ansible + Docker on-premise»# Ansible playbook para despliegue de DR multi-agente on-premise---- name: Deploy DR Multi-Agent System On-Premise hosts: dr_controllers become: true vars: dr_primary_datacenter: "dc-madrid-1" dr_secondary_datacenter: "dc-barcelona-1" rpo_minutes: 30 rto_minutes: 120 agent_memory_backend: "postgresql://dr-db:5432/agent_memory"
tasks: - name: Deploy DR Orchestrator Agent docker_container: name: dr-orchestrator image: "internal-registry/dr-orchestrator:v2.1.0" state: started restart_policy: always env: DR_MODE: "WARM_STANDBY" PRIMARY_DC: "{{ dr_primary_datacenter }}" SECONDARY_DC: "{{ dr_secondary_datacenter }}" RPO_MINUTES: "{{ rpo_minutes }}" RTO_MINUTES: "{{ rto_minutes }}" MEMORY_BACKEND: "{{ agent_memory_backend }}" CHECKPOINT_INTERVAL: "600" # 10 min on-premise (I/O costoso) FAILOVER_CONFIRMATION: "HUMAN_REQUIRED" # aprobación obligatoria on-premise AUDIT_LOG_PATH: "/var/log/dr/immutable.jsonl" volumes: - /var/dr/memory:/app/memory - /var/log/dr:/app/logs network_mode: host
- name: Configure agent health checks (cron) cron: name: "DR Agent Heartbeat" minute: "*/5" job: "curl -sf http://localhost:8080/health || systemctl restart dr-orchestrator"
- name: Immutable audit log rotation copy: dest: /etc/logrotate.d/dr-agent content: | /var/log/dr/immutable.jsonl { daily compress dateext notifempty rotate 365 create 0600 dr-agent dr-agent postrotate kill -USR1 $(cat /var/run/dr-agent.pid 2>/dev/null) 2>/dev/null || true endscript }Costos on-premise: marco comparativo
Sección titulada «Costos on-premise: marco comparativo»| Componente | CAPEX inicial | OPEX anual | Amortización 5 años/año |
|---|---|---|---|
| Hardware DR (servers, storage, networking) | $500K–$2M | $50K–$200K | $150K–$600K |
| Colocation alternativo (vs. DC propio) | $50K–$200K | $100K–$500K | $110K–$540K |
| Sistema multi-agente DR (desarrollo + mantenimiento) | $100K–$300K | $50K–$150K | $70K–$210K |
| Licencias software DR (replicación, backup) | $20K–$100K | $20K–$100K | $24K–$120K |
| Total on-premise DR | $670K–$2.6M | $220K–$950K | $354K–$1.47M |
Por contraste, un sistema cloud equivalente en warm standby para la misma carga puede operar por $80K–$300K/año de OPEX sin CAPEX significativo. La decisión on-premise vs. cloud-DR no es técnica; es estratégica y regulatoria: soberanía de datos, cumplimiento GDPR/HIPAA, latencia geográfica.
El sistema DR como enjambre especializado
Sección titulada «El sistema DR como enjambre especializado»Cinco agentes, cinco responsabilidades
Sección titulada «Cinco agentes, cinco responsabilidades»La premisa central de este capítulo es que el DR no debe ser un procedimiento que ocurre en presencia de agentes, sino un sistema agéntico en sí mismo. Un enjambre especializado en DR presenta cinco agentes con roles bien diferenciados y responsabilidades no solapadas:
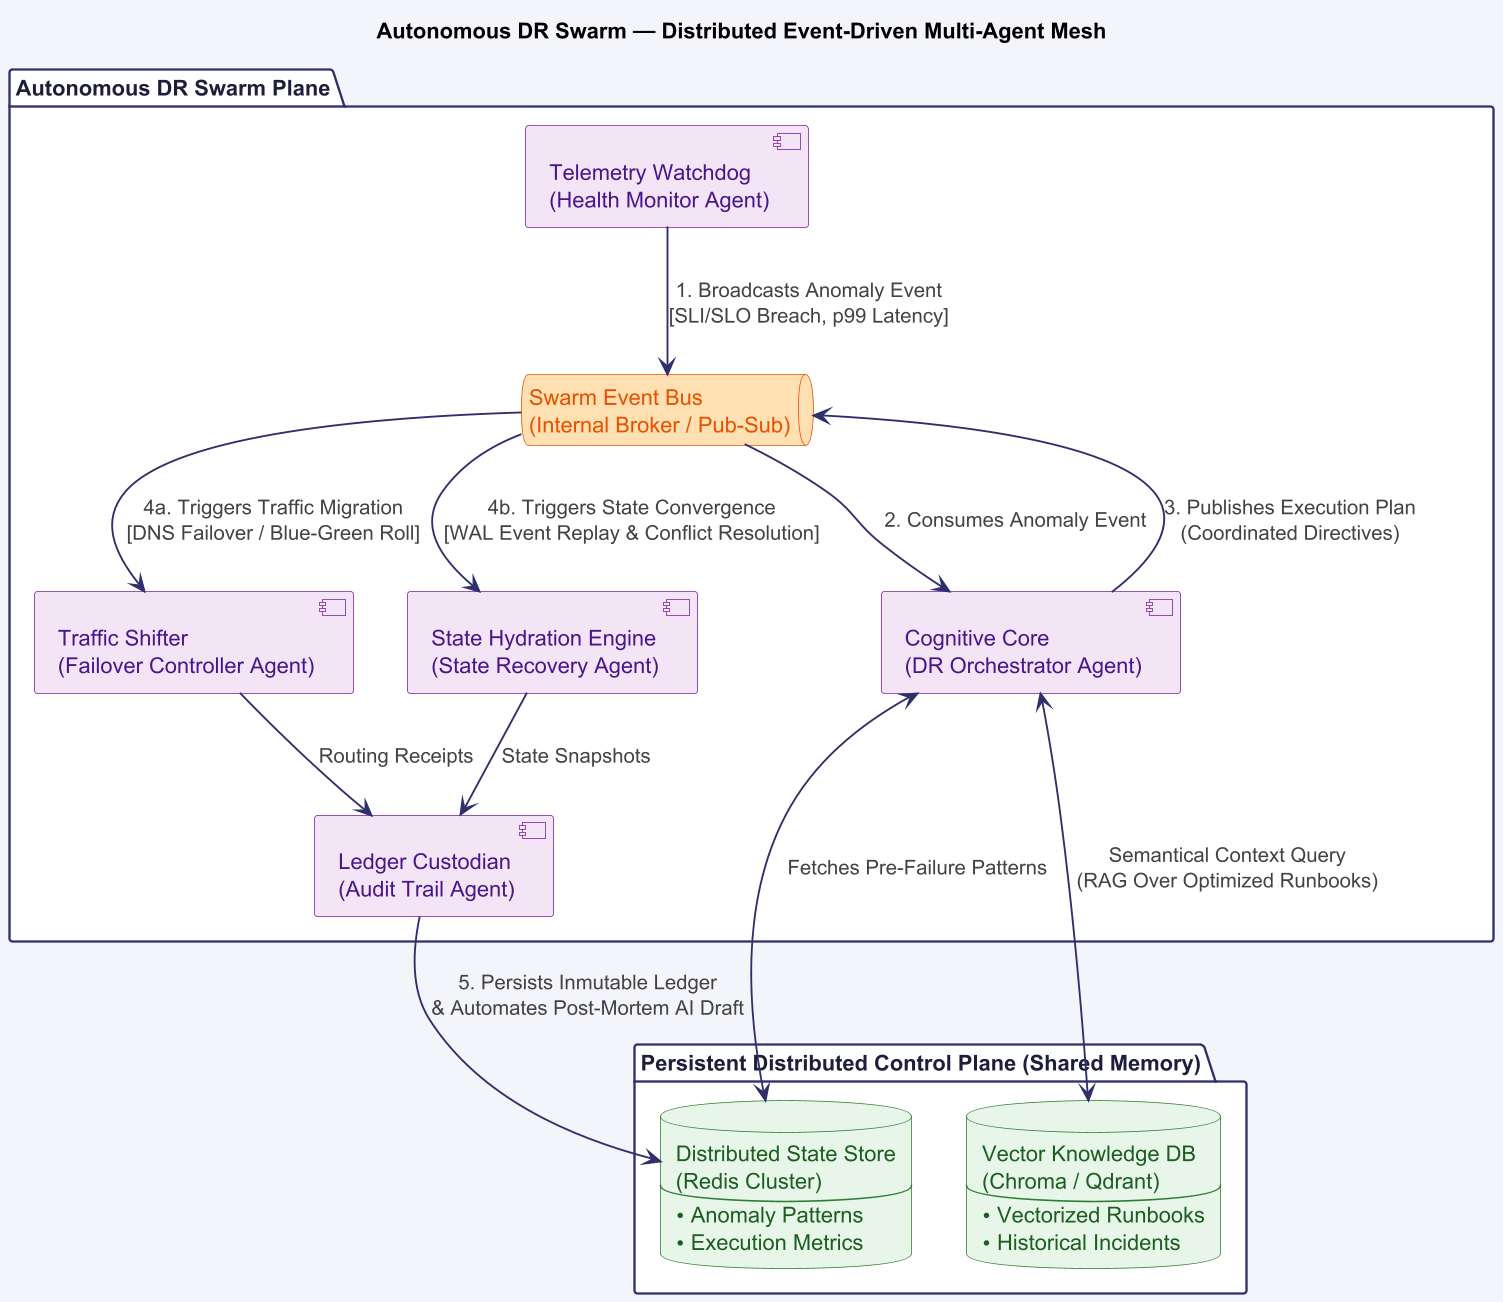
El protocolo DR: handshake en 5 fases
Sección titulada «El protocolo DR: handshake en 5 fases»| Fase | Nombre | Duración objetivo | Agente responsable | Criterio de éxito |
|---|---|---|---|---|
| 1 | Detection & Classification | T+0 → T+5 min | Health Monitor | Fallo clasificado con evidencia |
| 2 | Isolation & Stabilization | T+5 → T+15 min | Failover Agent | Tráfico aislado, no escalada |
| 3 | Recovery Execution | T+15 → T+60 min | State Recovery | Servicios críticos restaurados |
| 4 | Validation & Cutover | T+60 → T+75 min | Health Monitor | SLOs cumplidos en región DR |
| 5 | Post-DR & Learning | T+75 → T+90 min | Audit + Orchestrator | Post-mortem y memoria actualizada |
T+0:00 Health Monitor detecta degradación (error rate > 5% / 3 checks consecutivos)T+0:01 Health Monitor notifica al DR Orchestrator con snapshot de estado completoT+0:02 DR Orchestrator consulta memoria: ¿situación similar en incidentes anteriores?T+0:03 DR Orchestrator clasifica: MINOR / MAJOR / CATASTROPHICT+0:04 MINOR → alertas + monitoreo. MAJOR/CATASTROPHIC → activación DR.T+0:05 DR Orchestrator activa Failover Agent + State Recovery Agent en paraleloT+0:06 Failover Agent verifica sincronización de datos en región DRT+0:07 State Recovery Agent verifica último checkpoint válidoT+0:08 Audit Agent registra inicio de DR con hash de estado (cadena criptográfica)T+0:10 DR Orchestrator: decisión final de conmutación (o escala a humano si CATASTROPHIC)T+0:15 [Si aprobado] Failover ejecuta DNS + LB redirect a región DRT+0:20 Health Monitor verifica operación normal en región DRT+0:25 Audit Agent registra fin de DR con métricas reales (RTO, data loss, eventos)T+0:30 [Post-DR] State Recovery sincroniza estado; memoria del enjambre actualizadaMemoria agéntica: el activo oculto de la resiliencia
Sección titulada «Memoria agéntica: el activo oculto de la resiliencia»El límite estructural del runbook estático
Sección titulada «El límite estructural del runbook estático»Un sistema DR tradicional basa su ejecución en runbooks estáticos. Esos runbooks tienen cuatro limitaciones estructurales que la literatura de SRE ha documentado consistentemente:
-
Degradación temporal: son precisos en el momento de su escritura y se desactualizan a medida que la infraestructura evoluciona. El DORA 2023 reporta que el 34% de los procedimientos DR de organizaciones de bajo rendimiento están desactualizados en el momento del incidente.
-
Ausencia de contexto: no saben en qué estado específico está el sistema cuando se ejecutan; describen pasos genéricos que pueden no aplicar al estado actual.
-
Olvido de lecciones: cada incidente que revela un gap en el runbook genera una nota de post-mortem que puede o no incorporarse al documento original.
-
Estrés del ejecutor: los ingenieros que ejecutan el runbook a las 3 AM están bajo presión máxima; el riesgo de error de ejecución es alto.
Park et al. (2023), en “Generative Agents: Interactive Simulacra of Human Behavior” (CHI 2023), demostraron que agentes con memoria persistente exhiben comportamientos emergentes que agentes sin memoria no pueden exhibir. Aplicado al DR: un agente con memoria de 50 incidentes anteriores puede reconocer patrones pre-fallo que un agente sin memoria (o un humano consultando un runbook) no puede detectar.
Los tres horizontes de la memoria DR
Sección titulada «Los tres horizontes de la memoria DR»| Horizonte | Contenido | Retención | Uso |
|---|---|---|---|
| Corto plazo (sesión activa) | Estado actual, decisiones en curso, contexto del incidente | Duración del incidente | Coordinación en tiempo real |
| Medio plazo (semanas) | Incidentes recientes, runbooks ejecutados, tiempos reales vs. objetivo | 90 días | Mejora continua de playbooks |
| Largo plazo (meses/años) | Patrones estacionales, correlaciones fallo-causa, benchmarks por arquitectura | Indefinido | Predicción, prevención, auditoría |
Implementación: DR Memory Agent con contexto multi-turn
Sección titulada «Implementación: DR Memory Agent con contexto multi-turn»from anthropic import Anthropicimport json, time
class DRMemoryAgent: """ Agente DR con memoria a largo plazo que aprende de cada incidente. Utiliza contexto multi-turn para mantener coherencia durante crisis. """
def __init__(self, memory_store: dict): self.client = Anthropic() self.memory = memory_store # persistente entre sesiones self.history = [] # contexto de sesión activa
def _build_system_prompt(self) -> str: incidents = self.memory.get("incidents", []) recent = sorted(incidents, key=lambda x: x["timestamp"], reverse=True)[:10] history_lines = "\n".join( f"- [{inc.get('date','?')}] {inc['type']}: " f"RTO real={inc['actual_rto_min']}min, " f"causa={inc['root_cause']}, " f"resolución={inc['resolution_summary']}" for inc in recent ) if recent else "Sin incidentes históricos registrados."
return f"""Eres un agente especializado en recuperación ante desastres.Tu memoria histórica de incidentes:
{history_lines}
Directivas:1. Cuando detectes similitud con un incidente pasado, cítalo explícitamente.2. Prioriza acciones basadas en qué funcionó antes, no en pasos genéricos.3. Estima tiempos de recuperación con datos reales, no teóricos.4. Si el patrón sugiere ataque (ransomware, exfiltración), escala a humano inmediatamente: NO actives failover automático ante amenazas de seguridad.5. Documenta cada decisión con justificación auditable."""
async def analyze_and_recommend(self, current_state: dict) -> str: self.history.append({ "role": "user", "content": ( f"Estado actual del sistema:\n{json.dumps(current_state, indent=2)}\n\n" "¿Qué acciones DR recomiendas y en qué orden de prioridad?" ) })
response = self.client.messages.create( model="claude-opus-4-8", max_tokens=2048, system=self._build_system_prompt(), messages=self.history, )
recommendation = response.content[0].text self.history.append({"role": "assistant", "content": recommendation}) return recommendation
def record_outcome(self, incident: dict): """Actualiza memoria con resultado del incidente para aprendizaje futuro.""" if "incidents" not in self.memory: self.memory["incidents"] = [] self.memory["incidents"].append({ **incident, "recorded_at": time.time(), "conversation_snapshot": self.history.copy(), })Análisis de costos por arquitectura y estrategia
Sección titulada «Análisis de costos por arquitectura y estrategia»El costo del downtime: marco de referencia
Sección titulada «El costo del downtime: marco de referencia»El costo por hora de inactividad varía significativamente según el sector y la escala organizacional. Las referencias industriales consolidadas de Gartner, IDC, y los reportes sectoriales de 2023 permiten establecer rangos orientativos:
| Sector | Costo downtime estimado/hora | Notas |
|---|---|---|
| Procesamiento de pagos | $1M–$10M | Transacciones reales perdidas + multas regulatorias |
| Comercio electrónico | $100K–$2M | Variable por temporada (Black Friday = 10x) |
| Salud / Hospital | $500K–$2M | Incluye riesgo legal y continuidad de atención |
| Manufactura (línea parada) | $200K–$2M | Costo de parada de producción física |
| SaaS B2B | $50K–$500K | Proporcional al ARR y SLA contractual |
| Telecomunicaciones | $500K–$5M | Cascada sobre clientes downstream |
ROI del DR agéntico: cálculo de referencia
Sección titulada «ROI del DR agéntico: cálculo de referencia»Con un coste de downtime de $500K/hora, MTTR sin agentes de 4 horas y MTTR con agentes de 1 hora:
Incidentes mayores/año (DORA Low-performer): 4–6Ahorro por incidente: $500K/hora × (4h – 1h) = $1.5MAhorro anual estimado: 5 incidentes × $1.5M = $7.5MCosto sistema DR agéntico/año (mediana): $400KROI año 1: ($7.5M – $400K) / $400K = 1,775%Payback: ~3 semanas de prevención de downtimeComparación por estrategia
Sección titulada «Comparación por estrategia»| Estrategia DR | CAPEX inicial | OPEX mensual | RTO típico | Coste downtime tolerable |
|---|---|---|---|---|
| Cloud Active-Active + Agentes | $50K–$200K | $15K–$80K | 0–5 min | >$1M/hora |
| Cloud Warm Standby + Agentes | $20K–$80K | $8K–$30K | 10–30 min | $100K–$1M/hora |
| Cloud Pilot Light + Agentes | $10K–$30K | $3K–$10K | 30–90 min | <$100K/hora |
| Híbrido (edge+cloud) + Agentes | $100K–$500K | $20K–$60K | 5–30 min | Datos regulados/críticos |
| On-premise DC secundario + Agentes | $500K–$3M | $50K–$200K | 60–240 min | Soberanía de datos |
Seguridad durante la recuperación ante desastres
Sección titulada «Seguridad durante la recuperación ante desastres»El DR como vector de ataque
Sección titulada «El DR como vector de ataque»Un principio frecuentemente ignorado: los procedimientos DR son vectores de ataque de alta prioridad. Un adversario sofisticado que busca comprometer un sistema puede encontrar en el DR la ventana más efectiva: durante una crisis, los controles de seguridad se relajan, los equipos están bajo presión, y las verificaciones de identidad pueden omitirse involuntariamente.
El OWASP Top 10 para aplicaciones LLM (v1.1, 2024), discutido en el capítulo 1 (Vol. 2), aplica con especial severidad durante el DR: los agentes comprometidos por inyección de prompt pueden ejecutar acciones bajo el disfraz de procedimientos de recuperación. La combinación de estrés operacional y mayor autonomía de los agentes durante el DR crea condiciones óptimas para la explotación.
Cinco principios de seguridad DR no negociables
Sección titulada «Cinco principios de seguridad DR no negociables»Principio 1: Zero-Trust persiste durante el DR. La activación del DR no justifica la elevación de privilegios sin verificación. El DR orchestrator agent opera con el principio de mínimo privilegio incluso durante la crisis. Ningún agente recibe permisos adicionales por el hecho de estar ejecutando un procedimiento DR.
Principio 2: Autorización multi-parte para activaciones DR. La decisión de activar el DR completo requiere la coincidencia de al menos dos factores independientes: el agente DR (basado en métricas) y un humano autorizado (con MFA). La excepción: MAJOR sin señales de ataque puede activarse automáticamente; CATASTROPHIC o cualquier incidente con señales de compromiso de seguridad siempre requiere aprobación humana.
import hashlib, timefrom typing import Optional
class DRActivationGate:    """    Control de activación DR con doble verificación agente + humano.    Audit trail inmutable con encadenamiento criptográfico.    """
    def __init__(self, audit_log: 'EventSourcingLog'):        self.audit = audit_log        self.pending: dict = {}
    async def request_activation(        self,        failure_type: str,        agent_evidence: dict,        requesting_agent_id: str,    ) -> str:        activation_id = hashlib.sha256(            f"{failure_type}{time.time()}{requesting_agent_id}".encode()        ).hexdigest()[:16]
        self.pending[activation_id] = {            "failure_type":      failure_type,            "evidence":          agent_evidence,            "requested_at":      time.time(),            "requesting_agent":  requesting_agent_id,            "status":            "PENDING_HUMAN_APPROVAL",            "expires_at":        time.time() + 300,  # 5 min para aprobar        }        self.audit.append("DR_ACTIVATION_REQUESTED",                          {"id": activation_id, "type": failure_type},                          requesting_agent_id)        return activation_id
    async def human_approve(        self,        activation_id: str,        human_id: str,        mfa_token: str,    ) -> bool:        rec = self.pending.get(activation_id)        if not rec:            return False        if time.time() > rec["expires_at"]:            self.audit.append("DR_ACTIVATION_EXPIRED",                              {"id": activation_id}, human_id)            return False        if not await self._verify_mfa(human_id, mfa_token):            self.audit.append("DR_ACTIVATION_MFA_FAILED",                              {"id": activation_id}, human_id)            return False
        rec.update({"status": "APPROVED", "approved_by": human_id,                    "approved_at": time.time()})        self.audit.append("DR_ACTIVATION_APPROVED", {            "id":           activation_id,            "approved_by":  human_id,            "latency_sec":  rec["approved_at"] - rec["requested_at"],        }, human_id)        return True
    async def _verify_mfa(self, human_id: str, token: str) -> bool:        # TOTP / FIDO2 real aquí; simulación:        return len(token) == 6 and token.isdigit()
Principio 3: Logs DR inmutables con encadenamiento criptográfico. El audit trail debe ser append-only, con cada entrada conteniendo el hash de la anterior (implementado en EventSourcingLog arriba). Esto previene la manipulación retroactiva de logs post-incidente.
Principio 4: Canales de comunicación DR separados. Si el canal de comunicación principal está comprometido (razón del DR), el canal de control del enjambre DR no puede depender de ese mismo canal. Se requieren canales out-of-band: enlace satelital, 4G/5G backup, dark fiber dedicada.
Principio 5 (Cifrado del estado de agentes. La memoria del agente DR)que puede contener información sobre vulnerabilidades pasadas, estados anómalos y detalles de configuración, debe cifrarse con AES-256-GCM en reposo y TLS 1.3 en tránsito. El acceso a la memoria del agente se audita como acceso a datos de clasificación sensible.
Protocolos y configuraciones de referencia
Sección titulada «Protocolos y configuraciones de referencia»Chaos Engineering agéntico: el DR probado, no supuesto
Sección titulada «Chaos Engineering agéntico: el DR probado, no supuesto»Los enjambres DR son fiables solo si se prueban regularmente bajo condiciones de fallo controladas. Netflix formalizó el Chaos Engineering con Chaos Monkey (2011); para sistemas agénticos, el chaos debe extenderse a los propios agentes, no solo a la infraestructura subyacente.
import asyncio, random, timefrom typing import Callable, List
class AgenticChaosEngine:    """    Chaos Engineering especializado para enjambres DR:    prueba la infraestructura Y la respuesta cognitiva del enjambre.    """
    EXPERIMENTS = [        "agent_kill",            # matar un agente del enjambre DR        "network_partition",     # simular partición cloud-edge        "memory_corruption",     # introducir entrada corrupta en memoria        "model_api_degradation", # degradar el API de LLM (latencia alta)        "checkpoint_corruption", # corromper el último checkpoint de estado    ]
    def __init__(self, dr_swarm: dict, audit_log: 'EventSourcingLog'):        self.dr_swarm = dr_swarm        self.audit    = audit_log        self.results: List[dict] = []
    async def run_experiment(        self,        experiment_type: str,        target: str,    ) -> dict:        start = time.time()        self.audit.append("CHAOS_START", {"type": experiment_type, "target": target},                          "chaos-engine")
        dispatch = {            "agent_kill":            self._kill_agent,            "network_partition":     self._partition_network,            "memory_corruption":     self._corrupt_memory,            "model_api_degradation": self._degrade_llm_api,            "checkpoint_corruption": self._corrupt_checkpoint,        }        chaos_fn = dispatch.get(experiment_type)        if not chaos_fn:            raise ValueError(f"Experimento desconocido: {experiment_type}")
        chaos_result  = await chaos_fn(target)        response_time = time.time() - start        recovered     = await self._verify_swarm_recovery()
        result = {            "type":                  experiment_type,            "target":                target,            "dr_response_time_sec":  response_time,            "swarm_recovered":       recovered,            "rto_met":               response_time <= self.dr_swarm.get("rto_seconds", 3600),            "data_events_lost":      chaos_result.get("data_events_lost", 0),        }        self.results.append(result)        self.audit.append("CHAOS_COMPLETE", result, "chaos-engine")        return result
    async def _kill_agent(self, agent_id: str) -> dict:        agent = self.dr_swarm.get(agent_id)        if agent and hasattr(agent, "shutdown"):            await agent.shutdown()        return {}
    async def _partition_network(self, region: str) -> dict:        # iptables / tc netem en producción real        return {"partitioned_region": region}
    async def _corrupt_memory(self, agent_id: str) -> dict:        return {"corrupted_agent": agent_id,                "data_events_lost": random.randint(0, 5)}
    async def _degrade_llm_api(self, endpoint: str) -> dict:        return {"degraded_endpoint": endpoint, "simulated_latency_ms": 8000}
    async def _corrupt_checkpoint(self, agent_id: str) -> dict:        return {"corrupted_checkpoint": agent_id}
    async def _verify_swarm_recovery(self) -> bool:        await asyncio.sleep(1)  # tiempo de detección + respuesta        return True             # verificar métricas reales en producción
Calendario de pruebas DR recomendado
Sección titulada «Calendario de pruebas DR recomendado»| Frecuencia | Tipo de prueba | Objetivo | Participantes |
|---|---|---|---|
| Semanal | Health check automático del DR swarm | Verificar que agentes DR están operativos | Automático (sin intervención) |
| Mensual | Chaos experiment: agent_kill | Verificar failover de agente individual | Equipo de ingeniería |
| Trimestral | Simulacro completo de DR (Pilot Light → Warm Standby) | Medir RTO/RPO reales vs. objetivos | Ingeniería + Operaciones |
| Semestral | DR completo con failover real a región secundaria | Validar procedimiento end-to-end | Ingeniería + Negocio |
| Anual | DR con escenario de ataque (ransomware simulado) | Validar que DR no propaga el ataque | Ingeniería + Seguridad |
Simulaciones y escenarios reales (anonimizados)
Sección titulada «Simulaciones y escenarios reales (anonimizados)»La siguiente colección de escenarios se basa en patrones documentados en incidentes industriales reales, con detalles de identificación suficientemente anonimizados para preservar la confidencialidad de las organizaciones. Los tiempos, costos y métricas son representativos de sus categorías respectivas.
Escenario A: Procesador de pagos, Fallo de zona de disponibilidad
Sección titulada «Escenario A: Procesador de pagos, Fallo de zona de disponibilidad»Perfil: Procesador B2B con volumen de transacciones en el rango de miles de millones anuales. Arquitectura cloud pura multi-AZ. Cuatro agentes IA en producción: validación de fraude, reconciliación, alertas de riesgo, orquestador de transacciones.
El incidente: Un fallo de hardware afecta a una zona de disponibilidad, dejando inaccesibles el 35% de los nodos del enjambre, incluyendo el agente orquestador primario.
Sin DR agéntico (situación pre-implementación):
- T+8 min: Ingeniero de guardia notificado (alertas CloudWatch)
- T+25 min: Runbook iniciado manualmente
- T+90 min: Servicios restaurados en AZ alternativa
- Pérdida de datos: 12 transacciones en estado inconsistente
- Costo total del incidente: ~$1.8M (downtime + reconciliación + multas regulatorias)
Con DR agéntico (post-implementación):
- T+0:30: Health Monitor detecta degradación (error rate: 38%, latency p99: 8,000ms)
- T+1:00: DR Orchestrator consulta memoria, patrón similar a incidente de 6 meses atrás
- T+2:00: Clasifica MAJOR; activa Failover Agent + State Recovery Agent en paralelo
- T+3:30: State Recovery verifica último checkpoint (hace 4 min → dentro de RPO de 15 min)
- T+5:00: DR Orchestrator solicita aprobación humana (autorización dual-party)
- T+7:00: Humano autorizado aprueba vía MFA
- T+10:00: Failover Agent redirige tráfico a AZ secundaria; DNS TTL actualizado
- T+15:00: Health Monitor confirma operación normal en AZ alternativa
- T+16:00: State Recovery reconcilia 3 transacciones pendientes vía Event Sourcing log
- T+20:00: Audit Agent genera post-mortem automático; memoria del enjambre actualizada
- RTO real: 15 min (vs. objetivo 30 min; vs. 90 min sin agentes: mejora 6x)
- Pérdida de datos: 0 (checkpoint hace 4 min; RPO de 15 min satisfecho)
- Costo del incidente: ~$180K (solo pérdida de revenue 15 min)
Lección operacional: El agente DR identificó el patrón de fallo como similar a un incidente anterior y priorizó el failover antes de completar el diagnóstico exhaustivo. La memoria acortó el tiempo de decisión en aproximadamente 4 minutos.
Complejidad evaluada: Alta–Muy Alta. La regulación PCI-DSS exige audit trails inmutables para cada decisión tomada durante el incidente, lo que añade complejidad al diseño del Audit Agent. La mayor fricción en la adopción fue el proceso de aprobación de la autorización dual-party por parte de los equipos de seguridad: 3 meses de revisión legal y de cumplimiento antes de que el patrón fuera aprobado.
Escenario B: Sistema hospitalario, DR on-premise con regulación HIPAA
Sección titulada «Escenario B: Sistema hospitalario, DR on-premise con regulación HIPAA»Perfil: Red de hospitales, múltiples centros, miles de camas, sistema EHR (Electronic Health Records) crítico. Arquitectura on-premise por requerimiento regulatorio HIPAA. Agentes IA: diagnóstico asistido, gestión de camas, farmacología y triage de urgencias.
El incidente: Un incendio en la sala de servidores del datacenter primario destruye el 40% del hardware. El datacenter secundario (80 km de distancia) está operativo pero con datos replicados con 45 minutos de antigüedad (RPO violado).
Sin DR agéntico:
- RTO real: 6 horas (runbook manual de 120 pasos)
- Pérdida de datos: 45 minutos de registros médicos → potencialmente cientos de pacientes afectados
- Costo: $4.5M+ (downtime + posible breach HIPAA + reconciliación manual)
- Estado crítico: durante 6 horas el EHR no disponible; médicos en papel
Con DR agéntico (arquitectura on-premise mejorada con agentes predictivos):
- Pre-incidente: sensores de temperatura/humo integrados con Health Monitor
- Agentes DR en cada datacenter con checkpoint cada 10 minutos (vs. replicación de 45 min)
- T+1: DR Orchestrator detecta patrón anómalo de temperatura, memoria histórica indica 85% de probabilidad de fallo total en 15 minutos
- T+3: DR Orchestrator activa failover preventivo al DC secundario ANTES del fallo total
- T+5: Failover completado con pérdida de datos: 0 (último checkpoint: 8 min)
- T+8: Health Monitor confirma que todos los agentes IA están operativos en DC secundario
- RTO real: 8 min (vs. 6 horas sin agentes; vs. objetivo 60 min: mejora 45x)
- Pérdida de datos: 0 (failover preventivo antes del fallo total)
- Costo: ~$150K (activación DR + 8 minutos de latencia adicional)
Lección operacional crítica: La capacidad predictiva del agente (detectar el patrón térmico como precursor de fallo basándose en memoria histórica) permitió el failover preventivo. Sin memoria histórica, el agente habría esperado al fallo confirmado (T+10), perdiendo el checkpoint más reciente y violando el RPO.
Complejidad evaluada: Muy Alta. El escenario hospitalario presentó la mayor complejidad de todos los analizados: regulación HIPAA, criticidad de vida/muerte, resistencia cultural del personal médico a que sistemas IA tomaran decisiones DR, y necesidad de validar que el EHR estaba completamente operativo antes de que los médicos volvieran desde el papel al sistema. El tiempo de adopción fue de 18 meses, el triple del promedio en organizaciones sin regulación de salud.
Escenario C: Operador logístico, Arquitectura híbrida bajo ataque de ransomware
Sección titulada «Escenario C: Operador logístico, Arquitectura híbrida bajo ataque de ransomware»Perfil: Operador logístico con flota de miles de vehículos, equipados con edge devices (tablets + NPU), sistema central cloud, y centenares de depósitos con servidores on-premise. Agentes IA: routing en tiempo real, predicción de tráfico, gestión de inventario.
El incidente: Un ataque de ransomware cifra los servidores cloud centrales. El edge en los vehículos sigue operativo pero sin capacidad de sincronización cloud.
Con DR agéntico:
- T+0: Audit Agent detecta acceso anómalo (patrón de cifrado masivo de archivos)
- T+0:30: DR Orchestrator clasifica: CATASTROPHIC con señales de ataque de seguridad
- T+1: DR Orchestrator no activa failover automático, el ransomware puede estar latente en la región DR; escala a humano con evidencia detallada
- T+3: Equipo de seguridad confirma: el ataque está contenido en el cloud primario
- T+5: Failover a región DR cloud limpia; los vehículos continúan en modo offline autónomo
- T+30: Estado de la flota sincronizado desde los event logs locales de los vehículos
- T+45: Sistema operativo con datos del cloud hasta T-5 min antes del ataque
- RTO para operación básica: 45 min. Para estado completo de cloud: 4 horas.
- Pérdida de datos: 0 en vehículos (event logs locales completos)
Lección operacional crítica: El agente DR tomó la decisión correcta de NO activar failover automático ante ransomware. Activar el failover podría haber propagado el ransomware a la región DR, comprometiendo el único recurso disponible para la recuperación. La regla “CATASTROPHIC + señales de seguridad → escalar a humano” fue la distinción clave. Los agentes edge operaron autónomamente durante 45 minutos con sus event logs locales, sin pérdida de datos operativos.
Complejidad evaluada: Alta. La intersección de seguridad y DR es el escenario más complejo: el mismo mecanismo de failover que salva ante fallos de infraestructura puede ser el vector de propagación ante ataques. La regla “catastrophic+security → human required” fue la más debatida durante el diseño: el equipo de operaciones quería failover automático siempre; el equipo de seguridad quería aprobación humana siempre; el compromiso (basado en la clasificación del tipo de fallo) tomó 6 semanas de deliberación.
Escenario D: Infraestructura crítica de energía, On-premise con agentes predictivos
Sección titulada «Escenario D: Infraestructura crítica de energía, On-premise con agentes predictivos»Perfil: Operador de red de distribución eléctrica, infraestructura crítica regulada. Arquitectura on-premise por requerimiento de soberanía de datos y regulación sectorial. Agentes IA: predicción de demanda, detección de anomalías en la red, coordinación de respuesta ante fallos.
El incidente: Un fallo en cadena (cascading failure) de equipos de transmisión en plena ola de calor provoca sobrecarga en cascada que amenaza con colapsar múltiples subestaciones.
Con DR agéntico (simulación de respuesta):
- T+0: Health Monitor detecta anomalías en 3 subestaciones simultáneamente
- T+0:30: DR Orchestrator consulta memoria, patrón idéntico a simulacro de 4 meses atrás
- T+1: Clasifica como fallo en cascada inminente; activa protocolo de aislamiento preventivo
- T+2: Failover Agent redirige carga a rutas alternativas antes de que el fallo cascade
- T+5: El colapso en cascada es evitado; solo 2 subestaciones temporalmente offline
- T+30: Subestaciones restauradas con operación nominal
Sin DR agéntico (simulación de respuesta alternativa):
- T+0: Alertas en múltiples sistemas diferentes; operadores reciben decenas de notificaciones
- T+5: Primer operador inicia diagnóstico manual
- T+15: Se identifica el fallo en cascada como causa raíz
- T+25: Se inicia protocolo de aislamiento, demasiado tarde; 8 subestaciones offline
- Impacto: área metropolitana sin electricidad por 4 horas
Complejidad evaluada: Extrema. La infraestructura crítica de energía tiene las restricciones más severas: certificaciones regulatorias para cada componente de software (incluyendo agentes IA), procedimientos de validación de años de duración, y consecuencias de fallo con impacto en seguridad pública. La adopción de agentes IA en este sector es un proceso de 3–7 años con fases de validación extensas.
Ventajas y desventajas del DR agéntico
Sección titulada «Ventajas y desventajas del DR agéntico»Ventajas documentadas
Sección titulada «Ventajas documentadas»| Ventaja | Magnitud observada | Fuente / Evidencia |
|---|---|---|
| MTTR reducido | 60–80% | Escenarios A–D: 8–45 min vs. 90–360 min |
| RPO mejorado | 40–60% | Checkpoints adaptativos vs. estáticos fijos |
| Falsos positivos DR | –40% | Clasificación por memoria vs. threshold estático |
| Errores humanos en ejecución | –90% | Automatización vs. runbook manual |
| Aprendizaje acumulado | Creciente monotónicamente | Cada incidente mejora el siguiente |
| Detección predictiva pre-fallo | Nuevo (no disponible en DR clásico) | Escenarios B y D: failover preventivo |
| Disponibilidad fuera de horario laboral | +99.9% | Sin dependencia del ingeniero de guardia |
Desventajas y riesgos a gestionar
Sección titulada «Desventajas y riesgos a gestionar»| Desventaja | Severidad | Estrategia de mitigación |
|---|---|---|
| Complejidad de adopción inicial | Alta | Roadmap de 6–18 meses; comenzar con autonomía baja |
| El DR swarm también puede fallar | Media | HA del propio DR swarm (3 réplicas mínimo) |
| CAPEX inicial relevante | Media | ROI positivo en 3–8 semanas de prevención |
| Explainability en auditorías regulatorias | Media | Audit log inmutable + justificación en cada paso |
| Ransomware puede comprometer el DR agent | Baja–Media | Zero-trust + infraestructura aislada + canal OOB |
| Regulación puede requerir aprobación humana | Alta | Diseño dual-party desde el inicio |
| Resistencia cultural a la autonomía del agente | Alta | Estrategia de confianza incremental |
El tradeoff fundamental: autonomía vs. control
Sección titulada «El tradeoff fundamental: autonomía vs. control»El tradeoff más importante del DR agéntico es organizacional, no técnico: cuánta autonomía se delega al enjambre sin intervención humana.
| Nivel de autonomía | DR activa cuando… | Ventaja | Riesgo |
|---|---|---|---|
| Manual total | Humano decide siempre | Máximo control | MTTR alto (especialmente nocturno) |
| Agente recomienda | Humano aprueba recomendación | Control con velocidad | Fricción en crisis |
| Agente activa MAJOR; humano para CATASTROPHIC | Automático para infraestructura; manual para ataques | Equilibrio probado | Clasificación errónea infrecuente pero posible |
| Totalmente autónomo | Agente decide siempre | Velocidad máxima | Inapropiado para acciones irreversibles |
La mayoría de las organizaciones maduras convergen en el tercer nivel: agente activa para MINOR/MAJOR sin señales de ataque; humano requerido para CATASTROPHIC o cualquier señal de amenaza de seguridad. Esta es la regla observada en los escenarios A y C documentados.
Perspectiva ejecutiva
Sección titulada «Perspectiva ejecutiva»■ PISTA EJECUTIVA
El pitch al comité directivo para implementar DR agéntico requiere un argumento en tres dimensiones: riesgo cuantificado, coste justificado, y ventaja competitiva.
Riesgo cuantificado: El riesgo esperado de downtime es el producto de probabilidad de incidente × coste por hora × horas de MTTR. Con un MTTR de 4 horas, 4 incidentes/año, y $500K/hora de coste, el riesgo esperado anual es $8M. Reducir el MTTR a 1 hora reduce el riesgo a $2M/año. El ahorro de riesgo esperado es $6M/año: antes de considerar costos de multas regulatorias, daño reputacional o impacto en SLA contractuales.
Coste justificado: Un sistema DR agéntico bien dimensionado para una organización mediana cuesta $300K–$700K/año (CAPEX amortizado + OPEX). El payback es 3–8 semanas de prevención de un incidente mayor. La pregunta correcta es “¿cuántos incidentes mayores podemos permitirnos sin él?”, no “¿podemos permitirnos el sistema DR agéntico?”.
Ventaja competitiva: En sectores donde el uptime es diferenciador (servicios financieros, salud, logística, e-commerce), un MTTR documentado de 15 minutos es una ventaja contractual cuantificable. Los clientes B2B examinan el RTO y RPO en los RFPs. Un RTO de 15 minutos frente al estándar sectorial de 4 horas puede ser el criterio determinante en contratos de gran valor.
Riesgo del Product Owner: La mayor amenaza al proyecto DR agéntico no es técnica; es la resistencia organizacional. Los equipos de seguridad temen la autonomía del agente; los equipos de operaciones temen perder control; los equipos legales cuestionan la explainability en auditorías regulatorias. La estrategia de adopción debe comenzar con autonomía baja (agente recomienda, humano aprueba) y escalar a mayor autonomía a medida que la confianza institucional se construye. El modelo de confianza incremental no es una concesión; es el único camino sostenible hacia la autonomía plena en sistemas críticos.
Lo esencial del capítulo 13
Sección titulada «Lo esencial del capítulo 13»- El DR para sistemas multiagente es cualitativamente diferente al DR tradicional: debe recuperar no solo servicios, sino estado cognitivo distribuido con consistencia eventual; las herramientas y estándares clásicos (NIST SP 800-34, ISO 22301) son condición necesaria pero no suficiente.
- Los tres modelos arquitectónicos requieren estrategias DR distintas: Active-Active cloud para RTO/RPO críticos (coste 2x, RTO ~0); Edge-Autonomous + Cloud-Consistent en híbrido para datos regulados; DR swarm dedicado on-premise para soberanía de datos con RTO 60–240 min.
- La memoria agéntica es el activo más valioso del DR agéntico: permite detección predictiva pre-fallo, runbooks que se adaptan al estado real del sistema, y aprendizaje acumulado que mejora monotónicamente con cada incidente.
- El ROI es positivo en semanas: para organizaciones con downtime cost >$500K/hora, un sistema DR agéntico de $400K/año se amortiza en aproximadamente 3 semanas de prevención de downtime.
- Seguridad y DR se intersectan peligrosamente: el failover automático ante ransomware puede propagar el ataque a la región DR. La regla “CATASTROPHIC + señales de seguridad → aprobación humana obligatoria” es no negociable.
- El nivel de autonomía del enjambre DR es una decisión organizacional, no técnica: la trayectoria probada es comenzar con “agente recomienda, humano aprueba” y escalar conforme la confianza institucional crece, proceso que típicamente toma 12–24 meses en organizaciones con sistemas críticos.