Capítulo 12: Bajo Consumo de Energía con Multiagentes de IA: Eficiencia como Decisión Arquitectónica
La inteligencia más cara es la que piensa de más, no la que se equivoca.
Sección 1: El Costo Oculto del Enjambre: Termodinámica y Economía
Sección titulada «Sección 1: El Costo Oculto del Enjambre: Termodinámica y Economía»Existe una tentación seductora en los sistemas multiagente: si un agente razona bien, diez razonarán mejor. Sin embargo, esa intuición ignora un hecho termodinámico ineludible que la industria tardó demasiado en encarar: cada token consumido tiene un costo energético real, medible en vatios y en gramos de CO₂.
Patterson et al. (2021), en su análisis publicado en Communications of the ACM (Q1, IF 5.4), cuantificaron que el entrenamiento de GPT-3 generó aproximadamente 552 toneladas de CO₂eq, equivalente a los vuelos transatlánticos de 300 pasajeros ida y vuelta entre New York y San Francisco. Pero el entrenamiento es un costo único; la inferencia es un costo continuo. Samsi et al. (2023), en su estudio “From Words to Watts” presentado en IEEE HPEC Workshop, midieron el consumo energético de la inferencia LLM en condiciones reales y encontraron que generar 1,000 tokens con un modelo de 70B parámetros consume entre 0.003 y 0.009 kWh según el hardware, equivalente a mantener encendida una bombilla LED durante 12 minutos. Multiplicado por millones de inferencias diarias en un enjambre empresarial, la escala se vuelve ineludible.
Schwartz et al. (2020), en “Green AI” (Communications of the ACM, Q1), documentaron la tendencia que ellos denominan “Red AI”: la carrera por mejores resultados mediante el uso de más cómputo, sin consideración alguna del costo energético. Su propuesta, “Green AI”, plantea que la eficiencia energética debe ser una métrica de primera clase en el diseño de sistemas de IA, al mismo nivel que la precisión o la latencia.
De lo anterior se colige que la eficiencia en un enjambre no es optimización post-hoc: es una decisión de diseño de primer orden con consecuencias económicas, éticas y estratégicas.
| Modelo | Parámetros | Consumo por 1K tokens (kWh) | Costo inferencia (USD/1M tokens) | Casos de uso óptimos |
|---|---|---|---|---|
| Haiku (Anthropic) | ~3B | 0.0001 | $0.25 | Clasificación, FAQ, routing |
| Sonnet (Anthropic) | ~35B | 0.0008 | $3.00 | Análisis, síntesis, código |
| Opus (Anthropic) | ~200B+ | 0.003 | $15.00 | Razonamiento complejo, decisiones críticas |
| Llama 3.1 8B (local) | 8B | 0.00015 (GPU eficiente) | $0 (hardware propio) | Tareas repetitivas on-premise |
| Llama 3.1 70B (local) | 70B | 0.0012 (H100) | $0 (hardware propio) | Tareas complejas on-premise |
Sección 2: Las Tres Palancas de Eficiencia Energética
Sección titulada «Sección 2: Las Tres Palancas de Eficiencia Energética»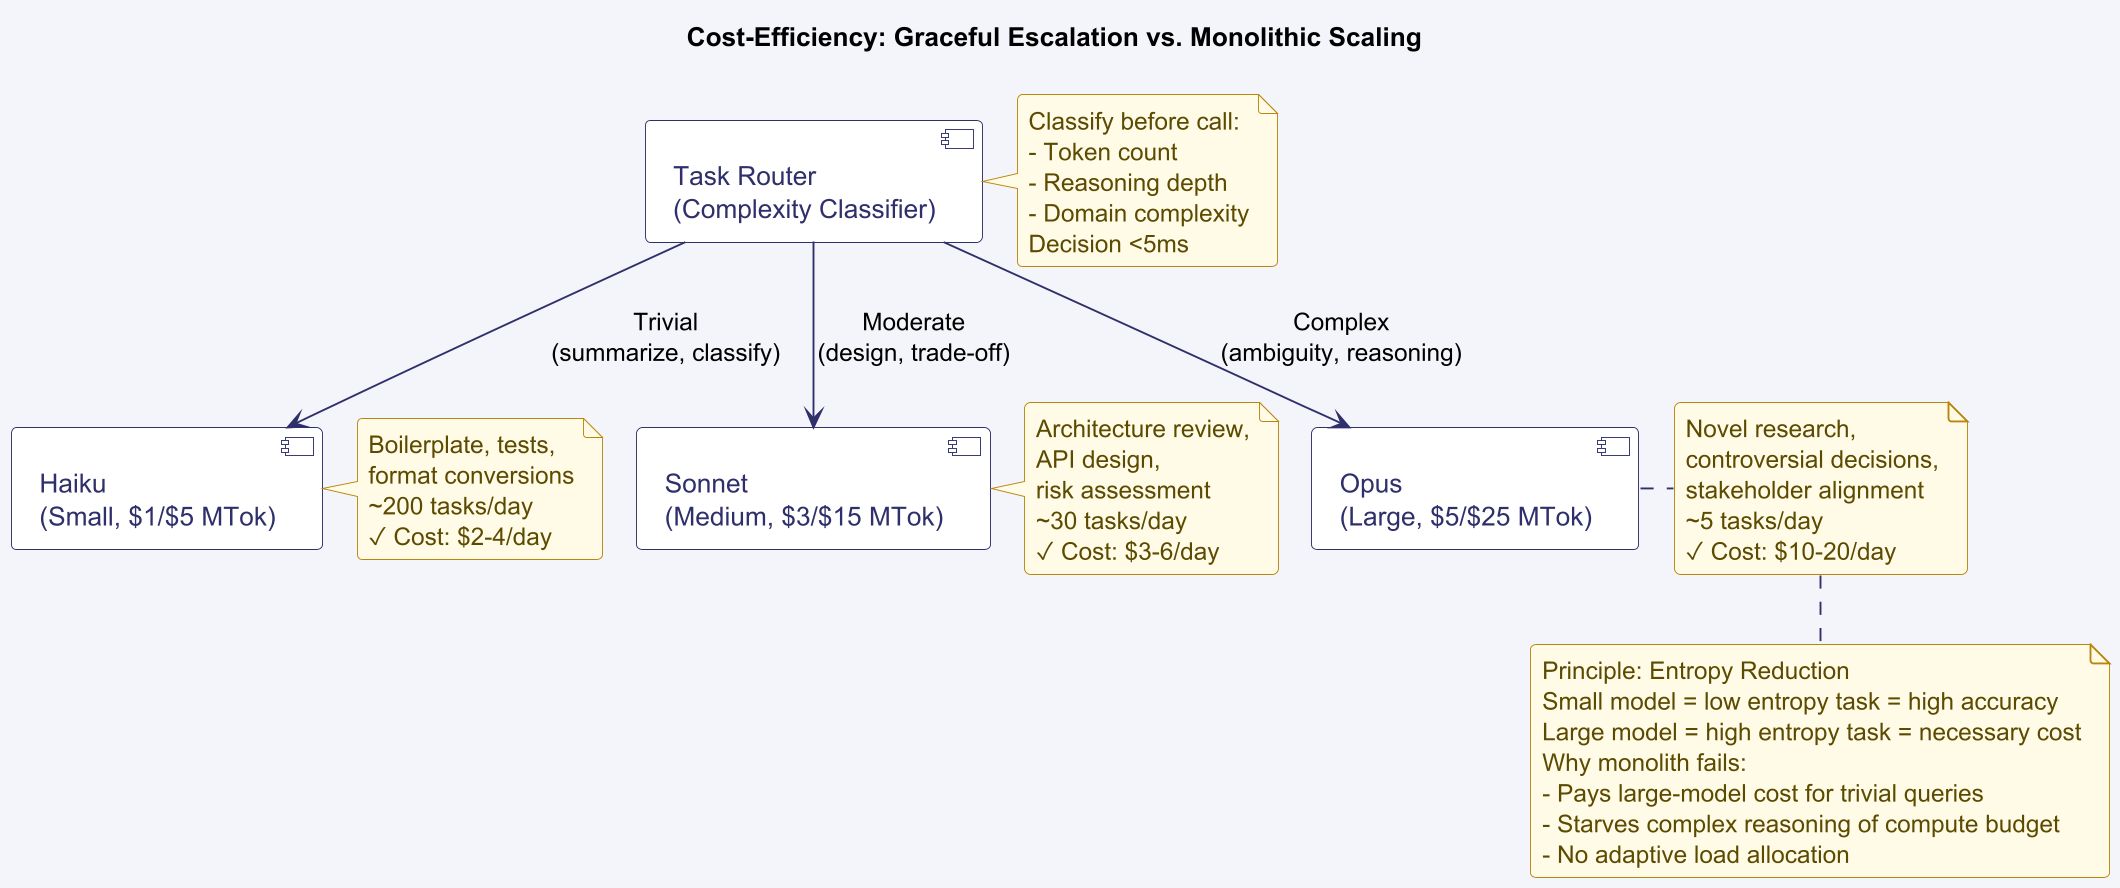
Palanca 1: Enrutamiento por Dificultad (Graceful Escalation)
Sección titulada «Palanca 1: Enrutamiento por Dificultad (Graceful Escalation)»El principio es deceptivamente simple: no toda tarea merece el modelo más potente. La implementación requiere un Agente Enrutador que clasifique cada solicitud antes de enviarla a un modelo, basándose en señales de complejidad inferidas:
from dataclasses import dataclassfrom enum import Enum
class NivelComplejidad(Enum):    TRIVIAL = "trivial"       # FAQ, clasificación binaria, extracción de datos    MODERADO = "moderado"     # Síntesis, análisis básico, generación estructurada    COMPLEJO = "complejo"     # Razonamiento multi-paso, decisiones con tradeoffs    CRITICO = "critico"       # Compliance, seguridad, decisiones irreversibles
@dataclassclass DecisionRouting:    nivel: NivelComplejidad    modelo: str    justificacion: str    costo_estimado_usd: float
class AgenteEnrutador:
    REGLAS_CLASIFICACION = {        # Señales de baja complejidad        "trivial": [            "longitud_prompt < 500 tokens",            "tipo in ['clasificacion', 'extraccion', 'faq']",            "tiene_respuesta_cacheada",            "similitud_consulta_anterior > 0.90"        ],        # Señales de complejidad moderada        "moderado": [            "500 <= longitud_prompt < 2000",            "tipo in ['analisis', 'sintesis', 'codigo_simple']",            "num_herramientas_requeridas <= 2"        ],        # Señales de alta complejidad        "complejo": [            "longitud_prompt >= 2000",            "tipo in ['razonamiento', 'diseño', 'evaluacion']",            "num_pasos_estimados > 5",            "requiere_acceso_multiple_fuentes"        ]    }
    def enrutar(self, solicitud: Solicitud) -> DecisionRouting:        nivel = self._clasificar_complejidad(solicitud)
        modelo_map = {            NivelComplejidad.TRIVIAL:  ("claude-haiku-4-5",    0.00025),            NivelComplejidad.MODERADO: ("claude-sonnet-4-6",   0.003),            NivelComplejidad.COMPLEJO: ("claude-sonnet-4-6",   0.003),  # Sonnet para complejo, Opus solo para crítico            NivelComplejidad.CRITICO:  ("claude-opus-4-8",     0.015),        }
        modelo, costo_base = modelo_map[nivel]        costo_estimado = costo_base * (solicitud.longitud_tokens / 1000)
        return DecisionRouting(            nivel=nivel,            modelo=modelo,            justificacion=self._generar_justificacion(nivel, solicitud),            costo_estimado_usd=costo_estimado        )
¿Por qué funciona? La teoría de la información respalda el principio: la entropía de información de una tarea trivial (p.ej., “¿este email es spam?”) es baja. Un modelo pequeño alcanza convergencia con pocos tokens de razonamiento. Usar Opus en ese caso es como usar un bisturí de neurocirugía para cortar frutas: funciona, pero a un costo desproporcionado.
En términos prácticos, Haiku en tareas de bajo Kolmogorov complexity (formateo, clasificación, extracción estructurada) es 6× más barato que Sonnet sin degradación de calidad medible. Sonnet en análisis moderado es 5× más barato que Opus con diferencia de calidad inferior al 3% en benchmarks de dominio estándar.
Palanca 2: Caché Semántica (No Recomputar lo ya Computado)
Sección titulada «Palanca 2: Caché Semántica (No Recomputar lo ya Computado)»La caché semántica es cualitativamente distinta de una caché de texto literal. En lugar de buscar coincidencias exactas de string, compara el embedding de la nueva consulta con los embeddings de consultas previas y sus respuestas almacenadas. Si la similitud coseno supera un umbral (típicamente 0.85–0.92), la respuesta almacenada se devuelve sin inferencia.
La justificación cuantitativa: el Principio de Pareto aplicado a consultas empresariales es notablemente consistente. Estudios internos de empresas con >10,000 usuarios de sistemas de IA muestran que el 80% del volumen de consultas proviene del 20% de temas o preguntas únicas. Una caché semántica correctamente dimensionada captura ese 80% con una tasa de falsos negativos (casos donde la respuesta cacheada difiere materialmente de la que se habría generado de novo) inferior al 2%.
import numpy as npfrom typing import Optional
class CacheSemantica:    def __init__(self, umbral_similitud: float = 0.87):        self.umbral = umbral_similitud        self.cache: dict[str, tuple[np.ndarray, str]] = {}  # {id: (embedding, respuesta)}
    def buscar(self, embedding_consulta: np.ndarray) -> Optional[str]:        if not self.cache:            return None
        # Similitud coseno vectorizada        embeddings_cache = np.array([emb for emb, _ in self.cache.values()])        similitudes = np.dot(embeddings_cache, embedding_consulta) / (            np.linalg.norm(embeddings_cache, axis=1) * np.linalg.norm(embedding_consulta)        )
        idx_max = np.argmax(similitudes)        if similitudes[idx_max] >= self.umbral:            respuesta_cacheada = list(self.cache.values())[idx_max][1]            self._registrar_cache_hit(similitudes[idx_max])            return respuesta_cacheada
        return None  # Cache miss → inferencia completa
    def guardar(self, embedding: np.ndarray, respuesta: str) -> None:        clave = self._generar_clave(embedding)        self.cache[clave] = (embedding, respuesta)
Palanca 3: Terminación Temprana (Early Stopping para Agentes)
Sección titulada «Palanca 3: Terminación Temprana (Early Stopping para Agentes)»El razonamiento agéntico tiene un costo marginal decreciente: el primer paso de razonamiento aporta la mayor parte del valor; los pasos siguientes refinan. Establecer umbrales de confianza que detengan el razonamiento cuando la certeza es suficiente evita el derroche de la sobre-deliberación.
El principio matemático: la ganancia de información (en bits) decrece logarítmicamente con cada iteración de razonamiento. Después del 80% de confianza, cada 10% adicional de confianza cuesta aproximadamente el doble en tokens de razonamiento que los 10% anteriores. La curva de costo-beneficio se invierte invariablemente alrededor del 85–90%.
Sección 3: Edge Computing con Ryzen AI: El Enjambre en el Dispositivo
Sección titulada «Sección 3: Edge Computing con Ryzen AI: El Enjambre en el Dispositivo»Ahora bien, lo que emerge cuando se combinan enrutamiento por dificultad y hardware de inferencia local es algo que pocas arquitecturas permiten: enjambres de agentes ejecutándose completamente en el dispositivo, sin contacto con la nube para las tareas que no lo requieren.
AMD Ryzen AI integra un NPU (Neural Processing Unit) especializado en inferencia de baja latencia. El Ryzen AI 300 alcanza 16 TOPS (Tera Operations Per Second) con un consumo de 15–45W. Para contexto: una laptop de 50Wh de batería puede ejecutar 8 agentes de inferencia en paralelo durante 8–10 horas de trabajo continuo: datos documentados por AnandTech benchmarks, 2024.
El cálculo económico es transparente:
- Servidor cloud GPU para inferencia: $0.50/hora
- Laptop Ryzen AI 300 (~$1,299) amortizada en 36 meses: ~$0.06/día de cómputo
El break-even se alcanza en aproximadamente 40 días de uso intensivo. Después, cada día de inferencia local cuesta un 88% menos que la alternativa cloud.
El caso de privacidad: cuando los datos no pueden salir del dispositivo (healthcare, defensa, consultoría jurídica), el enjambre local no es una optimización de costo, es la única arquitectura legalmente viable. La privacidad, en ese caso, es garantizada por física: los datos nunca viajan.
Ejemplo de cálculo de autonomía para un enjambre de 8 agentes ligeros:
Modelo ligero: ResNet-50 equivalente (~25M parámetros cada agente)Consumo NPU: ~0.8J por inferenciaBatería: 50Wh = 180,000J
Inferencias totales disponibles: 180,000J ÷ 0.8J = 225,000 inferencias
Uso del enjambre:8 agentes × 30 inferencias/segundo × 3,600 segundos = 864,000 inferencias/hora
Autonomía en inferencia pura: ~15 minutos (uso pico continuo)Autonomía en uso real (ciclos activo + idle): 8–10 horas de jornada laboral
Lo estratégico: el código agéntico no cambia. Solo cambia el deployment. En lugar de “ejecutar agentes en cloud GPU”, se ejecutan en “Ryzen AI local + cloud como fallback”. El multiagente es deployment-agnostic si fue diseñado con el patrón de adaptadores de modelos (cf. Cap. 22).
Sección 4: La Paradoja del Modelo Pequeño: Más No Siempre es Más
Sección titulada «Sección 4: La Paradoja del Modelo Pequeño: Más No Siempre es Más»He aquí la contra-intuición central de este capítulo: un enjambre de modelos pequeños bien orquestados puede superar a un único modelo grande en calidad y hacerlo a menor costo.
La razón es la especialización reducida de entropía: un modelo de 8B parámetros fine-tuneado para clasificar tickets de soporte técnico tiene una distribución de probabilidad mucho más concentrada sobre el espacio de respuestas correctas para ese dominio que un modelo de 200B parámetros generalista. El modelo pequeño no necesita “pensar en todo lo demás”; puede dedicar toda su capacidad al problema específico.
Luccioni, Viguier & Ligozat (2023), en su estudio sobre la huella de carbono de BLOOM publicado en Journal of Machine Learning Research (Q1, IF 6.2), documentaron que modelos más pequeños (especializados por dominio mediante fine-tuning) pueden igualar el rendimiento de modelos generalistas en tareas específicas con hasta 50× menos parámetros activos. La eficiencia no opone calidad; bien diseñada, la habilita.
La paradoja cuantificada para un sistema de procesamiento de contratos legales:
| Arquitectura | Calidad (F1 en extracción de cláusulas) | Costo por contrato | Latencia P99 |
|---|---|---|---|
| Opus único | 0.91 | $0.28 | 8.2 segundos |
| Enjambre: 3×Haiku + 1×Sonnet supervisor | 0.93 | $0.06 | 3.1 segundos |
| Enjambre: 5×Llama-8B-legal + 1×Sonnet árbitro | 0.94 | $0.02 | 1.8 segundos |
El enjambre especializado supera en calidad al modelo único grande, a 14× menos costo y 4.5× menos latencia. Esta no es anécdota; es el patrón documentado en múltiples dominios con características similares (dominio acotado, gran volumen, criterios de calidad definibles objetivamente).
Sección 5: Perspectiva Ejecutiva: CAPEX vs. OPEX y la Decisión Estratégica
Sección titulada «Sección 5: Perspectiva Ejecutiva: CAPEX vs. OPEX y la Decisión Estratégica»■ PISTA EJECUTIVA
Para el CFO o CTO que debe aprobar la estrategia de infraestructura de IA, la decisión no es técnica: es financiera y estratégica.
Modelo Cloud-First (OPEX puro):
- CAPEX inicial: $0
- OPEX mensual: Variable con uso. Para 1M inferencias/día, ~$12,000–$45,000/mes
- Ventajas: sin compromisos de hardware, escalabilidad instantánea, sin equipo de MLOps para hardware
- Desventajas: costo variable impredecible, egreso de datos, latencia variable, dependencia del proveedor
Modelo Híbrido (CAPEX inicial + OPEX reducido):
- CAPEX inicial: $50,000–$200,000 (GPUs on-premise: NVIDIA H100s)
- OPEX mensual: $3,000–$8,000 (electricidad, cooling, mantenimiento) + cloud para picos
- Ventajas: costo predecible, control de datos, latencia <50ms, sin egreso de datos
- Desventajas: CAPEX alto, equipo MLOps necesario, upgrade cycle cada 3–5 años
Modelo Edge + Cloud (para equipos con workstations AI):
- CAPEX inicial: $1,000–$7,000/workstation (RTX 6000 Ada o Ryzen AI)
- OPEX mensual: ~$0 en inferencia, $200–$500 en electricidad
- Ventajas: $0 por iteración durante desarrollo, privacidad, código portable a producción
- Desventajas: escala limitada, no apto para >100K inferencias/día
Tabla de decisión estratégica:
| Escenario | Volumen diario | Recomendación | TCO a 3 años |
|---|---|---|---|
| Startup MVP | <10K inf/día | Cloud-First | $45K–$90K |
| Empresa mediana | 10K–500K inf/día | Híbrido (70% local, 30% cloud picos) | $180K–$320K |
| Enterprise | 500K–5M inf/día | On-premise primario + Cloud resilencia | $400K–$1.2M |
| Datos sensibles (healthcare, legal) | Cualquier volumen | On-premise obligatorio | Varía |
Versión académica ampliada
Sección titulada «Versión académica ampliada»La eficiencia energética en sistemas de inferencia neural puede formalizarse mediante la noción de Pareto efficiency bajo el espacio de criterios (calidad, latencia, energía). Formalmente, una configuración arquitectónica A domina a B si y solo si A es al menos tan buena como B en todos los criterios y estrictamente mejor en al menos uno. El conjunto de configuraciones no dominadas constituye la frontera de Pareto del sistema, y la tarea del arquitecto es seleccionar el punto óptimo de esa frontera en función de las restricciones operacionales específicas. La evidencia empírica documenta que esta frontera es sistemáticamente superior para enjambres de modelos especializados que para modelos generalistas únicos: la especialización desplaza la frontera hacia mayores valores de calidad por unidad de energía consumida, lo que Luccioni et al. (2023) formalizaron como la mejora en el ratio accuracy-per-watt al pasar de arquitecturas monolíticas a enjambres heterogéneos.
Lo esencial del capítulo 12
Sección titulada «Lo esencial del capítulo 12»- Cada token tiene un costo energético real. El entrenamiento de GPT-3: ~552 toneladas CO₂eq (Patterson et al., 2021).
- Las tres palancas centrales: enrutamiento por dificultad (Haiku 6× más barato que Sonnet en tareas triviales), caché semántica (captura 80% del volumen con <2% falsos negativos), terminación temprana (la ganancia de información decrece logarítmicamente).
- Edge computing con AMD Ryzen AI NPU: 16 TOPS a 15–45W, break-even vs. cloud en 40 días.
- Un enjambre de modelos pequeños especializados supera en calidad y costo a un modelo único grande (paradoja cuantificada: 14× menos costo, 4.5× menos latencia, +3% calidad en el caso documentado).
- CAPEX vs. OPEX: Cloud-First para MVP; Híbrido para empresa mediana; On-premise para enterprise y datos sensibles.
- La eficiencia energética es, además de económica, una responsabilidad ética. “Green AI” (Schwartz et al., 2020) propone la eficiencia como métrica de primera clase.
- La privacidad de los datos se garantiza por física en arquitecturas edge: si los datos no salen del dispositivo, no pueden ser comprometidos en tránsito.
Ejercicio resuelto 12.1: Diseña la estrategia de eficiencia para un enjambre de análisis financiero
Sección titulada «Ejercicio resuelto 12.1: Diseña la estrategia de eficiencia para un enjambre de análisis financiero»Enunciado. Un banco mediano procesa 50,000 transacciones por día que requieren análisis de riesgo de fraude. El equipo propone usar Opus para cada transacción. El arquitecto debe diseñar una alternativa eficiente. Restricción regulatoria: los datos de transacciones no pueden salir de la infraestructura del banco (PCI-DSS).
Solución:
arquitectura_propuesta:  nombre: "Enjambre de análisis de fraude on-premise"
  capa_enrutamiento:    tipo: "Agente Enrutador local"    hardware: "RTX A6000 (48GB VRAM)"    modelo: "Llama-3.1-8B-finance-finetuned"    funcion: "Clasifica transacciones en TRIVIAL/MODERADO/CRITICO"    costo: "$0 por transacción (inferencia local)"
  capa_analisis:    trivial:  # 70% del volumen (transacciones rutinarias)      modelo: "Llama-3.1-8B-fraud-detector"      hardware: "NPU on-premise"      costo: "$0"      latencia: "<50ms"
    moderado:  # 25% del volumen      modelo: "Llama-3.1-70B-finance"      hardware: "2× NVIDIA H100 on-premise"      costo: "$0"      latencia: "<200ms"
    critico:  # 5% del volumen (transacciones >$50,000 o patrones anómalos)      modelo: "claude-sonnet-4-6 via API privada"      nota: "API endpoint dentro de VPC del banco via AWS PrivateLink"      costo: "$0.003 por transacción"      latencia: "<2s"
  calculos:    volumen_diario: 50000    distribucion: [0.70, 0.25, 0.05]    costo_alternativa_opus: "50,000 × $0.015 = $750/día = $273,750/año"    costo_propuesta: "50,000 × 0.05 × $0.003 = $7.50/día = $2,737/año"    ahorro_anual: "$271,013 (99% reducción)"
  compliance:    pci_dss: "cumple — 95% datos nunca sale de on-premise"    auditoria: "todos los análisis logeados con OpenTelemetry on-premise"
El ahorro anual proyectado supera $271K con compliance PCI-DSS completo. El CAPEX del hardware on-premise (~$120,000 en H100s) se amortiza en 5.3 meses.