Capítulo 4: Programación reactiva multiagéntica de IA
Un enjambre no se programa instrucción a instrucción; se programa reacción a reacción.
De la programación imperativa a la reactiva: un cambio de paradigma no cosmético
Sección titulada «De la programación imperativa a la reactiva: un cambio de paradigma no cosmético»La programación imperativa describe cómo hacer algo, paso a paso, con flujo de control explícito y estado mutable compartido. La programación reactiva, en cambio, describe cómo responder a flujos de eventos que ocurren de forma asíncrona a lo largo del tiempo, sin que el emisor del evento conozca ni controle quién lo recibe ni cuándo. Esta distinción (ya central en sistemas distribuidos de alta disponibilidad) se vuelve fundacional en los sistemas multiagente, no solo conveniente.
Un enjambre de agentes no es una secuencia de llamadas a funciones. Es una red dinámica de reacciones: un agente detecta un estado, emite un evento, uno o más agentes observan ese evento y reaccionan según sus propias reglas, y de esa danza de emisiones y reacciones emerge el comportamiento global del sistema. Intentar modelar este tipo de sistema con el paradigma imperativo (“llama a A, espera la respuesta, llama a B, espera la respuesta, llama a C”) no es incorrecto en sentido absoluto, pero desperdicia la propiedad más valiosa de los agentes: su autonomía asíncrona. El modelo imperativo impone sincronía artificial donde la naturaleza del sistema es asíncrona.
Fundamentos formales: el modelo Actor y ReactiveX
Sección titulada «Fundamentos formales: el modelo Actor y ReactiveX»La programación reactiva multiagéntica no nace de la nada; tiene dos linajes teóricos sólidos que convergen en su diseño.
El modelo Actor (Hewitt, Bishop & Steiger, 1973) es el fundamento más directo. En este modelo, la unidad de computación es el actor: una entidad que encapsula estado, comportamiento y una cola de mensajes. Los actores se comunican exclusivamente mediante mensajes asíncronos; no comparten estado mutable. Cuando un actor recibe un mensaje, puede: (1) modificar su estado interno, (2) crear nuevos actores, o (3) enviar mensajes a otros actores. La correspondencia con los agentes de IA es casi perfecta: cada agente es un actor con estado de contexto propio, que se comunica con otros agentes mediante eventos asíncronos, sin acceso directo al estado interno de los demás.
El framework Akka (Scala/Java) implementa el modelo Actor a escala de producción y puede servir como infraestructura de orquestación para enjambres de agentes cuando la escala y el rendimiento lo requieren.
ReactiveX (rx.io): la extensión reactiva, disponible en prácticamente todos los lenguajes de programación modernos (RxJava, RxPy, RxJS, etc.), implementa el paradigma de observables y observers: los productores de eventos son observables; los consumidores son observers que se suscriben a ellos. La comunicación es desacoplada: el observable emite; el observer reacciona; ninguno conoce la implementación del otro. En el contexto agéntico, los observables son los canales de salida de cada agente; los observers son los agentes que actúan sobre esas salidas.
La combinación del modelo Actor para la estructura y ReactiveX para los operadores de composición de flujos produce la infraestructura más expresiva disponible para sistemas multiagente reactivos.
Los cuatro principios del Reactive Manifesto, en clave agéntica
Sección titulada «Los cuatro principios del Reactive Manifesto, en clave agéntica»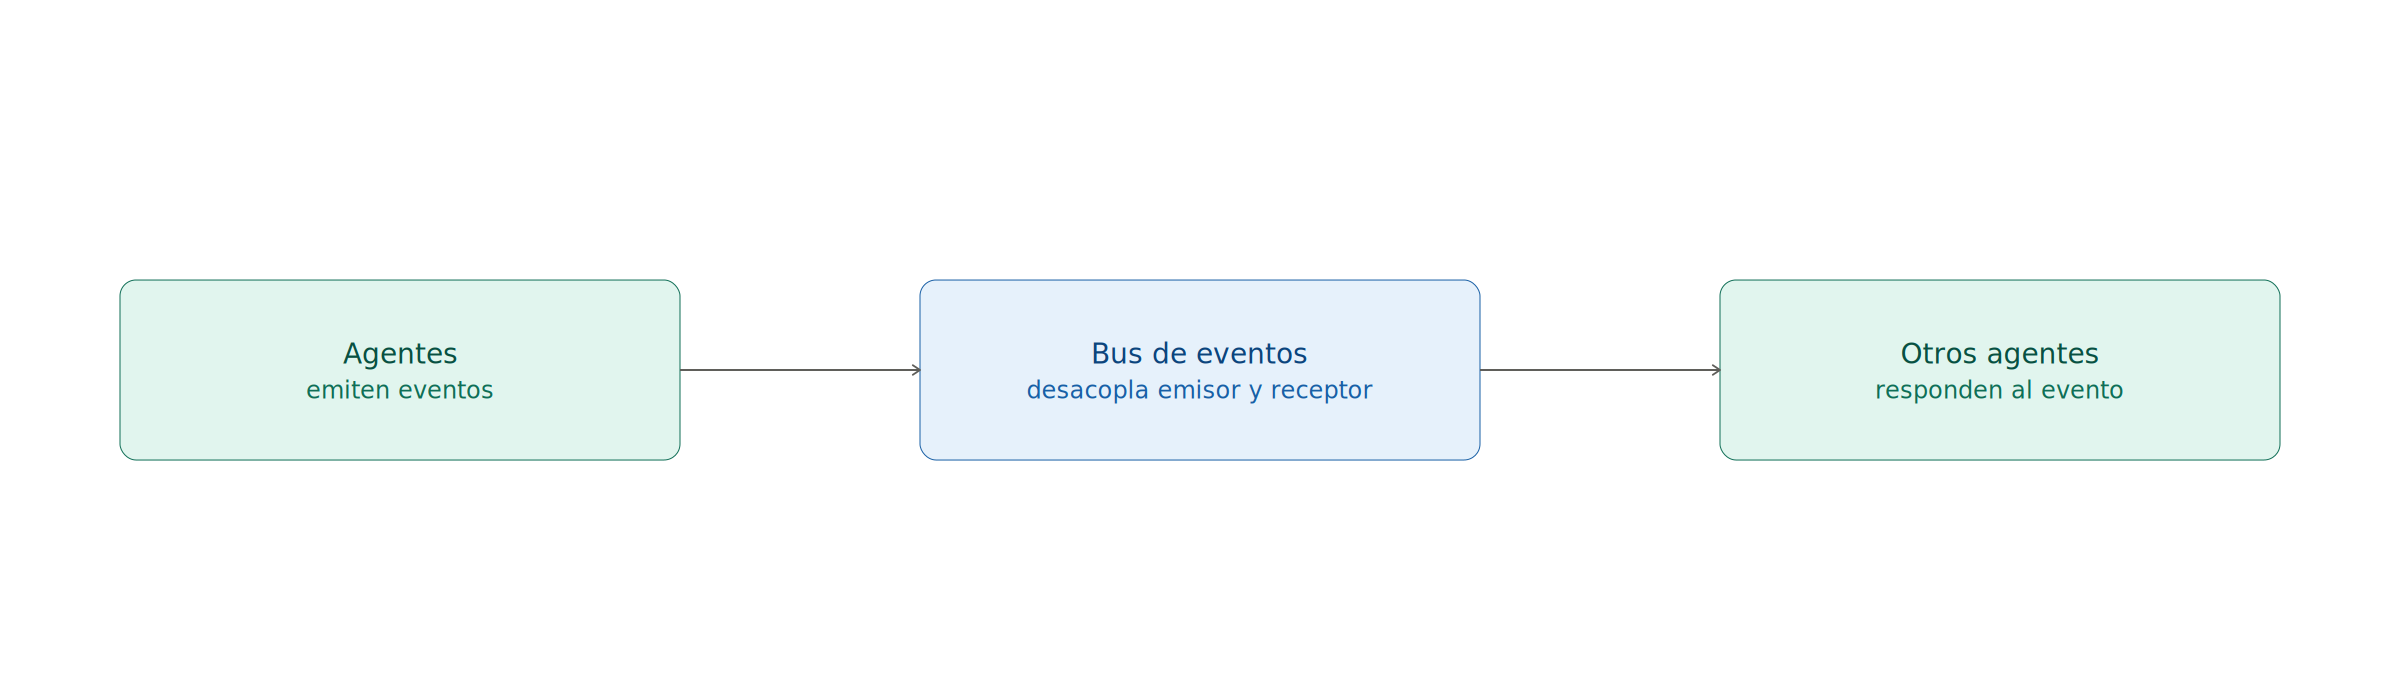
El Reactive Manifesto (Bonér et al., 2014), firmado por ingenieros de sistemas de alta disponibilidad de empresas como Twitter, LinkedIn y Netflix, define cuatro propiedades que deben satisfacer los sistemas reactivos. Cada una ilumina el diseño de enjambres agénticos con implicaciones concretas:
1. Responsivo (Responsive): el sistema responde en un tiempo definido y consistente, incluso bajo carga máxima. Para un enjambre, esto significa que ningún agente puede bloquear el flujo de eventos de otros. Un agente que tarda demasiado en responder no solo degrada su propio SLA: degrada el del sistema completo si otros agentes están esperando su salida. La solución reactiva es el timeout asíncrono: si el agente no responde en T_max, el sistema emite un evento de timeout y los agentes suscritos a ese evento actúan en consecuencia (degradando con gracia, usando una respuesta por defecto o escalando a un agente supervisor).
2. Resiliente (Resilient): el fallo de un componente no derriba el sistema completo. Para un enjambre, la resiliencia exige que el fallo de un agente sea aislado, detectado y manejado sin propagar su estado de error al resto del sistema. El patrón de circuit breaker (ampliamente utilizado en microservicios) tiene su equivalente agéntico: cuando un agente falla repetidamente, el circuit breaker lo “abre”, redirige los eventos que le estaban destinados a un agente de fallback, y espera a que el agente principal se recupere antes de “cerrar” el circuito. Relacionado directamente con el síntoma del programador cansado (cf. Vol. 3, cap. 13): un agente en degradación contextual activa el circuit breaker antes de contaminar el resultado del enjambre.
3. Elástico (Elastic): el sistema escala hacia arriba y hacia abajo según la demanda, sin sobreprovisionar recursos cuando la carga es baja ni degradar cuando es alta. Para un enjambre, la elasticidad significa que el número de instancias de cada tipo de agente se ajusta dinámicamente al volumen de eventos que ese tipo de agente debe procesar. Un enjambre que procesa 100 documentos por hora no necesita las mismas instancias de agente que uno que procesa 10,000. La elasticidad agéntica se implementa mediante colas de eventos y escalado automático de consumers.
4. Orientado a mensajes (Message-driven): toda comunicación entre componentes es asíncrona y pasa por un canal explícito (el bus de eventos). Los componentes no se llaman directamente; emiten mensajes a tópicos y suscriben a tópicos. Este desacoplamiento es la propiedad que hace posibles las otras tres: sin él, la resiliencia requiere coordinación sincrónica costosa; sin él, la elasticidad requiere rebalanceo de conexiones directas; sin él, la responsividad requiere timeouts implementados manualmente en cada punto de integración.
Implementación técnica: el bus de eventos para enjambres agénticos
Sección titulada «Implementación técnica: el bus de eventos para enjambres agénticos»► PISTA TÉCNICA
La elección del bus de eventos es una de las decisiones arquitectónicas más impactantes en el diseño de un enjambre reactivo. Las tres opciones más relevantes en 2025:
Apache Kafka: el estándar de facto para buses de eventos de alta escala. Su modelo de log distribuido y persistente garantiza que los eventos son durables, ordenados dentro de una partición y reproducibles. Para enjambres que procesan datos de negocio (donde la pérdida de un evento es inaceptable), Kafka es la opción predeterminada. Su desventaja es la complejidad operacional: requiere un cluster Zookeeper o KRaft, gestión de tópicos, configuración de retención y monitoreo dedicado.
Redis Streams: más ligero que Kafka, adecuado para enjambres de escala media (< 100,000 eventos/segundo) donde la baja latencia es más importante que la durabilidad extrema. Redis Streams soporta grupos de consumers, acknowledgment de mensajes y backpressure nativo. Para prototipos y sistemas de tamaño mediano, es frecuentemente la opción óptima por su menor overhead operacional.
Pub/Sub de Google Cloud / SNS+SQS de AWS: opciones gestionadas que eliminan el overhead operacional del bus a cambio de vendor lock-in. Adecuadas para organizaciones con fuerte compromiso con un proveedor cloud y que priorizan la velocidad de despliegue sobre la flexibilidad de infraestructura.
La siguiente tabla sintetiza los criterios de selección:
| Criterio | Apache Kafka | Redis Streams | Cloud Pub/Sub |
|---|---|---|---|
| Escala (eventos/seg) | > 1M | 10K–100K | 10K–1M+ |
| Durabilidad | Máxima (log persistente) | Alta (AOF) | Alta (gestionada) |
| Latencia | 5–20ms | 0.5–5ms | 10–50ms |
| Complejidad operacional | Alta | Media | Baja (gestionada) |
| Backpressure nativo | Sí (consumer lag) | Sí (XLEN) | Parcial |
| Replay de eventos | Sí (offset) | Sí (ID) | Limitado |
Por qué lo reactivo es la gramática natural de los agentes asíncronos
Sección titulada «Por qué lo reactivo es la gramática natural de los agentes asíncronos»La afinidad entre el paradigma reactivo y los agentes de IA no es accidental ni estética; es estructural. Los agentes son, por naturaleza técnica, entidades asíncronas y autónomas con tres propiedades que el modelo imperativo no puede gestionar eficientemente.
Primera, los agentes razonan a tiempos variables e impredecibles: un agente que procesa una pregunta compleja puede tardar 2 segundos; el mismo agente con una pregunta simple puede tardar 200 milisegundos. En el modelo imperativo sincrónico, el llamante siempre espera el tiempo del caso más lento. En el modelo reactivo, el llamante emite el evento y procesa otra cosa mientras el agente razona.
Segunda, los agentes fallan de forma independiente e impredecible: la tasa de error de un agente no es constante; depende de la dificultad del input, de la calidad del contexto, de la disponibilidad de las herramientas y de la saturación de la API del modelo. El modelo imperativo requiere manejo explícito de errores en cada punto de llamada; el modelo reactivo centraliza el manejo de errores en el bus y en los patrones de resiliencia (circuit breaker, retry con backoff exponencial, dead letter queue).
Tercera, los agentes producen múltiples salidas para un único input: un agente de análisis puede emitir un evento de resultado principal, un evento de confianza, un evento de log y un evento de métricas para un único documento procesado. El modelo imperativo requiere estructuras de retorno complejas o múltiples llamadas; el modelo reactivo acepta naturalmente múltiples eventos de un mismo origen sobre el mismo tópico o tópicos distintos.
Backpressure y control de flujo en redes de agentes
Sección titulada «Backpressure y control de flujo en redes de agentes»El backpressure (la capacidad del consumidor de un flujo de eventos de señalizar al productor que reduzca su tasa de emisión) es uno de los mecanismos más críticos y menos discutidos en el diseño de enjambres reactivos.
Sin backpressure, un enjambre donde un agente productor emite más rápido de lo que los agentes consumidores pueden procesar experimenta acumulación indefinida en la cola: los eventos se acumulan, la latencia crece, la memoria se agota y el sistema colapsa de forma desordenada. Este fallo es particularmente insidioso porque las señales externas de degradación (aumento de latencia, crecimiento de la cola) aparecen gradualmente antes del colapso, creando la ilusión de que el sistema sigue funcionando cuando en realidad está en espiral de degradación.
Los mecanismos de backpressure disponibles en las tres opciones de bus descritas:
- Kafka: el consumer lag (diferencia entre el offset del último evento emitido y el offset del último evento consumido) es el indicador natural de backpressure. Cuando el lag supera un umbral configurable, se puede reducir automáticamente la tasa de producción o escalar el número de consumers.
- Redis Streams: el comando
XLENsobre el stream proporciona el tamaño actual de la cola. Un productor que monitoreaXLENy reduce su tasa cuando supera un umbral implementa backpressure manual. Redis también soportaMAXLENpara limitar el tamaño máximo del stream. - RxPY/RxJava: el operador
throttleodebouncelimita la tasa de emisión del observable; el operadorbufferacumula eventos y los emite en lotes cuando el consumidor está listo.
Para enjambres donde el costo por evento es alto (llamadas a APIs de LLMs con latencia y costo no triviales), el backpressure no es un detalle de implementación: es un mecanismo de control de costos. Un enjambre sin backpressure que recibe un pico de tráfico puede generar en minutos un costo de API que supera el presupuesto mensual.
El riesgo de la complejidad emergente: tormentas de eventos
Sección titulada «El riesgo de la complejidad emergente: tormentas de eventos»El mismo poder que hace a los sistemas reactivos tan adecuados para enjambres agénticos introduce un riesgo específico que no existe en los sistemas imperativos: las tormentas de eventos (event storms). En un sistema reactivo donde cada evento puede disparar múltiples reacciones, y cada reacción puede emitir nuevos eventos, una secuencia mal diseñada puede producir un ciclo de retroalimentación positiva donde el número de eventos en el sistema crece exponencialmente hasta saturar el bus y los consumers.
El ejemplo canónico: el agente A emite un evento de error → el agente B lo detecta e intenta recuperar, emitiendo un evento de reintento → el agente A recibe el reintento, falla de nuevo, emite otro evento de error → el agente B vuelve a reintentar → ciclo. Sin un circuit breaker y un límite de reintentos, este ciclo puede generar miles de eventos en segundos.
Las tres contramedidas estructurales para las tormentas de eventos son:
1. Idempotencia obligatoria: todos los handlers de eventos deben ser idempotentes (procesar el mismo evento múltiples veces produce el mismo resultado que procesarlo una vez). Esto permite implementar reintentos con seguridad y rompe los ciclos donde el reintento del mismo evento produce el mismo error que desencadena otro reintento.
2. Dead Letter Queue (DLQ): una cola especial donde se envían los eventos que no pudieron ser procesados después de N reintentos. La DLQ detiene la propagación del error al enjambre principal y permite inspección y resolución manual de los eventos problemáticos sin afectar el flujo normal.
3. Límites de propagación (propagation limits): cada evento lleva un contador de “hops” que se incrementa en cada reacción que genera un nuevo evento. Cuando el contador supera un límite configurable, el evento es redirigido a la DLQ en lugar de continuar propagándose. Este mecanismo (análogo al TTL de los paquetes IP) previene las tormentas de eventos independientemente de la causa que las origine.
Observabilidad en sistemas reactivos multiagénticos
Sección titulada «Observabilidad en sistemas reactivos multiagénticos»La observabilidad (la capacidad de inferir el estado interno del sistema a partir de sus outputs externos) es significativamente más difícil en sistemas reactivos que en sistemas imperativos, precisamente porque las cadenas de causa y efecto son indirectas. En un sistema imperativo, el stack trace de un error revela la secuencia exacta de llamadas que lo produjo. En un sistema reactivo, un error puede ser el resultado de una cadena de eventos que comenzó segundos antes en un componente completamente distinto.
Los tres pilares de la observabilidad agéntica reactiva son:
Trazabilidad de correlación: cada evento lleva un correlation_id único que se propaga a todos los eventos derivados. Cuando un error aparece, el correlation_id permite reconstruir la cadena completa de eventos que lo produjo, independientemente de cuántos agentes y cuántos hops intermedios haya habido.
Métricas de bus en tiempo real: el consumer lag por tópico, el throughput de eventos por agente y la tasa de errores por tipo de evento son las métricas mínimas necesarias para detectar degradación del enjambre antes de que se manifieste como fallo visible para el usuario. Estas métricas se exponen a herramientas de monitoreo como Prometheus/Grafana o CloudWatch según el entorno.
Distributed tracing: la integración de OpenTelemetry (OTEL) en el enjambre permite correlacionar trazas de LLM (latencia de la llamada al modelo, tokens consumidos, costo estimado) con trazas de eventos (tiempo en cola, tiempo de procesamiento por agente) en un único grafo de traza distribuida. Esto es lo que transforma el enjambre de una caja negra en un sistema observable y auditable.
Perspectiva ejecutiva: consideraciones operacionales del enjambre reactivo
Sección titulada «Perspectiva ejecutiva: consideraciones operacionales del enjambre reactivo»■ PISTA EJECUTIVA
Para el directivo técnico, el paradigma reactivo introduce consideraciones operacionales que deben anticiparse antes del despliegue en producción, no después:
Costo operacional del bus: mantener un cluster Kafka, gestionar particiones, configurar retención y operar los consumers tiene un costo que no debe subestimarse. Para enjambres de escala pequeña, el bus gestionado (Cloud Pub/Sub, SQS) puede ser más económico que el autoalojado, incluso a mayor costo por evento.
Habilidades del equipo: los sistemas reactivos requieren una mentalidad distinta del desarrollo imperativo. Los ingenieros deben pensar en flujos de eventos, no en llamadas a funciones; en handlers idempotentes, no en funciones puras; en backpressure, no en timeouts síncronos. La curva de aprendizaje es real y debe incluirse en la planificación de la transformación agéntica.
Testing de sistemas reactivos: probar el comportamiento de un enjambre reactivo bajo condiciones de carga, fallo y backpressure exige herramientas específicas (pruebas de caos, generadores de carga de eventos, simuladores de latencia de agentes) que el equipo debe dominar antes de que el sistema llegue a producción.
Versión alternativa (mayor densidad académica):
La adopción del paradigma de programación reactiva como substrato arquitectónico para sistemas de inteligencia artificial multiagente representa una decisión de diseño que resuelve de forma elegante la tensión fundamental entre la naturaleza estocástica y asíncrona de los agentes de lenguaje y los requisitos de determinismo, trazabilidad y gestión de errores que imponen los sistemas de producción de alta disponibilidad. El modelo formal de comunicación mediante eventos inmutables propagados a través de un bus persistente (cuya implementación canónica en Apache Kafka ha sido validada a escalas de decenas de millones de eventos por segundo en sistemas como LinkedIn y Netflix) provee las garantías de entrega y ordenamiento que permiten razonar formalmente sobre el comportamiento del enjambre bajo condiciones adversariales, sin las cuales la observabilidad y la auditabilidad del sistema permanecen como propiedades aspiracionales no alcanzables en la práctica.
Lo esencial del capítulo 4
Sección titulada «Lo esencial del capítulo 4»- Programar enjambres es diseñar redes de reacciones a eventos, no secuencias de llamadas imperativas. La asincronía de los agentes es una propiedad estructural, no un accidente.
- El modelo Actor (Hewitt, 1973) y ReactiveX proveen los fundamentos formales; el modelo Actor es la correspondencia directa con los agentes autónomos con estado propio.
- Los cuatro principios del Reactive Manifesto aplicados: responsivo (timeout asíncrono), resiliente (circuit breaker agéntico), elástico (escalado por consumer lag), orientado a mensajes (bus desacoplado).
- Kafka (> 1M eventos/seg, máxima durabilidad), Redis Streams (10K–100K, baja latencia) y Cloud Pub/Sub (gestionado) son las tres opciones de bus con trade-offs distintos.
- El backpressure es control de costos: sin él, un pico de tráfico puede generar en minutos un costo de API que supera el presupuesto mensual.
- Las tormentas de eventos se previenen con tres mecanismos: idempotencia obligatoria, Dead Letter Queue y límites de propagación (propagation limits / event TTL).
- La observabilidad reactiva requiere tres pilares: correlation_id por cadena de eventos, métricas de bus en tiempo real y distributed tracing con OpenTelemetry.