Capítulo 12: La lucha entre agentes y multiagentes de IA: porque ser el mejor modelo no basta para vencer
Como el T-1000, ser el modelo más avanzado no garantiza la victoria si tu entorno te derrota.
La metáfora del T-1000 y su precisión técnica
Sección titulada «La metáfora del T-1000 y su precisión técnica»El autor recurre a una imagen memorable que merece ser tomada en su dimensión técnica: la inteligencia artificial del T-1000, siendo tecnológicamente superior en capacidades individuales, es vencida no por un sistema más inteligente sino por uno con mejor arquitectura sistémica. La lección trasciende la ficción: en el mundo de los agentes de IA, el mejor modelo no gana automáticamente.
Un modelo de razonamiento sobresaliente (digamos, en el percentil 99.9 de todos los benchmarks disponibles), cuando opera mal orquestado, mal alimentado de contexto, sin herramientas adecuadas y sin contención de riesgos, pierde frente a un modelo de capacidades modestas inserto en una arquitectura bien diseñada. Esta afirmación no es intuitiva, pero es empíricamente robusta y técnicamente fundamentada. El benchmark mide al modelo aislado en condiciones de laboratorio; la producción mide al sistema completo bajo condiciones reales de carga, ruido, adversarialidad e integración.
La función de calidad sistémica: la matemática del argumento
Sección titulada «La función de calidad sistémica: la matemática del argumento»La tesis central de este capítulo puede formalizarse matemáticamente, lo cual le da una solidez que la metáfora sola no proporciona. La calidad efectiva de un sistema agéntico es su mínimo limitante, no la suma de las calidades de sus componentes:
Q_sistema = min(Q_modelo, Q_arquitectura, Q_contexto, Q_herramientas, Q_contención)Donde cada Q representa la calidad normalizada en la escala [0, 1] del componente correspondiente. Si cualquiera de estos cinco factores es 0 (el contexto es nulo, las herramientas no están disponibles, la contención de riesgos es inexistente), la calidad del sistema es 0 independientemente de cuán alto sea Q_modelo.
Esta función min() tiene implicaciones contraintuitivas pero importantes. Con Q_modelo = 0.99 (modelo de última generación) y Q_arquitectura = 0.3 (arquitectura deficiente), el sistema produce Q_sistema = 0.3. Si se reemplaza el modelo por uno de Q_modelo = 0.85 pero se mejora la arquitectura a Q_arquitectura = 0.85, se obtiene Q_sistema = 0.85 (una mejora del 183% en calidad sistémica con un modelo inferior). Este resultado explica por qué invertir en arquitectura tiene un retorno muy superior al de perseguir el último modelo cuando la arquitectura está por debajo de 0.8.
La validación empírica de esta función proviene de los datos de AgentBench (Liu et al., 2024): el mismo modelo (GPT-4) produce resultados que varían entre 40% y 82% de tasa de éxito dependiendo únicamente del entorno de orquestación y las herramientas disponibles (una variación del 105% con el modelo constante).
Las cinco dimensiones que deciden la lucha sistémica
Sección titulada «Las cinco dimensiones que deciden la lucha sistémica»¿Qué determina, entonces, cuál agente o enjambre prevalece en condiciones reales? No la potencia bruta del modelo, sino una constelación de factores sistémicos cada uno de los cuales puede ser el cuello de botella:
1. Contexto. El mejor modelo sin el contexto adecuado razona perfectamente sobre la pregunta equivocada. Un modelo que recibe información incorrecta, incompleta o mal organizada produce respuestas que son internamente coherentes y externamente incorrectas (el peor tipo de error, porque pasa los filtros de plausibilidad). La calidad del contexto depende del diseño del sistema de recuperación (RAG), la gestión de la ventana de contexto y la selección de qué información es relevante para qué agente.
2. Orquestación. Un modelo de capacidades medias bien coordinado con otros especializados supera a un genio solitario sin estructura. Hong et al. (2024), en MetaGPT (ICLR 2024), demostraron que la asignación explícita de roles profesionales a agentes (analista de negocios, arquitecto, desarrollador, QA) en un sistema multi-agente aumenta la tasa de completación de software funcional en un 184% respecto de un sistema sin roles explícitos, usando el mismo modelo base.
3. Herramientas. El acceso a las herramientas correctas vía MCP o protocolos equivalentes multiplica la capacidad efectiva del sistema más que cualquier salto de versión del modelo. Un agente con acceso a búsqueda web, ejecución de código y base de datos estructurada produce resultados que ningún modelo de lenguaje puro puede replicar, independientemente de su tamaño.
4. Velocidad y costo. Un agente que responde dentro del SLA con un costo por transacción viable derrota en el mercado a uno más preciso pero 10 veces más caro o 10 veces más lento. Este factor es particularmente relevante en la competencia entre modelos: Claude Haiku 3.5 es aproximadamente 6 veces más barato que Claude Sonnet 3.5 por token; en tareas donde su calidad es suficiente, la diferencia de costo permite escalar 6 veces más con el mismo presupuesto.
5. Robustez ante el fallo. El agente que degrada con gracia ante condiciones adversas (latencia elevada de herramientas, contexto contaminado, instrucciones ambiguas) sobrevive al que colapsa o produce salidas silenciosamente incorrectas. El patrón de graceful degradation aplicado a agentes exige diseñar explícitamente el comportamiento de fallback para cada modo de fallo previsto.
Evidencia de benchmarks: por qué los rankings de modelos engañan
Sección titulada «Evidencia de benchmarks: por qué los rankings de modelos engañan»La industria de evaluación de modelos de lenguaje ha producido benchmarks de alta calidad (MMLU, HumanEval, MATH, GSM8K) que miden con precisión las capacidades del modelo aislado. El problema es la interpretación que se hace de los resultados de los benchmarks, no su calidad.
Zheng et al. (2023), en el trabajo que produjo el Chatbot Arena (NeurIPS 2023), demostraron que el ranking de modelos según preferencia humana en conversación real diverge significativamente del ranking en benchmarks estáticos: modelos que puntúan más alto en MMLU no necesariamente son preferidos por usuarios reales en tareas prácticas. La brecha se explica por factores que los benchmarks estáticos no capturan: naturalidad de la respuesta, manejo de instrucciones ambiguas, comportamiento ante preguntas fuera de distribución.
En el dominio agéntico, la divergencia es aún mayor. Jimenez et al. (2024), en SWE-bench (ICLR 2024), evaluaron la capacidad de modelos para resolver issues reales de GitHub. Los resultados fueron reveladores: el modelo con mejor puntuación en HumanEval (benchmark de generación de código) no fue el que más issues resolvió en SWE-bench. El éxito en tareas agénticas reales depende de la capacidad de planificar múltiples pasos, recuperarse de errores intermedios y mantener coherencia con el estado del sistema, capacidades que los benchmarks estáticos de generación de código no miden.
Estrategias de enrutamiento de modelos: la inteligencia de la selección
Sección titulada «Estrategias de enrutamiento de modelos: la inteligencia de la selección»► PISTA TÉCNICA
Una de las consecuencias prácticas más importantes de la función de calidad sistémica es el enrutamiento dinámico de modelos: la estrategia de usar distintos modelos para distintos tipos de tareas dentro del mismo sistema, seleccionando en tiempo de ejecución el modelo óptimo según la naturaleza de la subtarea, su nivel de riesgo y su volumen esperado.
Una taxonomía de enrutamiento práctica distingue tres categorías de tareas:
| Categoría | Criterio de clasificación | Modelo recomendado | Razón |
|---|---|---|---|
| Alta complejidad, bajo volumen | Razonamiento multistep, decisiones críticas | Modelo de mayor capacidad (Claude Opus, GPT-4o) | Calidad > costo en tareas raras |
| Complejidad media, volumen medio | Generación de contenido, análisis estándar | Modelo equilibrado (Claude Sonnet, GPT-4o-mini) | Balance calidad/costo óptimo |
| Baja complejidad, alto volumen | Clasificación, extracción, triage | Modelo pequeño y rápido (Claude Haiku, GPT-4o-mini) | Costo < calidad en tareas masivas |
El enrutador en sí puede ser un modelo pequeño entrenado o afinado para clasificar la complejidad de la tarea en milisegundos, añadiendo latencia despreciable. El ahorro de costo con esta estrategia puede superar el 60% en sistemas con alta variabilidad de complejidad de tareas, manteniendo la calidad en el percentil 90+ para las tareas que lo requieren.
El sistema vence al modelo: implicaciones para el arquitecto
Sección titulada «El sistema vence al modelo: implicaciones para el arquitecto»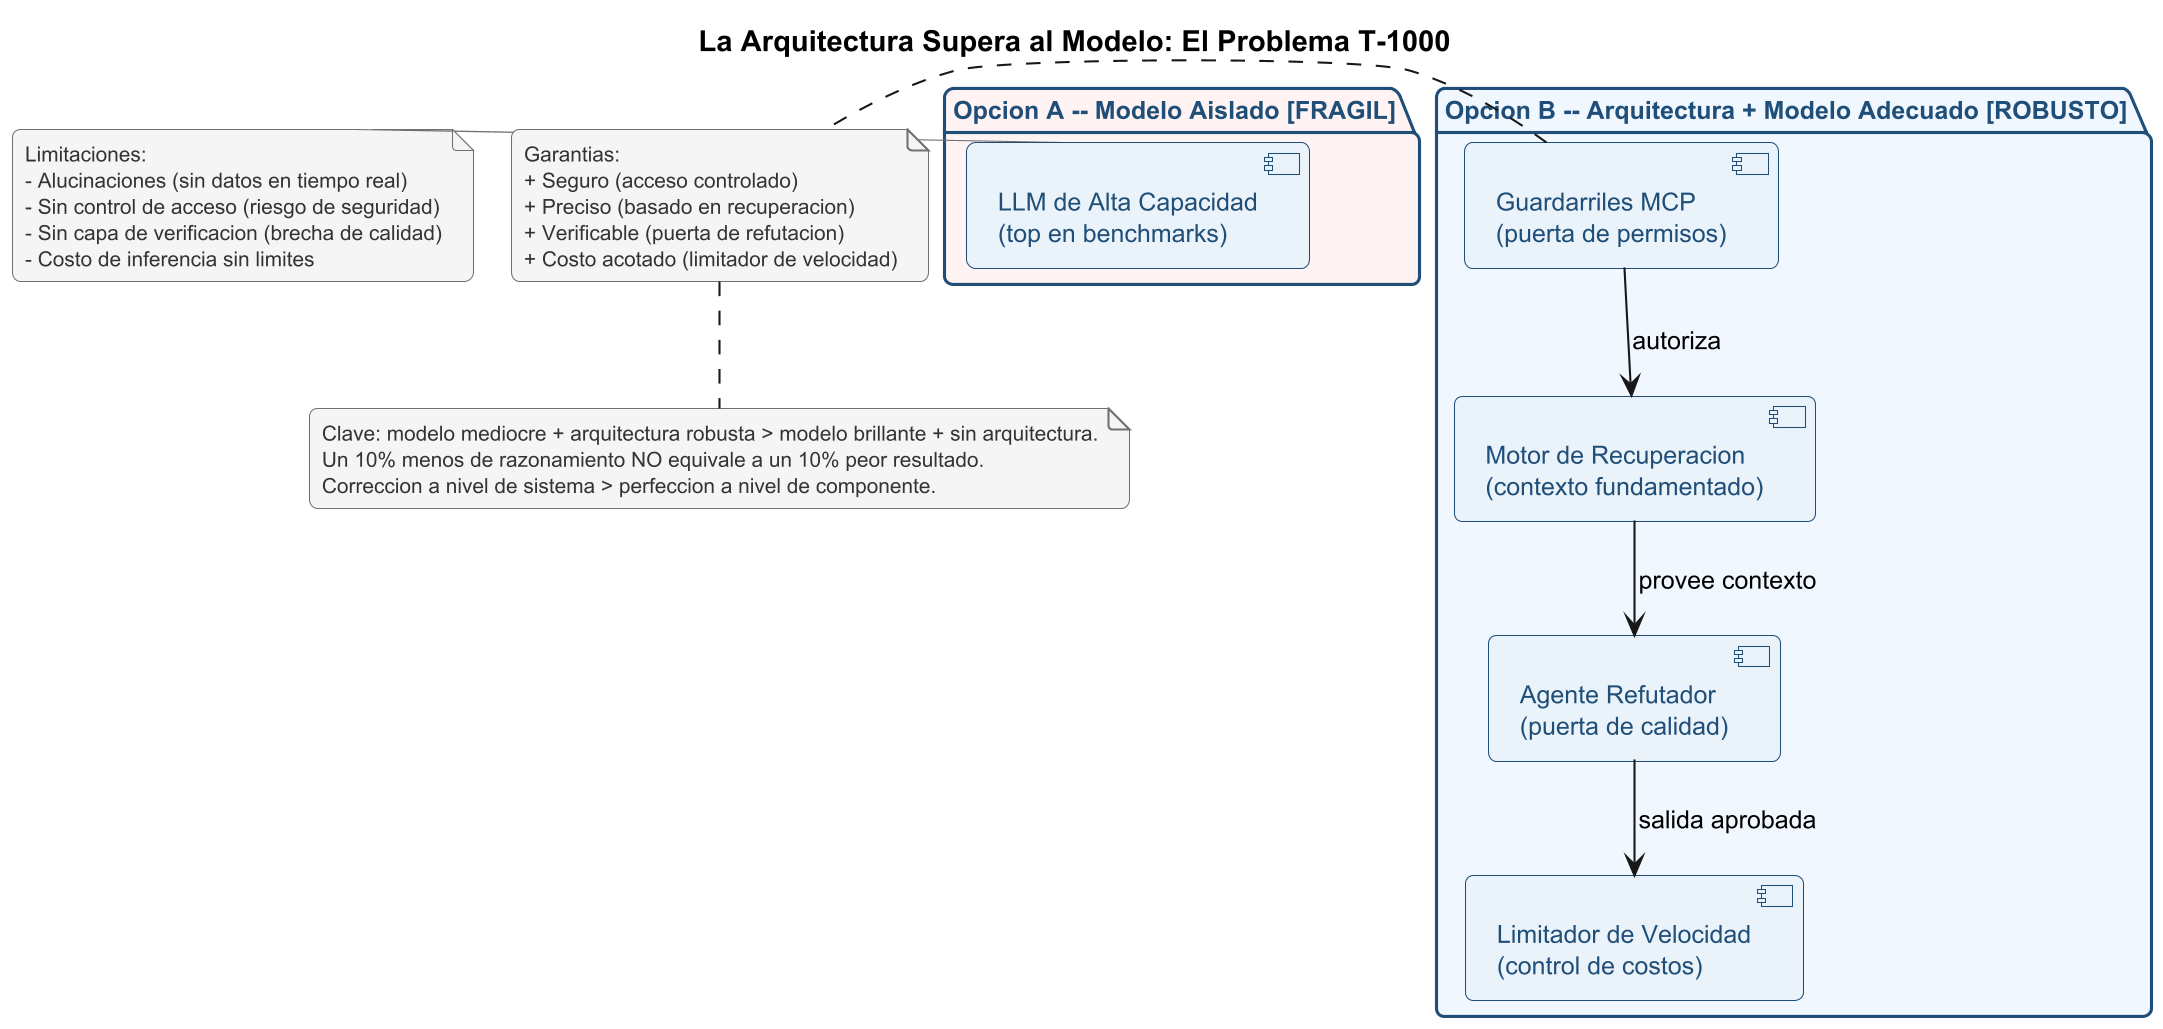
He aquí la tesis central sintetizada: en la competencia agéntica, la arquitectura es el verdadero campo de batalla, no el modelo. Las empresas que invierten obsesivamente en tener el “mejor modelo” libran la guerra equivocada por tres razones estructurales.
Primero, la convergencia de modelos: Claude, GPT, Gemini y sus competidores convergen anualmente en los benchmarks estándar a una velocidad de aproximadamente 5 puntos porcentuales por año en las métricas más discriminativas. La ventaja del mejor modelo de hoy es la paridad del modelo mediano de mañana.
Segundo, el coste de la dependencia de modelo: un sistema diseñado en torno a un modelo específico tiene que ser rediseñado cada vez que ese modelo cambia (y los modelos cambian cada 6-12 meses). Una arquitectura agnóstica al modelo incorpora cualquier mejora sin rediseño.
Tercero, el efecto de suelo: en sistemas con Q_arquitectura < 0.6, ningún modelo, por bueno que sea, puede llevar Q_sistema por encima de 0.6. La inversión más rentable es siempre elevar el componente mínimo de la función.
Build vs. buy en la era del modelo-commodity
Sección titulada «Build vs. buy en la era del modelo-commodity»■ PISTA EJECUTIVA
La convergencia de los modelos hacia un commodity tiene implicaciones estratégicas directas para las decisiones de build vs. buy. Cuando el modelo base es un commodity accesible vía API, la ventaja competitiva no reside en el modelo sino en la arquitectura que lo orquesta, los datos propios que lo alimentan y los procesos de verificación que aseguran su calidad.
Esta reconfiguración cambia el cálculo de make-or-buy: tiene sentido comprar el modelo base (no hay ventaja competitiva en construir modelos de propósito general desde cero para la mayoría de organizaciones) y construir la arquitectura de orquestación, el sistema de recuperación de contexto y los evaluadores de calidad propietarios (ahí es donde reside la ventaja durable).
La excepción son los modelos especializados en dominio: en salud, derecho, finanzas y otros sectores con datos propietarios y requisitos de privacidad, el fine-tuning de modelos base con datos propios sí puede producir ventaja competitiva durable. Pero incluso ahí, la arquitectura de orquestación amplifica o limita esa ventaja.
Lo esencial del capítulo 12
Sección titulada «Lo esencial del capítulo 12»- La calidad sistémica es el mínimo de las calidades del modelo, la arquitectura, el contexto, las herramientas y la contención; cualquier componente en 0 hace el sistema inútil independientemente del modelo.
- AgentBench (Liu et al., 2024): el mismo modelo (GPT-4) varía un 105% en tasa de éxito dependiendo solo del entorno de orquestación.
- MetaGPT (Hong et al., 2024): la asignación explícita de roles profesionales aumenta la tasa de completación en 184% con el mismo modelo base.
- SWE-bench (Jimenez et al., 2024): el mejor modelo en HumanEval no es el que más issues reales de GitHub resuelve; los benchmarks estáticos engañan.
- El enrutamiento dinámico de modelos puede reducir costos >60% manteniendo calidad en percentil 90+ asignando modelo correcto a complejidad correcta.
- Los modelos convergen ~5 puntos porcentuales/año en benchmarks discriminativos; la ventaja del mejor modelo de hoy es la paridad del mediano de mañana.
- Build vs. buy: comprar modelo base (commodity), construir arquitectura de orquestación, contexto y evaluadores (ventaja competitiva durable).