Capítulo 4: Fundamentos técnicos del agente moderno
Nota de orientación: este es el capítulo más denso del volumen. Reúne el modelo cognitivo del agente, los patrones de razonamiento (ReAct y variantes), el manejo de contexto, el diseño del arnés de producción y la traducción de Clean Code y SOLID al código sintético. Véase la Guía de lectura en las páginas preliminares.
De la cadena de texto al sistema cognitivo
Sección titulada «De la cadena de texto al sistema cognitivo»El salto conceptual más importante para un ingeniero que viene del mundo tradicional es entender que un agente moderno no es un «chatbot mejorado». Es un sistema cognitivo con estructura interna: percepción, estado, razonamiento, acción y memoria, organizados alrededor de un modelo de lenguaje que hace las veces de motor de inferencia.
La arquitectura de referencia sigue siendo la de la literatura clásica de agentes Russell & Norvig, 2020, y su traducción a la era LLM tiene cinco componentes:
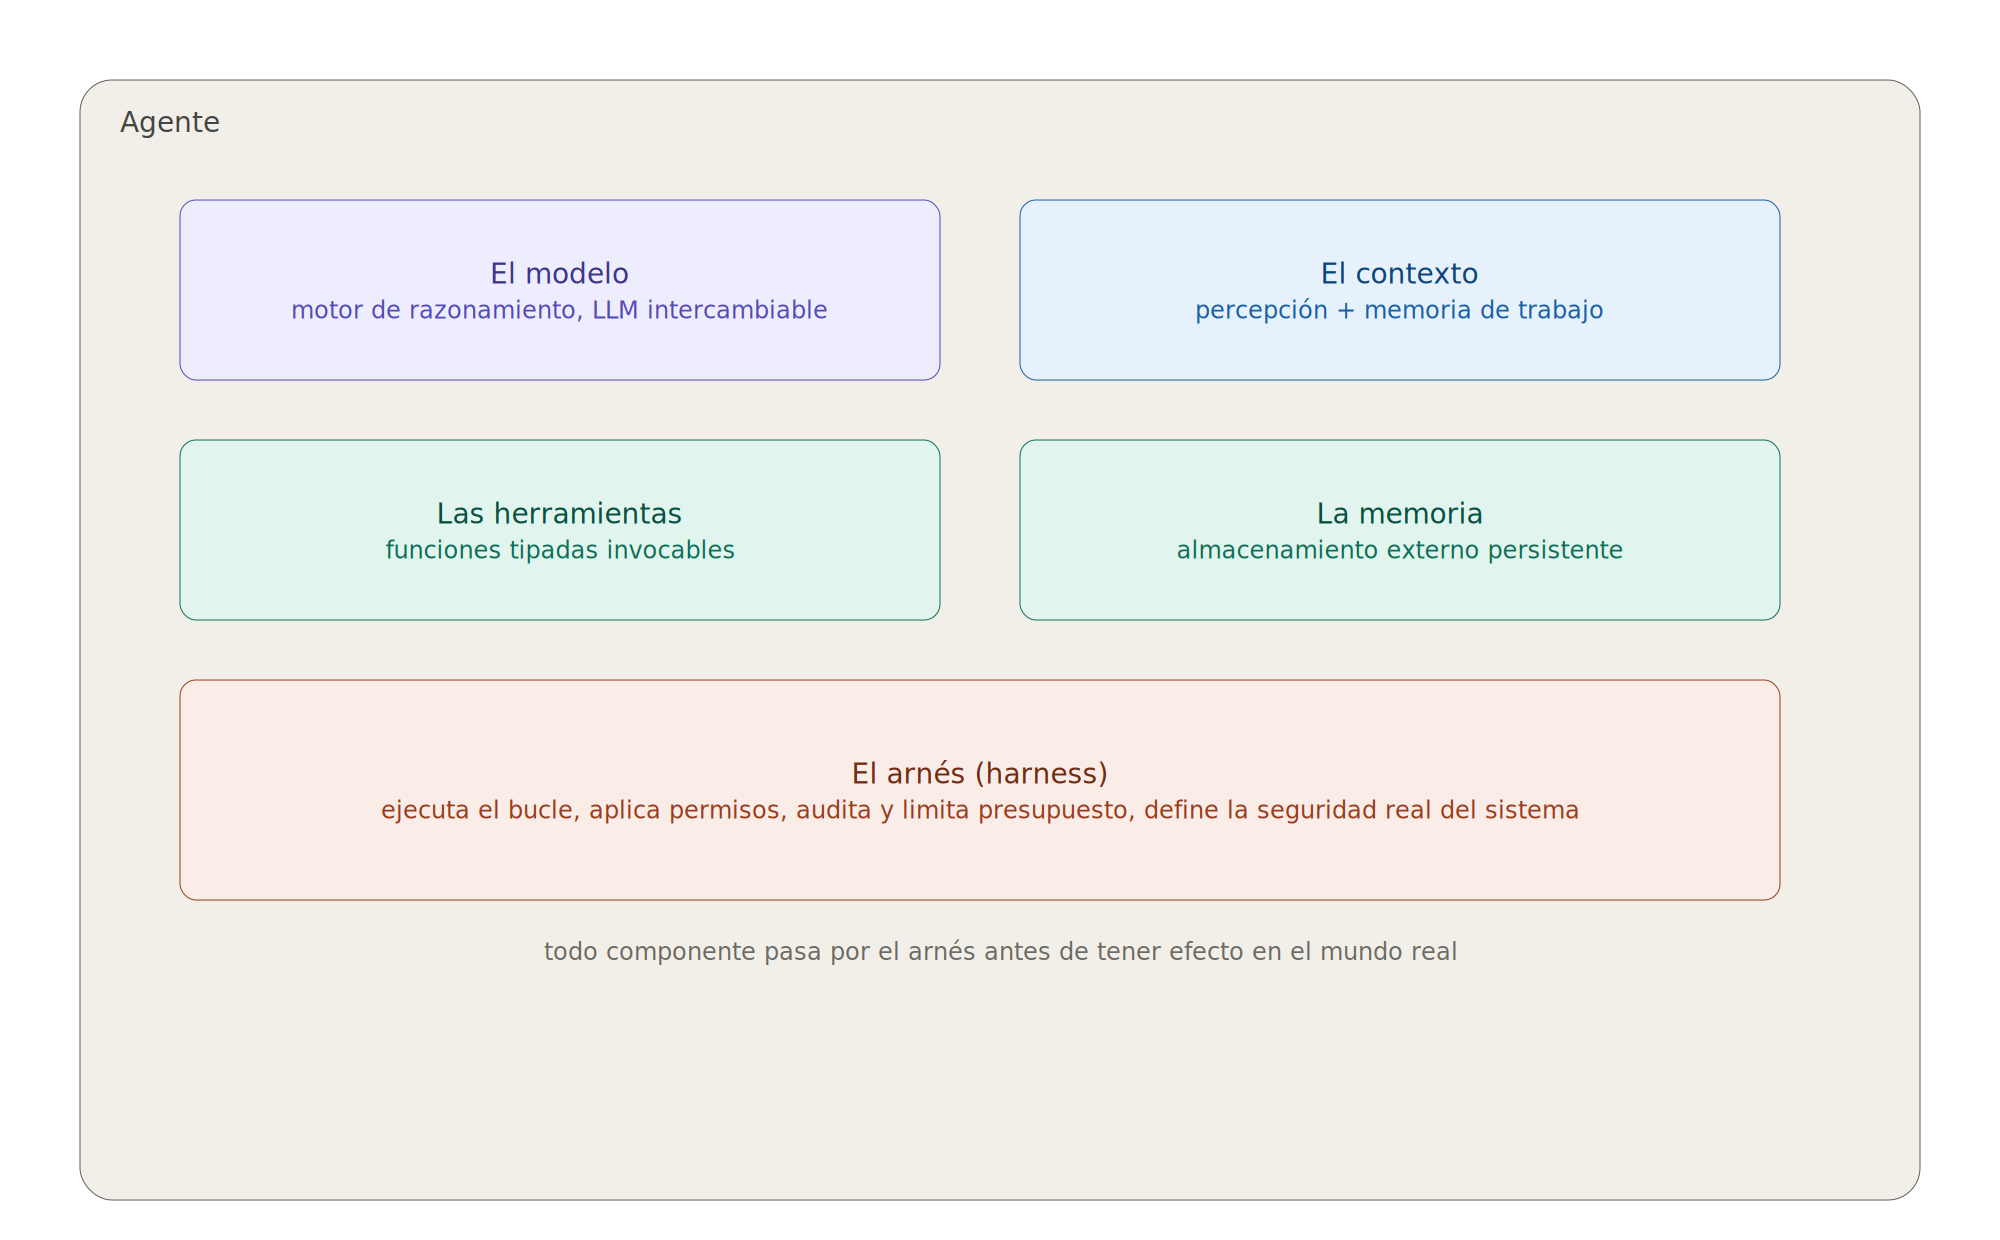
- El modelo (motor de razonamiento): un LLM accesible por API, intercambiable y versionado.
- El contexto (percepción + memoria de trabajo): instrucciones de sistema, historial, resultados de herramientas, conocimiento recuperado.
- Las herramientas (efectores): funciones tipadas que el modelo puede invocar.
- La memoria (persistencia): almacenamiento externo (archivos, vectores, bases de datos) que sobrevive a la sesión.
- El arnés (harness, el cuerpo): el código que ejecuta el bucle, aplica permisos, registra auditoría e impone presupuestos. El arnés es la parte que el proveedor no le da y que define la seguridad real del sistema.
El patrón ReAct: la base de todo agente
Sección titulada «El patrón ReAct: la base de todo agente»El patrón ReAct (Reasoning + Acting) es el algoritmo fundamental que subyace a la mayoría de los agentes modernos Yao, Zhao, et al., 2023. Su contribución, validada experimentalmente sobre tareas de razonamiento y de decisión, fue demostrar que intercalar trazas de razonamiento con acciones sobre un entorno supera tanto al razonamiento puro (que alucina sin contacto con la realidad) como a la acción pura (que actúa sin plan):
Ciclo ReAct:
1. THOUGHT:  "Necesito saber qué archivos Python existen en el proyecto"2. ACTION:   glob(pattern="**/*.py")3. OBSERVE:  ["src/main.py", "src/agents/orchestrator.py", "tests/test_agent.py"]4. THOUGHT:  "Tengo 3 archivos. El más relevante es orchestrator.py"5. ACTION:   read_file("src/agents/orchestrator.py")6. OBSERVE:  [contenido del archivo]7. THOUGHT:  "Veo que usa el patrón X. La respuesta al usuario es..."8. ANSWER:   [respuesta final al usuario]
Cada ciclo consume tokens; cada ciclo tiene un costo. Entender ReAct es entender por qué ocurre el Token-Burn, y cómo controlarlo: el número de ciclos por tarea es la variable económica fundamental de un agente, y se gobierna con criterios de parada, presupuestos y diseño de herramientas que minimicen iteraciones fallidas.
# Ejemplo 4.1: Bucle agéntico mínimo y completo con la API de Claude.# Este es el esqueleto de TODO agente: un bucle while que alterna# inferencia y ejecución de herramientas hasta que el modelo decide parar.
import jsonimport anthropic
client = anthropic.Anthropic()
TOOLS = [{    "name": "get_weather",    "description": "Obtiene el clima actual de una ciudad. USAR cuando el "                   "usuario pregunte por clima o temperatura actual.",    "input_schema": {        "type": "object",        "properties": {"city": {"type": "string", "description": "Ciudad"}},        "required": ["city"],    },}]
def execute_tool(name: str, tool_input: dict) -> str:    if name == "get_weather":        # En producción: llamada real a un servicio meteorológico        return f"22°C y despejado en {tool_input['city']}"    return f"Herramienta desconocida: {name}"
def run_agent(user_input: str, max_iterations: int = 10) -> str:    """Bucle ReAct con criterio de parada explícito (presupuesto de ciclos)."""    messages = [{"role": "user", "content": user_input}]
    for _ in range(max_iterations):          # SIEMPRE acotar el bucle        response = client.messages.create(            model="claude-opus-4-8",            max_tokens=4096,            tools=TOOLS,            messages=messages,        )
        if response.stop_reason != "tool_use":            return next(b.text for b in response.content if b.type == "text")
        # El modelo pidió herramientas: ejecutarlas y devolver resultados        messages.append({"role": "assistant", "content": response.content})        tool_results = []        for block in response.content:            if block.type == "tool_use":                result = execute_tool(block.name, block.input)                tool_results.append({                    "type": "tool_result",                    "tool_use_id": block.id,                    "content": result,                })        messages.append({"role": "user", "content": tool_results})
    return "Presupuesto de iteraciones agotado sin respuesta final."
Tres detalles de este código son lecciones de producción. Primero, el bucle está acotado (max_iterations): un agente sin criterio de parada es un incidente de facturación esperando a ocurrir. Segundo, el contenido íntegro de la respuesta del asistente, incluidos los bloques de invocación, se reenvía en el historial: el protocolo de la API lo exige y omitirlo es el error de principiante más común. Tercero, cada resultado de herramienta lleva el identificador de la invocación que lo originó: la trazabilidad empieza en el protocolo.
Más allá de ReAct: la familia de patrones de razonamiento
Sección titulada «Más allá de ReAct: la familia de patrones de razonamiento»ReAct no está solo. La investigación 2022–2024 produjo una familia de patrones que el AI Engineer debe conocer porque cada uno compra calidad con tokens de forma distinta:
- Chain-of-Thought (CoT). Inducir al modelo a razonar paso a paso antes de responder mejora sustancialmente el desempeño en problemas de varios pasos Wei, Wang, et al., 2022. Es el patrón más barato: un solo pase de inferencia, más tokens de salida. Los modelos recientes lo incorporan de forma nativa como «razonamiento extendido» o «pensamiento adaptativo», donde el propio modelo decide cuánto pensar.
- Tree of Thoughts (ToT). Generalizar el CoT a un árbol: explorar varias líneas de razonamiento, evaluarlas y retroceder Yao, Yu, et al., 2023. Multiplica el costo; se reserva para problemas de búsqueda y planificación donde el primer camino rara vez es el bueno.
- Self-Refine. El modelo critica su propia salida y la mejora en iteraciones sucesivas, sin entrenamiento adicional, con mejoras medias del orden del 20 % en preferencia humana sobre tareas diversas Madaan et al., 2023.
- Reflexion. Tras un intento fallido verificable (un test que no pasa, una respuesta incorrecta), el agente genera una reflexión verbal sobre el fallo, la guarda en memoria episódica y reintenta con esa lección en el contexto Shinn et al., 2023. Es el fundamento del self-reflection loop del capítulo 8.
La regla de selección es económica: CoT por defecto; Self-Refine cuando hay criterio de calidad automático; Reflexion cuando hay señal de éxito verificable; ToT solo cuando el espacio de soluciones lo exige. Cada peldaño multiplica el costo por tarea; el capítulo 1 (Vol. 4) da las herramientas para decidir con números.
La ventana de contexto no es memoria
Sección titulada «La ventana de contexto no es memoria»Un error conceptual caro: tratar la ventana de contexto como si fuera memoria fiable. La evidencia dice otra cosa: el rendimiento de los modelos al usar información de contextos largos degrada significativamente cuando la información relevante está en el medio del contexto, con una curva en U: se recuerda mejor lo del principio y lo del final Liu et al., 2024. Las consecuencias de diseño:
- Posición importa. Las instrucciones críticas van al principio (sistema) o al final (último mensaje), nunca enterradas en medio de un volcado documental.
- Menos es más. Inyectar el fragmento relevante (RAG bien afinado) supera a inyectar el documento completo, en calidad además de en costo.
- La memoria de largo plazo se externaliza. Arquitecturas como MemGPT formalizan la analogía con los sistemas operativos: una jerarquía de memoria donde el contexto es la RAM, escasa y cara, y el almacenamiento externo es el disco, con el propio modelo gestionando qué se carga y qué se archiva Packer et al., 2024.
Razonamiento extendido: la nueva frontera del agente deliberativo
Sección titulada «Razonamiento extendido: la nueva frontera del agente deliberativo»El advenimiento de los modelos con capacidad de razonamiento extendido (categoría formalizada entre 2024 y 2025) ha reconfigurado sustancialmente los fundamentos arquitectónicos presentados en las secciones precedentes. La evidencia empírica acumulada en benchmarks de complejidad elevada indica que la asignación dinámica de cómputo en tiempo de inferencia (test-time compute scaling) constituye una dimensión de optimización cualitativamente distinta del escalado de parámetros: en determinadas clases de problemas, incrementar los recursos computacionales durante la inferencia resulta más eficiente que aumentar el tamaño del modelo Snell et al., 2024.
De esta observación se derivan dos consecuencias arquitectónicas de primer orden. En primer lugar, la distinción entre razonamiento rápido y razonamiento deliberativo (conceptualización originalmente avanzada por Kahneman (2011) en el contexto de la cognición humana) adquiere traducción operativa directa en los modelos contemporáneos: sistemas como o1 de OpenAI (2024) y el mecanismo de extended thinking de la familia Claude Anthropic, 2024c generan una cadena de pensamiento interna que puede abarcar miles de tokens de reflexión antes de emitir la respuesta visible al usuario. En segundo lugar, este modelo introduce un nuevo parámetro de optimización (el presupuesto de razonamiento (thinking budget)) que el AI Engineer debe administrar con la misma precisión con que gestiona el presupuesto de iteraciones ReAct.
La implicación práctica central puede enunciarse con precisión: no toda tarea justifica razonamiento extendido. El costo computacional puede superar en un orden de magnitud al de una llamada convencional; activarlo en una clasificación de correos sería equivalente a emplear cálculo diferencial para ordenar cinco elementos. La heurística de selección reproduce la lógica ya establecida para los patrones de razonamiento:
| Situación | Razonamiento estándar (CoT) | Razonamiento extendido |
|---|---|---|
| Clasificación, extracción estructurada | ✓ Suficiente | ✗ Sobredimensionado |
| Generación de código de complejidad moderada | ✓ Suficiente | ✗ Salvo requisitos críticos |
| Razonamiento matemático multi-paso | ✓ Con limitaciones | ✓ Cuando los errores son costosos |
| Planificación arquitectónica de alto impacto | ~ Límite del método | ✓ Justificado |
| Diagnóstico de incidentes de producción complejos | ~ | ✓ El razonamiento profundo preserva el SLA |
# Ejemplo 4.2: Razonamiento extendido con presupuesto explícito.# El thinking_budget es el equivalente de max_iterations para el razonamiento interno.# Reservar exclusivamente para tareas donde el costo del error supera el del razonamiento.## NOTA: requiere modelos con soporte de razonamiento extendido.# Consulte la documentación de Anthropic para disponibilidad actualizada.
import anthropic
client = anthropic.Anthropic()
def analizar_arquitectura_compleja(    descripcion: str,    thinking_budget: int = 10_000,) -> dict:    """    Análisis arquitectónico con razonamiento extendido.    Costo potencial: 10–20× el de una llamada convencional al mismo modelo.    """    respuesta = client.messages.create(        model="claude-opus-4-8",        max_tokens=16_000,        thinking={"type": "enabled", "budget_tokens": thinking_budget},        messages=[{            "role": "user",            "content": (                "Analiza esta arquitectura y determina: "                "(1) los tres riesgos de mayor probabilidad × impacto, "                "(2) la decisión de diseño más urgente de revisar, "                "(3) el camino de migración de menor riesgo si se detecta un problema crítico.\n\n"                f"Arquitectura: {descripcion}"            ),        }],    )
    tokens_razonamiento, texto = 0, ""    for bloque in respuesta.content:        if bloque.type == "thinking":            tokens_razonamiento = len(bloque.thinking.split())        elif bloque.type == "text":            texto = bloque.text
    return {        "analisis": texto,        "tokens_razonamiento_estimados": tokens_razonamiento,        "costo_estimado_usd": (            (respuesta.usage.input_tokens / 1_000_000) * 5.00            + (respuesta.usage.output_tokens / 1_000_000) * 25.00        ),    }
En el plano de la evidencia empírica, los benchmarks AIME 2024 (competición de matemáticas de nivel olímpico) documentaron que modelos convencionales resolvían menos del 15 % de los problemas, mientras que los dotados de razonamiento extendido alcanzaron tasas superiores al 70 % OpenAI, 2024. En el dominio del software, SWE-bench Verified (versión curada del benchmark original Jimenez et al., 2024) evidenció que agentes con razonamiento extendido superaron en un 40 % relativo a los basados en cadena de pensamiento convencional en corrección de defectos reales. Estos resultados establecen la clase de problemas donde el razonamiento extendido genera retorno económico positivo; no toda tarea los encarna.
Resiliencia en agentes de producción: el arnés como sistema de control
Sección titulada «Resiliencia en agentes de producción: el arnés como sistema de control»Los modos de fallo de un agente en producción difieren cualitativamente de los de un sistema determinista. A diferencia de los servicios web convencionales (cuyo estado de error es discreto (el endpoint responde o no responde)) un agente puede fallar de forma gradual y silenciosa: producir salidas que aparentan ser válidas pero omiten el paso crítico, o correctas el 95 % del tiempo y erróneas en los casos límite que ninguna prueba manual alcanza. Tres patrones de resiliencia son aplicables de forma inmediata:
Disyuntor agéntico (Agentic Circuit Breaker). Derivado del patrón documentado por Fowler (2002), adapta su lógica a los agentes: monitoriza la tasa de ciclos fallidos en una ventana temporal; si supera el umbral, abre el circuito y enruta hacia un flujo de degradación controlada en lugar de permitir que el agente continúe consumiendo tokens en estado de fallo encubierto.
Reintentos con retroceso exponencial y jitter. El bucle ReAct ya implementa reintentos implícitos; la diferencia con un reintento de producción reside en la gestión del estado entre intentos: el agente persiste su razonamiento parcial antes de reintentar para no repetir el trabajo completado. El patrón Reflexion Shinn et al., 2023 formaliza esta gestión del estado inter-ciclo.
Presupuesto de confianza por herramienta. Cada herramienta mantiene un historial de tasa de éxito en la sesión; si falla más de N veces consecutivas, el arnés la deshabilita y emite alerta. El registro de auditoría (que el arnés ya mantiene por otras razones) provee toda la información necesaria sin instrumentación adicional.
# Ejemplo 4.3: Disyuntor agéntico minimal.# El presupuesto de confianza por herramienta sigue el mismo patrón de datos.
from collections import dequefrom dataclasses import dataclass, field
@dataclassclass DisyuntorAgéntico:    """    Abre el circuito cuando la tasa de ciclos fallidos supera el umbral    en la ventana temporal configurada. Sin estado global: una instancia    por sesión de agente.    """    tamaño_ventana: int = 10    umbral_fallo: float = 0.5    _resultados: deque = field(        default_factory=lambda: deque(maxlen=10))    _abierto: bool = False
    def registrar(self, exito: bool):        self._resultados.append(exito)        if len(self._resultados) == self.tamaño_ventana:            tasa = 1 - sum(self._resultados) / len(self._resultados)            self._abierto = tasa >= self.umbral_fallo
    @property    def esta_abierto(self) -> bool:        return self._abierto
    def flujo_degradado(self, peticion: str) -> str:        """Llamar cuando el circuito está abierto: nunca continuar en silencio."""        return (            f"Agente en modo degradado. Petición encolada para revisión "            f"humana: {peticion[:100]}…"        )
■ PISTA EJECUTIVA: Las cuatro dimensiones del SLA agéntico
Un SLA de disponibilidad (expresado como porcentaje de uptime) resulta necesario pero insuficiente para los sistemas agénticos: un agente puede estar disponible (responder en menos de 500 ms) y producir código incorrecto el 20 % de las veces. El SLA completo comprende al menos cuatro dimensiones que deben definirse antes de cualquier adopción:
- Disponibilidad técnica: porcentaje de solicitudes sin error técnico. Métrica convencional; se instrumenta igual que cualquier servicio HTTP.
- Tasa de aceptación a la primera: porcentaje de salidas aprobadas por el revisor humano sin modificación. Esta es la métrica de calidad; sin ella, las cifras de productividad reportadas son ilusiones (Peng et al., 2023; Ziegler et al., 2024).
- Costo por tarea completada: no por invocación, sino por tarea de negocio cerrada; se relaciona directamente con el CIU (Costo de Iteración por Unidad) del capítulo 1 (Vol. 4).
- Latencia del ciclo completo: desde el inicio hasta la salida verificada, incluyendo todos los ciclos ReAct y la ejecución de herramientas. Esta métrica difiere cualitativamente de la latencia de API y es la que el usuario de negocio experimenta.
Un comité ejecutivo que adopta agentes sin definir previamente estas cuatro dimensiones está adoptando tecnología sin criterio de éxito. Lo que no se define, no se mide; lo que no se mide, no mejora.
Ejercicio resuelto 4.1: diseñe el arnés de producción
Sección titulada «Ejercicio resuelto 4.1: diseñe el arnés de producción»Enunciado. Un agente de revisión de contratos lleva tres semanas en producción con un promedio de 2,3 ciclos por contrato. El equipo detecta que ciertos contratos producen 15+ ciclos antes de agotar el presupuesto sin respuesta útil. Diseñe las tres modificaciones al arnés que diagnosticarían y resolverían el problema.
Solución comentada. Las tres modificaciones son diagnóstico, protección y mejora (en ese orden, porque optimizar sin comprender es adivinar):
Diagnóstico: añadir telemetría por tipo de contrato (longitud, idioma, tipo de cláusula) al registro de auditoría. El patrón de 15+ ciclos casi siempre está correlacionado con una categoría específica: contratos en formato no estándar, idiomas mixtos o tablas que el extractor procesa mal. Sin el dato, la búsqueda es aleatoria.
Protección: implementar el disyuntor con umbral basado en percentil, no en máximo. Si el P95 de ciclos es 4, un presupuesto de 10 es razonable; un presupuesto de 15 es un incidente esperando facturarse. El disyuntor debe escalar, no abortar en silencio: el contrato que excede el presupuesto va a la cola de revisión humana con su traza completa.
Mejora: identificada la categoría problemática, la solución raramente es «más ciclos»; es una herramienta especializada (preprocesador de tablas, normalizador de formato) que reduce los ciclos a 2–3. La lección central: los problemas de rendimiento de los agentes casi siempre son problemas de diseño de herramientas, no de presupuesto de tokens.
El desacoplamiento del arnés: Capas de control tipadas (System One) y agentes persistentes
Sección titulada «El desacoplamiento del arnés: Capas de control tipadas (System One) y agentes persistentes»La evolución de los arneses de producción en 2026 ha consolidado un cambio de paradigma frente al bucle ReAct clásico: desacoplar el control determinista de la inferencia generativa. En los arneses tempranos, se confiaba a un modelo generativo deliberativo (System Two) la totalidad de las tareas: comprender la semántica, redactar la prosa, seleccionar la herramienta en un catálogo JSON, evaluar la seguridad de la llamada y juzgar cuándo detener el bucle. Este enfoque sufre de tres deficiencias en producción:
- Fricción sintáctica: obligar al LLM a emitir texto libre mezclado con bloques JSON introduce fallos de formato que consumen tokens en bucles de reintento.
- Latencia acumulada: invocar un modelo de razonamiento pesado para decidir si una herramienta de lectura es segura introduce segundos de retraso por ciclo.
- Acoplamiento vicioso: el estado del entorno y las instrucciones del sistema viajan juntos en la ventana de contexto, facilitando la inyección de instrucciones hostiles desde datos no confiables.
Para resolver este dilema, la arquitectura de Jev (TypeSafe AI, 2026) ejemplifica la separación estricta entre deliberación y control mediante un modelo System One:
- Inferencia sin generación de texto: Jev no redacta prosa ni esquemas JSON. Responde exclusivamente a preguntas tipadas con distribuciones de probabilidad calibradas (
Choicepara selección de herramientas,Scorepara niveles de riesgo, yNoulpara confirmaciones booleanas). - El ciclo de cuatro etapas:
SELECT: determina qué herramienta del catálogo responde al objetivo mediante la primitivaChoice.GATE: evalúa en paralelo si la acción es destructiva, su radio de impacto (blast radius) y su reversibilidad. La regla arquitectónica es tajante: el gate asesora, el runtime impone. Si una llamada es destructiva sobre un entorno externo o del sistema, el runtime la deniega (deny) automáticamente sin fatigar al humano.EXECUTE: ejecución en un sandbox determinista (sandbox.ts) donde los argumentos se extraen por código (arguments.ts), manteniendo el texto no confiable estrictamente como dato.JUDGE: evalúa completitud y estancamiento, supervisado por un límite duro de pasos inmutable.
- Inversión de dependencias (DIP) para pruebas offline: el arnés se apoya en una interfaz abstracta
Decider. Esto permite sustituir el modelo real por unFakeDeciderdeterminista en CI, probando todas las ramas de control y sandboxing al 100% sin credenciales, sin costo y de forma inmediata.
A nivel de orquestación organizacional, este principio de aislamiento y control estricto se replica en los Dots (OpenAI, 2026): compañeros de trabajo digitales persistentes (persistent digital coworkers) que operan en entornos cloud aislados bajo un plano de control gobernado. En lugar de agentes monolíticos conectados de forma caótica, los Dots imponen bounded contexts rigurosos y se comunican a través de eventos asíncronos tipados, asegurando que las políticas de seguridad y observabilidad residan en la infraestructura y no en la fragilidad de un prompt.
El Código Limpio Sintético: los principios que perduran
Sección titulada «El Código Limpio Sintético: los principios que perduran»Las tecnologías de esta industria caducan; los principios, no. Clean Code enseñó a una generación que el código se escribe para personas y que la legibilidad es una decisión económica, no estética Martin, 2009; Refactoring enseñó que mejorar el diseño sin cambiar el comportamiento es una disciplina con catálogo propio Fowler, 2018. Ninguno de los dos libros menciona modelos de lenguaje y, sin embargo, ambos describen con precisión cómo se construyen buenos sistemas agénticos, porque los artefactos centrales de la era agéntica (prompts, herramientas, skills, orquestadores) son texto que será leído por un intérprete falible. Eso es lo que siempre fue el código.
Proponemos el Código Limpio Sintético: la traducción de los principios clásicos a los artefactos agénticos. Lo presentamos aquí, en el capítulo de fundamentos, porque el resto de este volumen lo aplicará pieza por pieza:
| Principio clásico | En código (Martin, 2009; Fowler, 2018) | En sistemas agénticos |
|---|---|---|
| Nombres significativos | Una variable se llama por lo que contiene | El nombre de una herramienta o skill ES su prompt: buscar_documentacion_tecnica se invoca bien; helper2 no se invoca nunca o se invoca mal |
| Responsabilidad única (SRP) | Una función hace una cosa | Una herramienta ejecuta una acción; un agente ejerce un rol; un skill encapsula un procedimiento. El agente «que hace de todo» es la god class de esta década |
| Comentarios honestos | El comentario explica el porqué, no el qué | La descripción de la herramienta dice cuándo usarla y cuándo no, no repite lo obvio del esquema |
| Errores explícitos | Excepciones tipadas, nunca códigos mágicos | Resultados de herramienta con is_error y mensajes accionables: «Ciudad no encontrada; usa el formato Ciudad, País» le permite al modelo corregirse; «Error 500» lo deja adivinando |
| DRY | Una sola fuente de verdad | Prompts maestros y plantillas versionadas (capítulo 5); precios y modelos en un único módulo (apéndices A y B) |
| Fronteras (boundaries) | Interfaces que aíslan lo externo | Bounded contexts (capítulo 6) y separación instrucciones/datos (capítulo 4 (Vol. 4)) |
| Tests primero | El test define el comportamiento | Los evals definen la calidad antes de optimizarla (capítulo 3 (Vol. 4)) |
| La regla del Boy Scout | Deja el código más limpio de lo que lo encontraste | Deja el prompt más limpio de lo que lo encontraste: cada incidente de producción termina en una mejora versionada del prompt, el skill o el contexto |
Dos consecuencias de este cuadro merecen subrayarse. La primera: el refactoring de prompts existe y se practica con la misma disciplina que el de código: pequeños pasos, comportamiento verificado por la suite de evals antes y después Fowler, 2018. La segunda: la revisión de prompts en pull request deja de ser opcional; un prompt de producción que cambia sin revisión es un commit directo a la rama principal.
Este es el hilo que cose el volumen: el capítulo 5 aplica estos principios a los roles y a los prompts maestros; el 6, a las fronteras de dominio; el 7, a los skills y sus plantillas; el 8, a los orquestadores; el 9, a las herramientas MCP. Si el lector retoma el libro meses después en cualquiera de esos capítulos, esta tabla es el mapa para reubicarse.
SOLID como interrogatorio: las preguntas que refactorizan
Sección titulada «SOLID como interrogatorio: las preguntas que refactorizan»La tabla anterior traduce los principios; falta la herramienta que los pone en movimiento. Un principio enunciado es una afirmación que el lector aprueba con la cabeza y olvida a la semana; un principio convertido en pregunta es un procedimiento que se ejecuta. La diferencia es la misma que entre «el código debe tener responsabilidad única» y «¿qué segunda razón de cambio esconde esta clase?». La primera adorna una diapositiva; la segunda encuentra el defecto.
El autor sintetizó los cinco principios SOLID Martin, 2017 como un cuestionario de refactorización (material publicado primero ante la comunidad; véase «Obra pública del autor»), y que aquí adquiere una segunda vida con un giro propio de la era agéntica: estas mismas preguntas son el prompt de un agente revisor. Lo que durante años fue una lista mental del ingeniero experto se vuelve el cuerpo de un skill de revisión de diseño (capítulo 7), ejecutable sobre cada pull request.
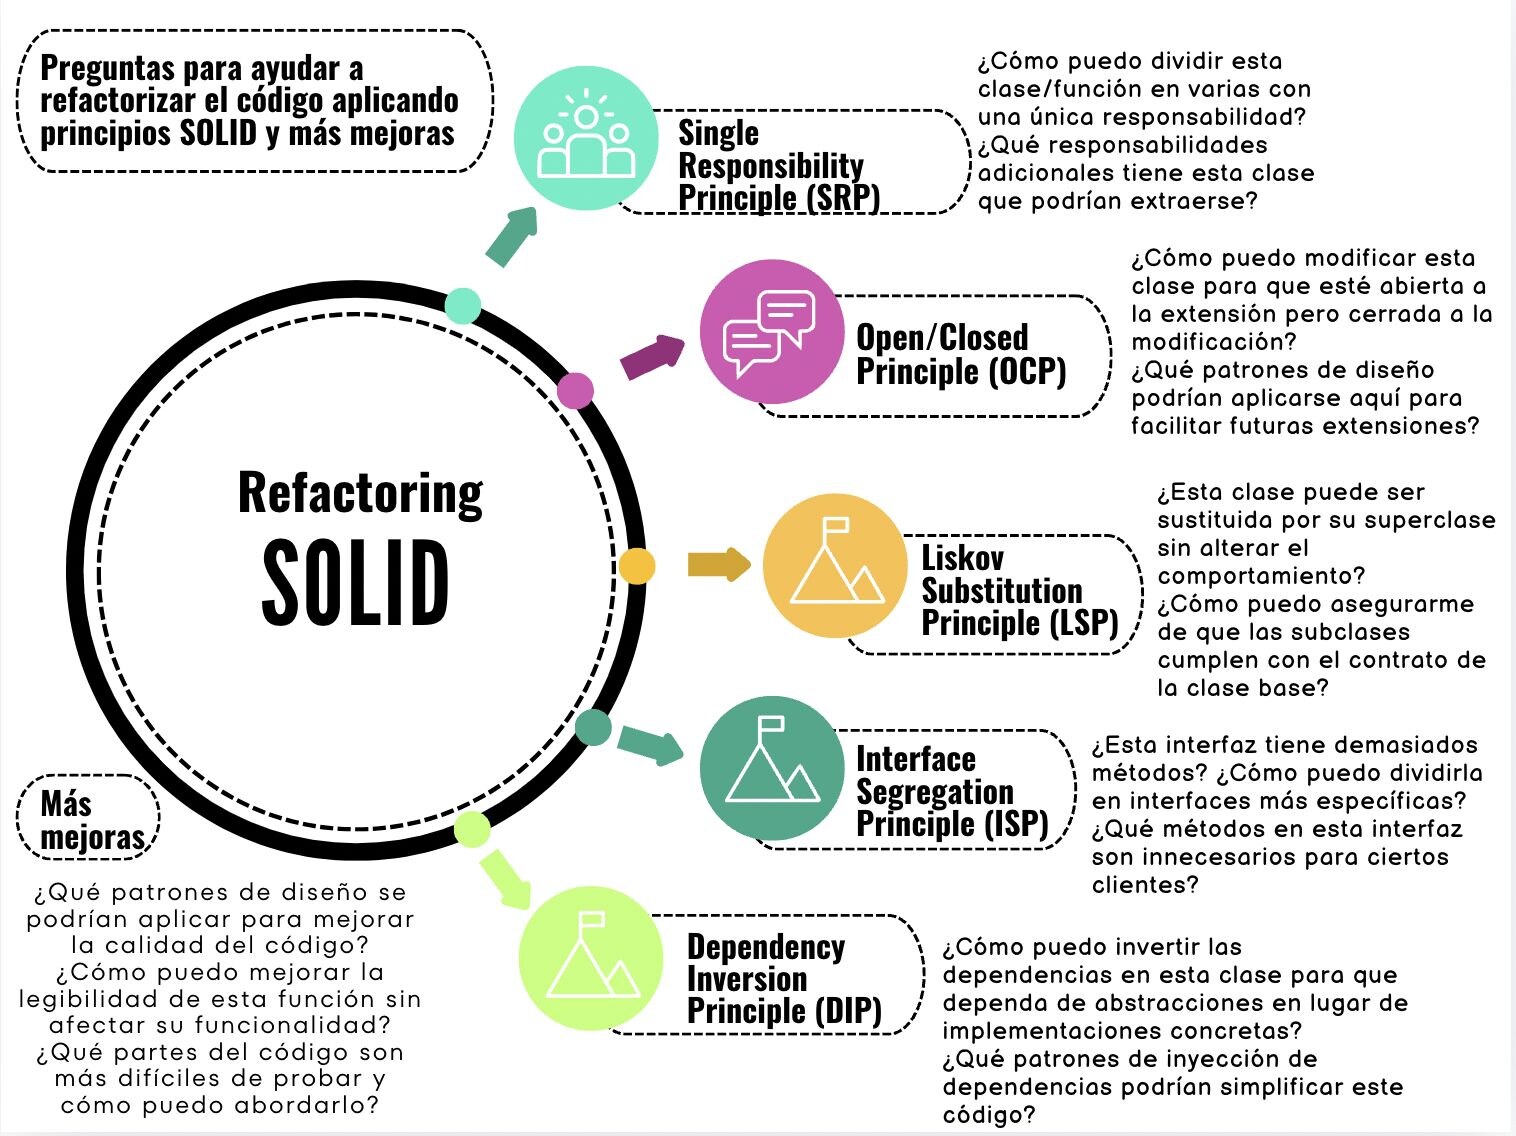
El interrogatorio, principio por principio:
- Responsabilidad única (SRP). ¿Cómo puedo dividir esta clase o función en varias con una única responsabilidad? ¿Qué responsabilidades adicionales tiene esta clase que podrían extraerse? En el dominio agéntico la pregunta se traslada sin cambios: ¿qué hace este agente además de su rol declarado? El revisor que también clasifica y el clasificador que también redacta son la god class del prompt.
- Abierto/cerrado (OCP). ¿Cómo modificar esta clase para que esté abierta a la extensión pero cerrada a la modificación? ¿Qué patrón de diseño facilita las extensiones futuras? Para un sistema de agentes: ¿puedo añadir un rol nuevo sin reescribir el orquestador? Si la respuesta exige tocar el bucle de control, el orquestador acopla lo que debería delegar (capítulo 8).
- Sustitución de Liskov (LSP). ¿Esta subclase puede sustituir a su superclase sin alterar el comportamiento? ¿Las subclases cumplen el contrato de la base? Su análogo agéntico es el contrato de herramienta: ¿un adaptador de proveedor distinto (capítulo 3) respeta el mismo esquema de entrada y salida, o introduce sorpresas que el modelo no puede prever?
- Segregación de interfaces (ISP). ¿Esta interfaz tiene demasiados métodos? ¿Cómo dividirla en interfaces más específicas? ¿Qué métodos sobran para ciertos clientes? Para el agente: una herramienta con quince parámetros opcionales es una interfaz gorda: el modelo la usa peor que tres herramientas precisas.
- Inversión de dependencias (DIP). ¿Cómo invertir las dependencias para depender de abstracciones y no de implementaciones concretas? Es, literalmente, la tesis del capítulo 6 (Vol. 4): «el modelo es un detalle». El dominio depende de un puerto de inferencia, no de un SDK.
Cerrando la rueda, las preguntas de mejora general que el cuestionario añade a los cinco principios: ¿qué patrones de diseño elevarían la calidad? ¿Cómo mejorar la legibilidad sin tocar la funcionalidad? ¿Qué partes son más difíciles de probar y cómo abordarlas? Esta última es la bisagra con el capítulo 3 (Vol. 4): lo difícil de probar suele ser lo mal diseñado, y en sistemas agénticos lo que no se puede evaluar no se puede gobernar.
El valor de formular SOLID como interrogatorio es doble. Para el humano, convierte un principio abstracto en una acción concreta durante la revisión. Para el agente, las preguntas son directamente el prompt: un skill revision-de-diseno que recorre la rueda sobre el diff produce hallazgos accionables en lugar de la felicitación genérica («el código se ve bien») que es el modo de fallo por defecto de un revisor automático sin criterio. La disciplina del refactoring de Fowler (2018), pasos pequeños y comportamiento verificado por la suite de evals antes y después, gobierna la aplicación: el agente propone la refactorización; el humano la aprueba; los evals certifican que el comportamiento no cambió.
Ejercicio resuelto 4.2: dos herramientas, un presupuesto y un error bien diseñado
Sección titulada «Ejercicio resuelto 4.2: dos herramientas, un presupuesto y un error bien diseñado»Enunciado. Extienda el bucle agéntico mínimo (ejemplo 4.1) con: (a) una segunda herramienta convertir_temperatura, (b) manejo de errores accionables con is_error, y (c) verifique que el presupuesto de iteraciones se respeta.
Solución comentada.
# Solución 4.1 — las líneas nuevas están señaladas.
TOOLS = [    {        "name": "get_weather",        "description": "Obtiene el clima actual de una ciudad. USAR cuando el "                       "usuario pregunte por clima o temperatura actual.",        "input_schema": {            "type": "object",            "properties": {"city": {"type": "string", "description": "Ciudad"}},            "required": ["city"],        },    },    {   # (a) Segunda herramienta: nombre = verbo + objeto, sin ambigüedad        "name": "convertir_temperatura",        "description": "Convierte una temperatura entre °C y °F. USAR cuando "                       "el usuario pida la conversión explícitamente o pida "                       "el clima en una unidad distinta a la disponible.",        "input_schema": {            "type": "object",            "properties": {                "valor": {"type": "number"},                "a_unidad": {"type": "string", "enum": ["C", "F"]},            },            "required": ["valor", "a_unidad"],        },    },]
def execute_tool(name: str, tool_input: dict) -> tuple[str, bool]:    """Devuelve (contenido, is_error). El error es un mensaje ACCIONABLE."""    if name == "get_weather":        city = tool_input["city"].strip()        if not city:            # (b) Error que enseña al modelo cómo corregirse:            return ("Ciudad vacía. Reintenta indicando la ciudad, "                    "por ejemplo: 'Lima'.", True)        return (f"22°C y despejado en {city}", False)    if name == "convertir_temperatura":        v, u = tool_input["valor"], tool_input["a_unidad"]        return (f"{v * 9 / 5 + 32:.1f}°F" if u == "F"                else f"{(v - 32) * 5 / 9:.1f}°C", False)    return (f"Herramienta desconocida: {name}.", True)
En el bucle, el resultado se reenvía con la marca de error: {"type": "tool_result", "tool_use_id": block.id, "content": contenido, "is_error": es_error}. Para (c), la verificación es un test determinista (nivel 1 de la pirámide del capítulo 3 (Vol. 4)): con una herramienta trucada que siempre devuelva error, el bucle debe terminar exactamente en max_iterations llamadas y devolver el mensaje de presupuesto agotado.
Por qué importa. Los tres cambios son el Código Limpio Sintético en miniatura: nombres que se autoinvocan, errores que enseñan y presupuestos que se prueban. El error accionable es el detalle que más mejora la tasa de recuperación de un agente en producción, y el que casi nadie escribe.
Lo esencial del capítulo 4
Sección titulada «Lo esencial del capítulo 4»- Un agente moderno = modelo + contexto + herramientas + memoria + arnés; el arnés es suyo y define la seguridad real.
- ReAct intercala razonamiento y acción Yao, Zhao, et al., 2023; cada ciclo cuesta; el bucle SIEMPRE se acota.
- CoT por defecto; Self-Refine con criterio automático; Reflexion con señal verificable; ToT solo si el espacio de búsqueda lo exige.
- La ventana de contexto no es memoria: posición importa, menos es más, la memoria larga se externaliza (Liu et al., 2024; Packer et al., 2024).
- El desacoplamiento del arnés (System One / Jev TypeSafe AI, 2026) y la persistencia gobernada (Dots OpenAI, 2026) trasladan las decisiones críticas de control a contratos tipados fuera de la prosa generativa.
- Los principios del Código Limpio Sintético (nombres, SRP, errores accionables, DRY, fronteras, tests, Boy Scout) gobiernan el resto de este volumen.