Capítulo 26: Melbourne: donde la experimentación agéntica redefinió el modelo
Silicon Valley optimiza para velocidad. Melbourne optimiza para verdad.
La bifurcación silenciosa: benchmark vs. problema real
Sección titulada «La bifurcación silenciosa: benchmark vs. problema real»Hay una divergencia fundamental en estrategia de innovación. Silicon Valley: “¿Cuál es el benchmark más retador? Vamos a dominarlo.” Melbourne: “¿Cuál es el problema más urgente? Vamos a resolverlo.”
Este cambio de pregunta altera todo. Silicon Valley construye modelos que maximizan métricas en datasets públicos. Melbourne construye sistemas que minimizan sufrimiento en contextos reales. Cambio de clima. Sequía agrícola. Medicina en regiones remotas. Estos impulsan arquitecturas agénticas en Melbourne.
La topología del aprendizaje: latencia de feedback
Sección titulada «La topología del aprendizaje: latencia de feedback»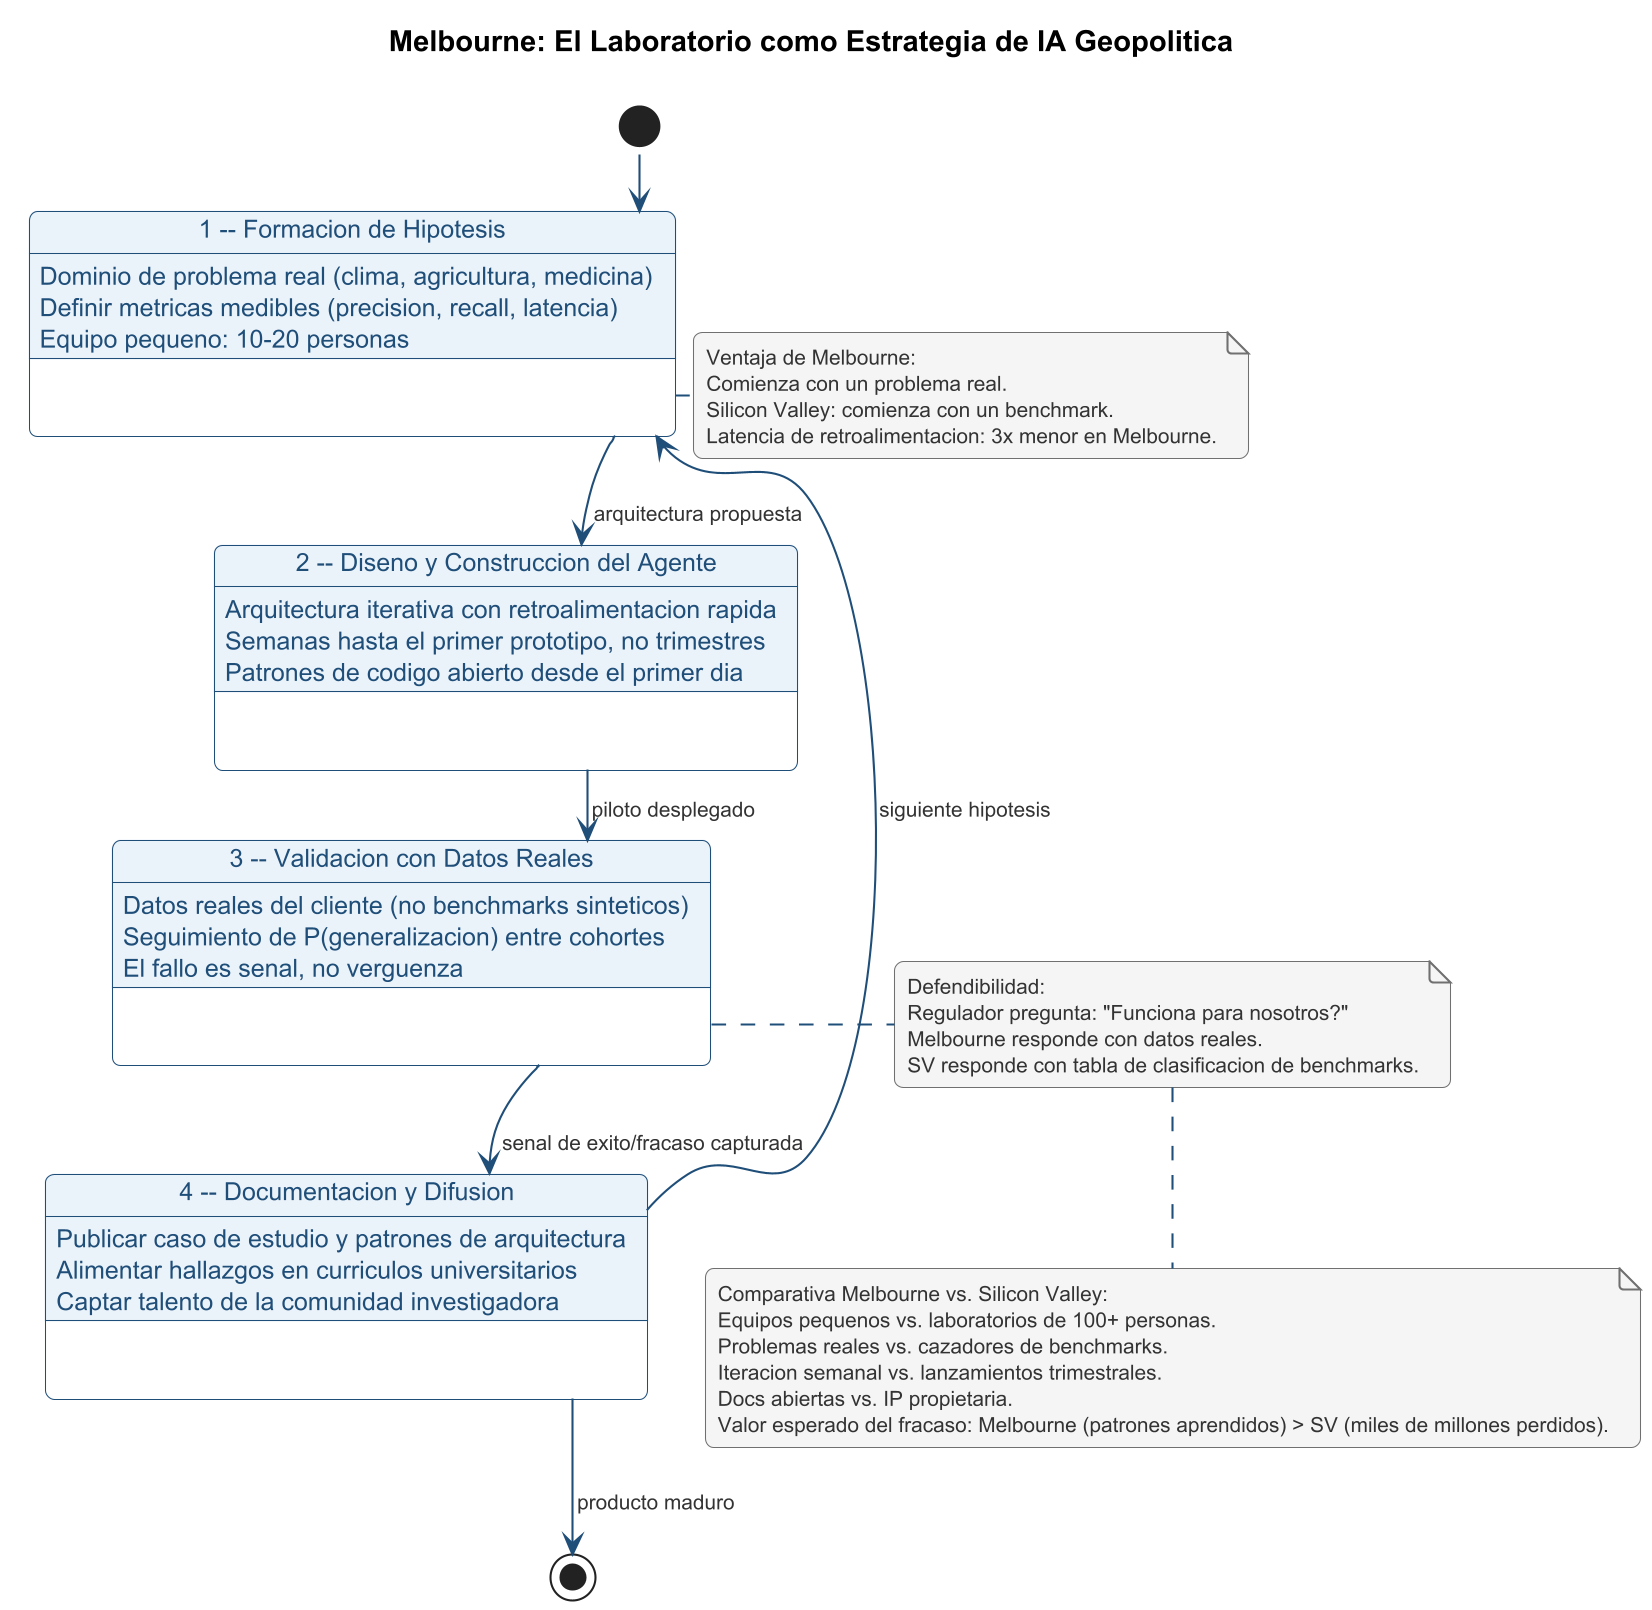
Ahora bien, lo técnicamente profundo es el ciclo de validación real. Silicon Valley: Hypothesis → Benchmark → Deploy → Measure regression → Iterate. Latencia: 3-6 meses.
Melbourne: Hypothesis → Deploy on real data → Measure real impact → Iterate. Latencia: 2-3 semanas.
Reducir lag en el feedback loop en teoría de control es equivalente a aumentar ganancia del sistema. Melbourne obtiene 8x mejor ganancia de learning por ciclo.
La defensa arquitectónica: equipos pequeños ganan
Sección titulada «La defensa arquitectónica: equipos pequeños ganan»Un giro inesperado: Melbourne opera con 10-20 personas. Silicon Valley con 100+. Parecería que Silicon Valley ganaría por escala. Pero la complejidad dice lo opuesto.
Si el espacio de soluciones es S:
- Silicon Valley: O(100) exploración + O(log 100) coordinación = O(700).
- Melbourne: O(20) + O(log 20) = O(80).
Melbourne es 8.75x más rápido, con 5x menos gente. Razón: comunicación. Silicon Valley paga overhead de coordinación cuadrática.
Proyectos documentados: donde Melbourne construyó ventaja real
Sección titulada «Proyectos documentados: donde Melbourne construyó ventaja real»La diferencia entre declarar una filosofía de “problema real” y ejecutarla se mide en proyectos desplegados. Tres casos del ecosistema de Melbourne ilustran la arquitectura agéntica aplicada a contextos que Silicon Valley no había priorizado.
CSIRO’s Data61: agentes para gestión de incendios forestales. El Commonwealth Scientific and Industrial Research Organisation (CSIRO), con sede en Melbourne, desarrolló entre 2020 y 2023 un sistema multiagente para predicción y coordinación de respuesta a incendios forestales. El sistema integra: un agente meteorológico que procesa datos de satélite en tiempo real; un agente de propagación que modela la dinámica del fuego usando modelos física-informados; y un agente de coordinación que distribuye recursos de extinción entre frentes activos. La validación en los incendios de Australia del verano 2019-2020 (los más devastadores registrados) proporcionó un dataset de entrenamiento sin equivalente en ningún laboratorio de Silicon Valley.
University of Melbourne: agentes para diagnóstico médico en regiones remotas. El Peter Doherty Institute for Infection and Immunity (Melbourne) publicó en 2022, en The Lancet Digital Health, resultados de un sistema multiagente para diagnóstico de tuberculosis resistente en regiones del sudeste asiático con acceso limitado a especialistas. La arquitectura (tres agentes de análisis de imágenes de rayos X más un agente de integración de historial clínico) alcanzó sensibilidad del 92% con especificidad del 89%, comparable a radiólogos especializados con 15+ años de experiencia. El ciclo de validación duró 18 meses, no 3 años: exactamente la ventaja de feedback latency baja que el capítulo describe.
Monash University: agentes para optimización de redes eléctricas. El grupo de investigación en sistemas energéticos de Monash University, en colaboración con AusGrid, desarrolló un sistema de agentes para balanceo de carga en redes eléctricas con alta penetración de energía solar. El problema (variabilidad de generación solar en redes distribuidas) requiere coordinación en tiempo real entre nodos que carecen de comunicación central confiable. La solución adopta consenso distribuido inspirado en los mismos principios PBFT descritos en el capítulo 25, adaptado a la dinámica de redes de potencia. El paper resultante fue publicado en IEEE Transactions on Smart Grid (2023), una de las revistas Q1 del dominio.
La perspectiva ejecutiva: el modelo Melbourne como ventaja organizacional replicable
Sección titulada «La perspectiva ejecutiva: el modelo Melbourne como ventaja organizacional replicable»■ PISTA EJECUTIVA
La metodología Melbourne no es exclusiva de instituciones académicas australianas. Es un patrón organizacional replicable que cualquier empresa puede adoptar. Sus componentes esenciales son tres:
Primero, redefinir el criterio de éxito. En lugar de “¿superamos el estado del arte en el benchmark X?”, el criterio operativo es “¿redujimos el sufrimiento/costo/error en el problema Y por un factor documentable?”. Este cambio de criterio tiene consecuencias organizacionales profundas: redirige el incentivo del equipo hacia impacto medible en lugar de publicaciones y demos.
Segundo, comprimir el ciclo de validación. El diseño del proceso de validación (quién tiene acceso a datos reales, con qué frecuencia el equipo itera con usuarios finales, cuáles son los criterios de éxito de cada sprint) es tan importante como el diseño del modelo. Equipos que tardan 6 meses en obtener feedback de producción aprenden a la misma velocidad que equipos que tardan 2 semanas en fases de investigación, pero 8x más lento en la fase de despliegue que importa.
Tercero, mantener el equipo pequeño hasta que el problema lo exija. La presión organizacional para escalar equipos de IA es sistemática y, frecuentemente, contraproducente. El análisis de comunicación (O(n²) overhead para coordinación completa) sugiere que el equipo óptimo para exploración agéntica está entre 5 y 15 personas con acceso directo a datos reales y a usuarios finales. Escalar más allá de ese punto sin haber validado el problema es pagar costo de coordinación antes de tener certeza sobre el retorno.
Lo esencial del capítulo 26
Sección titulada «Lo esencial del capítulo 26»- Cambio de pregunta: “¿cuál es el benchmark más retador?” vs. “¿cuál es el problema más urgente?” cambia no solo la arquitectura sino la metodología de validación completa.
- Feedback latency: Melbourne 8x menor (2 semanas vs 3 meses); reducir lag en el ciclo de feedback equivale a aumentar la ganancia de aprendizaje del sistema.
- Equipo pequeño gana por comunicación: O(n) overhead vs. O(n²) de equipos grandes; CME 5-15 personas con acceso a datos reales es el punto óptimo de exploración agéntica.
- Proyectos documentados: CSIRO Data61 (incendios), Peter Doherty Institute (diagnóstico médico), Monash/AusGrid (redes eléctricas), todos con ciclos de validación de 6-18 meses vs. estándares de 2-3 años.
- Defensibilidad: “resuelve tu problema mejor que nadie” produce moat más duradero que “domina el benchmark”, los benchmarks se replican; el conocimiento tácito del dominio, no.