Capítulo 7: Arquitectura event-driven, Kafka como sistema nervioso
De llamadas a eventos
Sección titulada «De llamadas a eventos»Todo lo construido hasta aquí conecta agentes mediante llamadas: el orquestador invoca, espera y compone (capítulo 8). Ese modelo es correcto dentro de un pipeline; se queda corto cuando los agentes deben integrarse a la escala del sistema completo: decenas de servicios, equipos y ritmos distintos. Para eso la industria convergió hace una década en la arquitectura orientada a eventos: los servicios no se llaman entre sí; publican hechos («se abrió el PR 482», «el ticket 1043 cambió a urgente») en un log inmutable y ordenado, y quien necesita reaccionar, se suscribe. El log como fuente de verdad, no como subproducto, es la idea central que Kleppmann (2017) sitúa en el corazón de los sistemas intensivos en datos, y el desacoplamiento temporal que ofrece es la herramienta más eficaz contra el acoplamiento que arruina las arquitecturas de microservicios (Newman, 2021). Apache Kafka es su implementación dominante (Apache Software Foundation, s.f.); los principios valen para cualquier broker equivalente.
Para la Empresa Sintética, el modelo de eventos no es un refinamiento: resuelve cuatro problemas que el modelo de llamadas no puede resolver bien:
- Desacoplamiento temporal. El agente revisor tarda dos minutos; el servicio que publicó «PR abierto» no espera ni sabe que existe un revisor. Los picos se absorben en el log, no en timeouts.
- Tolerancia a fallos con reintento honesto. Si el agente falla a mitad de tarea, el evento sigue en el log: otro consumidor lo retoma. Las llamadas perdidas, en cambio, se pierden con su contexto.
- Replay: el regalo inesperado para los evals. Un log retenido es un conjunto de evaluación que se escribe solo (capítulo 13): reproduzca la semana pasada de eventos reales contra la versión candidata del agente y compare resultados con la versión en producción, sin tocar producción. Ningún sistema de llamadas ofrece esto gratis.
- Auditoría estructural. El registro inmutable de qué ocurrió y qué hizo cada agente (la exigencia de los capítulos 14 y 19) deja de ser un componente aparte: es el propio medio de transporte.
El flujo CDC → Agente → Consumidores
Sección titulada «El flujo CDC → Agente → Consumidores»La arquitectura event-driven dibuja una secuencia clara en el tiempo: cambios ocurren en sistemas fuente (una base de datos, un formulario, una API), se capturan como eventos en el log, y los agentes los consumen cuando les toca su turno. La dimensión que importa es el tiempo: cuánto tarda cada paso, cómo se desacoplan, dónde se genera latencia.
Justificación de diseño: diagrama de secuencia para modelado de interacción
En arquitectura event-driven, lo crítico es el orden temporal de los eventos y el desacoplamiento en el tiempo entre publicador y consumidor. Un diagrama de secuencia revela exactamente eso: quién publica, cuándo, quién consume, con qué latencia.
Un diagrama de componentes mostraría dónde viven los servicios; un diagrama de clases mostraría sus internales. Aquí necesitamos ver el flujo de un evento a través del sistema en el tiempo, la dimensión que explica backpressure, desacoplamiento y cómo un agente lento NO bloquea a los publicadores.
En este libro reaparece el diagrama de secuencia en el Capítulo 3 (el AI Gateway, que también es un flujo temporal), donde el tiempo y el costo acumulado son el mensaje central.
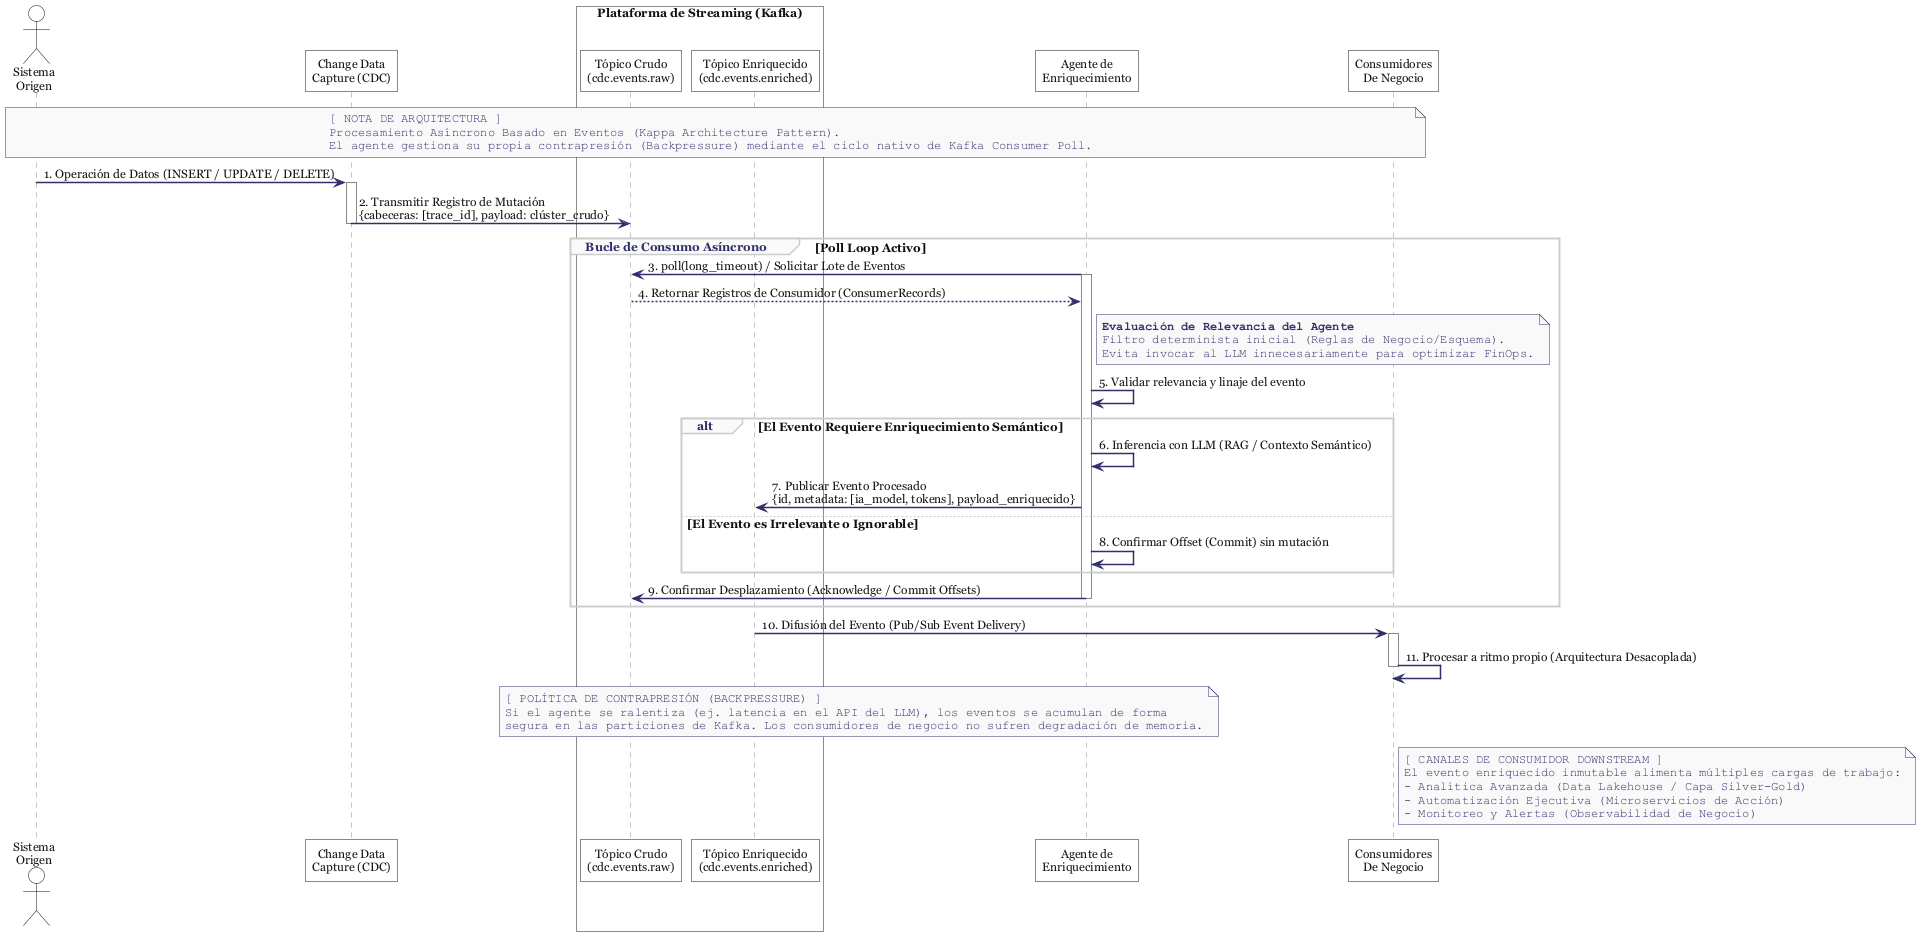
Nótese la propiedad fundamental que el diagrama revela: el agente NO bloquea al sistema fuente. Un cambio ocurre, se publica, continúa el flujo normal del negocio. Por ejemplo, si el agente tarda dos minutos, ya habrán sucedido cientos de otros cambios en el log. El desacoplamiento temporal es lo que la convierte en una arquitectura de escala.
► PISTA TÉCNICA: agentes como ciudadanos del log
// Ejemplo 7.1 (Node.js + kafkajs): el agente revisor como consumidor.// El evento dispara el caso de uso del capítulo 6; el resultado se// publica como nuevo hecho. Nadie llama a nadie.
import { Kafka } from "kafkajs";import { RevisarCodigoUseCase } from "./domain/revisar-codigo";
const kafka = new Kafka({ clientId: "agente-revisor",                          brokers: [process.env.KAFKA_BROKER!] });const consumer = kafka.consumer({ groupId: "code-review-agents" });const producer = kafka.producer();
export async function main(useCase: RevisarCodigoUseCase) {  await consumer.connect();  await producer.connect();  await consumer.subscribe({ topic: "pull-requests.opened" });
  await consumer.run({    eachMessage: async ({ message }) => {      const evento = JSON.parse(message.value!.toString());
      // Idempotencia: el log entrega "al menos una vez"; el agente      // debe tolerar duplicados (mismo principio del ejercicio 7.1).      if (await yaRevisado(evento.prId, evento.headSha)) return;
      const revision = await useCase.ejecutar(evento.diff);
      await producer.send({        topic: "pull-requests.reviewed",        messages: [{          key: String(evento.prId),        // misma clave => mismo orden          value: JSON.stringify({            prId: evento.prId,            headSha: evento.headSha,            veredicto: revision.veredicto,            hallazgos: revision.hallazgos,            costoUsd: revision.costoUsd,    // el CIU viaja con el hecho            agente: "reviewer-v3",          // versión del prompt: auditoría          }),        }],      });    },  });}
// Ejemplo 7.2 (Java, Spring Kafka): el mismo ciudadano, en el otro idioma.@Componentpublic class RevisionListener {
private final RevisarCodigoUseCase useCase; private final KafkaTemplate<String, RevisionEvent> kafka;
public RevisionListener(RevisarCodigoUseCase useCase, KafkaTemplate<String, RevisionEvent> kafka) { this.useCase = useCase; this.kafka = kafka; }
@KafkaListener(topics = "pull-requests.opened", groupId = "code-review-agents") public void onPrOpened(PrOpenedEvent evento) { if (yaRevisado(evento.prId(), evento.headSha())) return; // idempotencia var revision = useCase.ejecutar(evento.diff()); kafka.send("pull-requests.reviewed", String.valueOf(evento.prId()), RevisionEvent.de(evento, revision, "reviewer-v3")); }}Cuatro decisiones de este código son doctrina, no estilo. En primer lugar, la clave de partición (prId) garantiza que los eventos del mismo PR se procesen en orden; el orden global no existe en un log particionado y perseguirlo es el error de novato. En segundo lugar, la idempotencia en el consumidor es obligatoria porque el log entrega «al menos una vez»; un agente sin ella es el generador de cincuenta tickets duplicados del ejercicio 7.1. Además, el esquema del evento es un contrato: exactamente el contrato del prompt maestro (capítulo 5) elevado a la frontera entre servicios; se gobierna con un registro de esquemas y evoluciona hacia atrás-compatible. Finalmente, los eventos fallidos van a una cola de mensajes muertos (DLQ) con su contexto completo: la DLQ de un sistema agéntico es oro puro, cada mensaje muerto es un caso difícil real para la suite de evals.
Por último, una advertencia de costos cierra la pista técnica: el desacoplamiento hace invisible el consumo, nadie «ve» al agente trabajar, solo al log crecer. El presupuesto del capítulo 11 se aplica al consumidor: límite de gasto por ventana de tiempo y pausa del grupo de consumidores al excederlo. Un agente suscrito a un topic con picos es Token-Burn con autoservicio.
Reactividad y backpressure: el agente como consumidor sostenible
Sección titulada «Reactividad y backpressure: el agente como consumidor sostenible»Ahora bien, esa advertencia abre la pregunta que cierra el capítulo: ¿qué pasa cuando el log emite más rápido de lo que el agente puede consumir? El topic escupe miles de eventos por segundo; el agente, atado a la latencia de una llamada al modelo, procesa decenas. Sin un mecanismo que regule el ritmo, los búferes se llenan, la memoria se agota y el servicio cae, y, antes de caer, quema tokens en eventos que un sistema saturado terminará descartando. La respuesta de la ingeniería de sistemas a este problema tiene nombre: backpressure (contrapresión), la capacidad del consumidor de decirle al productor «más despacio» en lugar de ahogarse en silencio (Bonér et al., 2014).
Aquí conviene la distinción que el capítulo 1 anticipó: la reactividad del agente (reaccionar a una observación) no es la reactividad de los sistemas (gobernar flujos asíncronos con contrapresión). Esta segunda es el sustrato sobre el que vive el agente-consumidor, y el autor la desarrolló en obra previa con una tesis que es, palabra por palabra, la de este libro: adoptar la reactividad de forma selectiva y medida, no por moda (véase «Obra pública del autor»). Sus lecciones aplican directamente al ciudadano del log:
- El backpressure no es opcional; es la diferencia entre degradar y caer. Un consumidor reactivo limita su tasa de admisión (
limitRate) y su concurrencia (cuántos eventos procesa en paralelo) para que el ritmo lo marque el eslabón más lento (el modelo), no el más rápido (el broker). Es la misma idea que la pausa del grupo de consumidores del párrafo anterior, expresada como propiedad continua del flujo en lugar de como un interruptor de emergencia. - La consistencia bajo fallo se diseña, no se espera. Cuando un consumidor actualiza la base y luego publica un evento, el fallo entre ambos pasos deja el sistema inconsistente; el patrón Saga con transacciones compensatorias (capítulo 8) es la respuesta reactiva canónica, y la DLQ con contexto es su red de seguridad.
- El criterio de adopción es el del libro entero: ¿qué falla si no usamos reactividad aquí? Para un consumidor de bajo volumen, un bucle imperativo simple es más legible y igual de correcto; la programación reactiva plena (flujos, operadores,
Mono/Flux) añade una carga cognitiva que solo se paga cuando la concurrencia o la latencia la justifican. Una arquitectura híbrida (módulos reactivos donde el flujo lo exige, imperativos donde no) suele ser la decisión madura.
La síntesis con la economía del token es la lección que el agente hereda del sistema reactivo: en reactividad, más rápido no es mejor; lo sostenible es mejor. Un agente que consume tan rápido como el log produce no es eficiente: es un incidente (de saturación y de facturación) esperando su pico de tráfico. El backpressure es, a la vez, el guardarraíl de disponibilidad del capítulo 8 y el de presupuesto del capítulo 11, escritos como una sola propiedad del flujo.
Caso de estudio: del sincronizador por lotes al flujo con enriquecimiento agéntico
Sección titulada «Caso de estudio: del sincronizador por lotes al flujo con enriquecimiento agéntico»(Evolución de un caso de arquitectura publicado previamente por el autor; véase «Obra pública del autor». Cifras ilustrativas.)
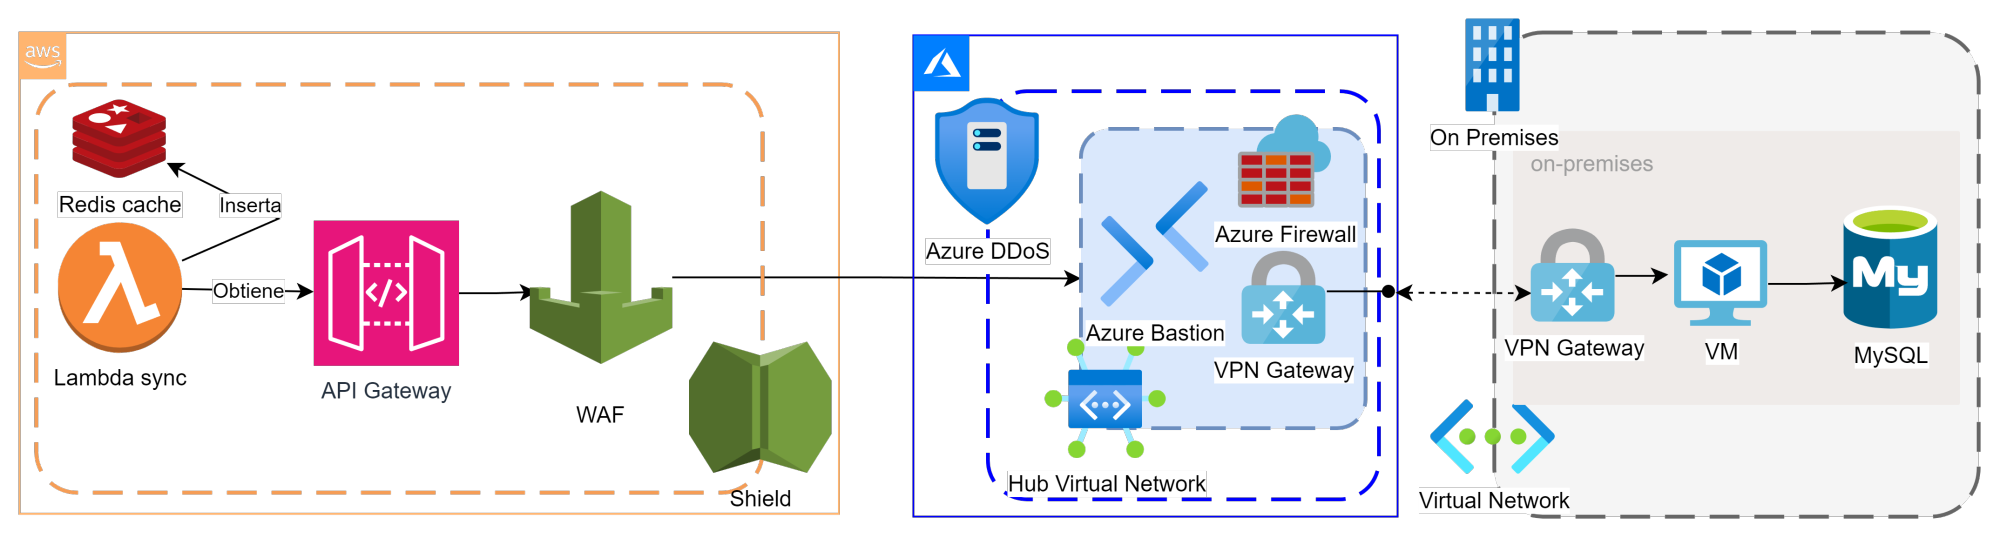
El diagrama es el caso en su forma original, antes de la simplificación que propone este capítulo, y vale leerlo como tal: cada componente resuelve un problema real (el entorno PCI aísla el dato sensible; Kafka desacopla los dos stacks; el patrón Saga del capítulo 8 mantiene la consistencia a través de servicios sin transacción distribuida; el Circuit Breaker corta la cascada de fallos; el Event Store conserva la historia para reconstruir estado). Pero leídos juntos cuentan también la otra cara: esa resiliencia tiene un precio operativo y cognitivo que solo se justifica si la latencia de minutos del lote de verdad duele. El capítulo no descarta esta arquitectura; la usa como punto de partida honesto para preguntar qué parte de su complejidad es esencial y cuál es accidental cuando lo único que se necesita es que la caché vea el cambio en segundos.
El punto de partida es un sincronizador clásico: una función serverless consulta periódicamente MySQL, compara con la caché Redis y actualiza las diferencias, lotes, flujo unidireccional, auditoría propia. Funciona, y su autor documentó con honestidad sus límites: latencia de minutos entre el cambio y su visibilidad, y una complejidad operativa multi-nube cuyo costo mensual se midió en cientos de dólares.
La evolución event-driven invierte la mecánica: los cambios de la base se capturan como eventos (CDC, change data capture) y fluyen por el log; la caché es un consumidor más que se actualiza en segundos. Y aquí aparece la oportunidad agéntica que el lote hacía impensable: un agente enriquecedor como consumidor intermedio, que clasifica cada cambio, detecta anomalías contra los invariantes del dominio (capítulo 6) y publica el evento enriquecido para la caché y para el dashboard de operaciones. El patrón es general y reutilizable: CDC → agente económico de enriquecimiento → consumidores, con el agente operando sobre el flujo sin tocar ni la base ni la caché; mínimo privilegio estructural (capítulo 4) por construcción.
La moraleja del caso, fiel a su original: la versión event-driven no es «mejor» en abstracto; es mejor si la latencia de minutos duele y si el equipo puede operar un broker. La arquitectura se elige con el árbol de decisión y la cuenta en la mesa (capítulo 8), no con el entusiasmo del diagrama.
Arquitectura híbrida: agentes en la frontera entre cloud y on-premise
Sección titulada «Arquitectura híbrida: agentes en la frontera entre cloud y on-premise»Cuando los agentes deben orquestar flujos que involucran tanto sistemas en la nube (infraestructura moderna, escalable) como datos sensibles en on-premise (bases de datos de clientes, registros históricos de transacciones), emerge un desafío arquitectónico que las arquitecturas puramente cloud o puramente locales no resuelven: cómo mantener la seguridad, el desacoplamiento y la gobernanza cuando los datos críticos nunca abandonan el perímetro de la organización, pero los agentes viven en la nube.
En primer lugar, el principio rector es el Zero-Trust perimetral: ningún componente confía en que otro está “adentro” o “afuera” simplemente por su ubicación física. Cada frontera (entre la nube y on-premise, entre microservicios) exige autenticación, autorización y cifrado. Para los agentes, esto significa que el acceso a sistemas on-premise no viaja a través del modelo, sino a través de una pasarela de VPN (Virtual Private Network) que intercepta, valida y registra cada solicitud antes de permitirla.
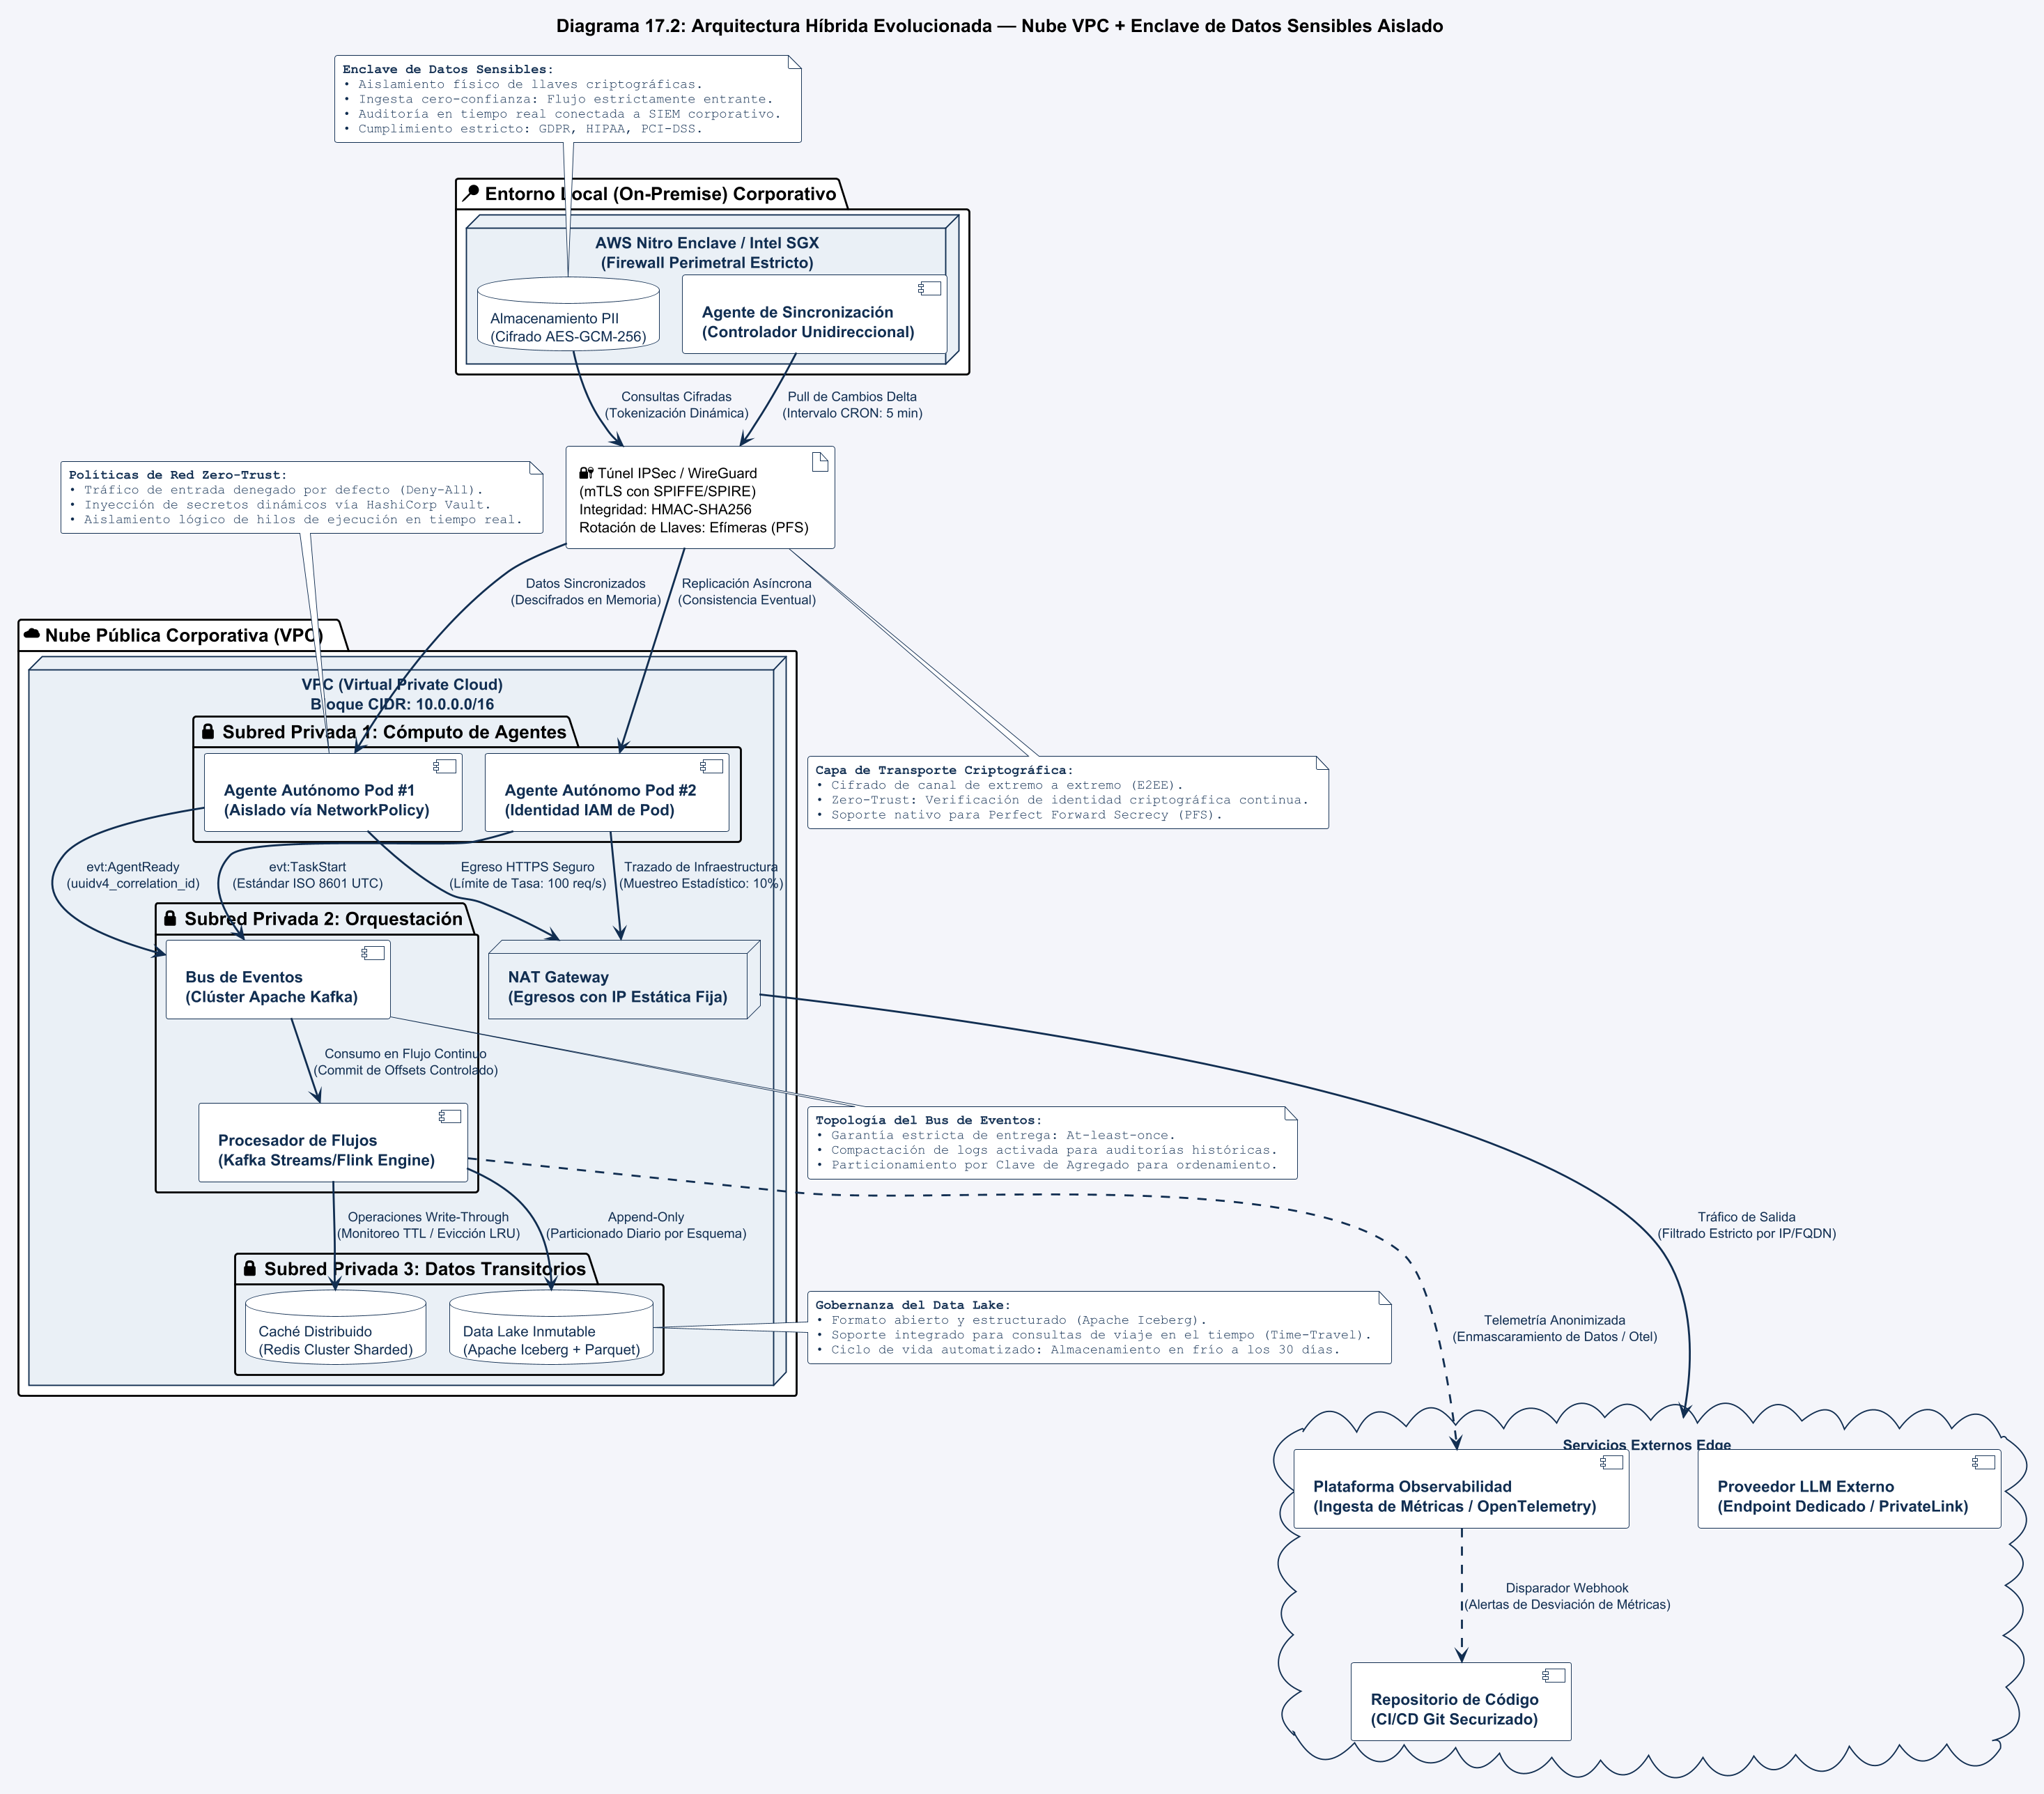
La topología que el diagrama codifica resuelve cuatro desafíos de forma simultánea:
Aislamiento de red por capas. El API Gateway (en el edge de la nube) es el único punto de entrada público; expone solo lo que la organización decide exponer. Detrás de él, una VPC (Virtual Private Cloud) agrupa los componentes agénticos en subredes privadas donde ninguna solicitud entrante puede llegar sin pasar por el Gateway. A continuación de eso, los túneles VPN hacia on-premise son los únicos canales permitidos para datos sensibles. La consecuencia: incluso si un agente es comprometido, su acceso a la base de datos no puede ocurrir sin atravesar un firewall específico que puede detectar, bloquear y registrar el intento.
A continuación, la separación de responsabilidades mediante colas. Los agentes que procesan datos sensibles nunca los almacenan en su contexto local; los reciben como resultado de una consulta, los procesan, y publican eventos enriquecidos en un bus (Kafka, o cualquier broker). Esos eventos viajan de vuelta a través de la VPN con un envelope de metadatos que declara qué agente ejecutó qué operación, cuándo y con qué costo. La auditoría es incorporada al flujo, no un “sistema de logs” separado que nadie mantiene.
Primero, el control de acceso granular en los adaptadores. El agente no obtiene credenciales de “usuario de base de datos con acceso total”; obtiene un token rotatorio de corta vida que le concede acceso a exactamente las tablas y operaciones que esa tarea específica necesita. En el servidor MCP (capítulo 9) que expone las herramientas, el validador rechaza cualquier consulta que no esté dentro de ese scope. La máquina de estados del agente (capítulo 8) registra cada transición, incluidas las rechazadas; esa traza es la base de cualquier auditoría de compliance.
Además, la gobernanza del lado del consumidor es no-negociable. Cuando un evento llega a la DLQ (Dead Letter Queue) por consistencia, contiene el contexto completo: qué agente lo intentó, con qué parámetros, por qué falló. Un auditor o un incident responder pueden reproducir exactamente qué ocurrió, en qué paso falló la seguridad o los invariantes, y si es necesario, recuperar el sistema sin perder la traza de auditoría.
► PISTA TÉCNICA: Túnel VPN seguro en TypeScript
// Cliente MCP que se conecta a través de un túnel VPN seguro hacia// sistemas on-premise. El túnel es el único canal de comunicación;// el agente no debe conocer de encriptación, certificados, o red.
import TunnelClient from "@secure-tunnel/client";import { LlmPort } from "./types";
class SecureOnPremiseAdapter implements LlmPort {  private tunnel: TunnelClient;
  constructor(    vpnGatewayUrl: string,    clientCertPath: string,    clientKeyPath: string  ) {    // Validación estricta del certificado: falla si no es válido    this.tunnel = new TunnelClient({      serverUrl: vpnGatewayUrl,      clientCert: require("fs").readFileSync(clientCertPath),      clientKey: require("fs").readFileSync(clientKeyPath),      tlsValidation: "strict", // No permitas self-signed en producción      maxRetries: 3,      retryBackoff: 2000, // 2 segundos, exponencial    });
    // Log de conexión establecida: auditabilidad    this.tunnel.on("connected", () => {      console.log(        JSON.stringify({          event: "vpn_tunnel_established",          timestamp: new Date().toISOString(),          gateway: vpnGatewayUrl,        })      );    });
    this.tunnel.on("disconnected", () => {      console.error(        JSON.stringify({          event: "vpn_tunnel_disconnected",          timestamp: new Date().toISOString(),          action: "agent_will_fail_gracefully",        })      );    });  }
  async queryOnPremiseDatabase(    query: string,    timeout: number = 30000  ): Promise<any[]> {    if (!query.toUpperCase().startsWith("SELECT")) {      throw new Error("Solo se permiten operaciones de lectura.");    }
    try {      // El túnel es la única forma de acceder a la base de datos.      // El agente no tiene IP directa a on-premise.      const result = await this.tunnel.request({        service: "database",        operation: "query",        payload: { query },        timeout,      });
      // Cada respuesta trae su envelope de auditoría      console.log(        JSON.stringify({          event: "secure_query_executed",          timestamp: new Date().toISOString(),          query_checksum: hashQuery(query),          rows_returned: result.data?.length || 0,          execution_time_ms: result.executionTime,          tunnel_metadata: result.tunnelMetadata, // quién lo ejecutó, cuándo        })      );
      return result.data;    } catch (error) {      // Error en el túnel: el agente no reintentar, fallará.      // La DLQ capturará el evento para revisión humana.      throw new Error(        `Secure query failed: ${error.message}. ` +        `Tunnel may be down. Escalate to on-premise team.`      );    }  }}
Este adaptador encapsula la seguridad del túnel; el agente que lo use simplemente llama a queryOnPremiseDatabase(query) sin saber que hay una VPN, certificados o retransmisiones. Esa abstracción es el puerto del capítulo 6 aplicado a infraestructura.
Ejercicio resuelto 7.1: los topics del triaje de tickets
Sección titulada «Ejercicio resuelto 7.1: los topics del triaje de tickets»Enunciado. Lleve el pipeline de triaje del ejercicio 7.1 (500 tickets/día) a eventos: defina topics, claves de partición, política de reintentos y dónde corta el presupuesto.
Solución comentada. Tres topics siguen a los tres roles (tickets.received → tickets.classified → tickets.drafted) y un cuarto transversal: tickets.dlq. La clave de partición es ticketId en toda la cadena: el mismo ticket, siempre en orden, y el paralelismo se gradúa con particiones (con 500/día, 3 particiones sobran; la cifra correcta la dará el percentil de latencia, no la intuición). Reintentos: 3 con retroceso exponencial en el consumidor y, al agotarse, el mensaje íntegro (con la respuesta del modelo que falló) a la DLQ; revisión humana semanal de la DLQ alimenta la suite de evals con los casos que más enseñan. El presupuesto corta en el consumidor del rol redactor (el único de gama balanceada): si el gasto por hora excede el umbral del CIUTracker (capítulo 11), el grupo se pausa y alerta; los tickets esperan en el log sin perderse, que es exactamente la diferencia entre degradar y fallar. Y el detalle final que conecta las tres partes del libro: el topic tickets.drafted retenido 30 días es el conjunto de evaluación del próximo cambio de prompt.
Lo esencial del capítulo 7
Sección titulada «Lo esencial del capítulo 7»- Eventos en lugar de llamadas: el log inmutable como fuente de verdad (Kleppmann, 2017) desacopla tiempos, equipos y fallos (Newman, 2021).
- Un agente event-driven es consumidor y productor: clave de partición pensada, idempotencia obligatoria, esquema como contrato, DLQ con contexto.
- El replay del log es la suite de evals que se escribe sola; la DLQ, su capítulo de casos difíciles.
- El desacoplamiento esconde el costo: presupuesto y pausa del consumidor, o Token-Burn con autoservicio.
- CDC → agente enriquecedor → consumidores: el patrón que convierte un sincronizador por lotes en un flujo con inteligencia, sin tocar los sistemas de origen.
- Arquitectura híbrida segura: agentes en la nube, datos sensibles on-premise. Zero-Trust perimetral en cada frontera, túneles VPN como único canal hacia sistemas críticos, adaptadores que encapsulan seguridad para que el agente desconozca certificados, retransmisiones o detalles de red.
- Auditoría incorporada al flujo: cada transición, cada consulta a on-premise, cada evento fallido registra quién, cuándo y por qué. La DLQ no es un fondo de saco; es la entrada a revisión humana y a nuevos casos de eval.
- Backpressure: el consumidor marca el ritmo, no el broker (Bonér et al., 2014). Reactividad selectiva, no por moda; el criterio es «¿qué falla si no la usamos aquí?». Más rápido no es mejor; lo sostenible lo es.