Capítulo 9: La semana del coverage, Trabajar con Claude en un proyecto real
El punto de partida: un martes con fecha límite
Sección titulada «El punto de partida: un martes con fecha límite»El martes me llegó el mensaje que ningún ingeniero quiere recibir a mitad de un sprint: “Revisión de calidad la próxima semana. Coverage tiene que estar por encima del 80 % y los issues en cero. Todos los issues.”
El proyecto era un sistema de gestión de inventario y pagos heredado: Spring Boot 3.2 en el backend, Angular 17 en el frontend, PostgreSQL como base de datos. Cuatro años de código, tres equipos que habían rotado, y un historial de “lo arreglamos después” que nadie había honrado. El reporte de JaCoCo decía 38 %. Había 23 issues abiertos en el tracker, la mayoría errores de validación que nadie podía cerrar porque el código no tenía tests, y cualquier cambio podía romper algo sin que nadie lo supiera.
Tenía cuatro días y medio.
Este capítulo es el diario de esa semana: todos los comandos, todos los prompts, lo que funcionó y lo que no, y cuánto costó en tokens. Al final del viernes, el coverage estaba en 82.3 % y el issues tracker en cero. Lo que sigue es exactamente cómo llegamos ahí.
Nota de costos: los precios de la API son los del apéndice B, con su fecha de corte. Este capítulo no los repite: los lee de allí, y un solo lugar donde actualizar precios es lo que evita que este capítulo y el apéndice se contradigan en la tercera edición. Los cálculos de esta semana también aplican a la suscripción de consumo, que ofrece un techo mensual en lugar de un coste por llamada: conveniente para el trabajo diario, pero sin la granularidad de saber qué gastaste en qué. Esa granularidad es la que exige la métrica CIU del capítulo 1.
9.1 Antes de generar un solo test: leer el terreno
Sección titulada «9.1 Antes de generar un solo test: leer el terreno»El primer error que comete la mayoría de los equipos cuando la IA entra en escena es usarla inmediatamente, sin entender el problema. El modelo no sabe nada de tu proyecto; lo que no le das en contexto, lo inventa. Y un test inventado que pasa no es un test: es una deuda técnica disfrazada de métrica verde.
El diagnóstico primero, la generación después.
► PISTA TÉCNICA: Diagnóstico inicial con JaCoCo
# 1. Generar el reporte de coberturamvn clean verify -pl backend
# El reporte queda en:#   backend/target/site/jacoco/index.html## Lo que buscar en el reporte:#   - Columna "Missed Branches": los if/switch sin cubrir#   - Clases con 0 % de coverage: las que nunca se tocaron#   - Paquetes con coverage < 40 %: candidatos a refactor
# 2. Exportar el resumen a CSV para leerlo en Claudemvn jacoco:reportcat backend/target/site/jacoco/jacoco.csv | head -50
Con el reporte en mano, la imagen era clara: el paquete application/ (servicios de negocio) tenía 12 % de coverage porque nadie había escrito un solo test de unidad para los servicios. El paquete domain/ tenía 0 %. El api/ (controladores) tenía 67 % gracias a unos tests de integración del año anterior que alguien había dejado a medias.
La distribución del problema determina la distribución del esfuerzo.
9.2 El CLAUDE.md del proyecto: el ancla que lo hace posible
Sección titulada «9.2 El CLAUDE.md del proyecto: el ancla que lo hace posible»El capítulo 6 explicó que el CLAUDE.md es el equivalente operativo del contexto estable de tu agente: lo que no tienes que repetir en cada prompt porque el modelo ya lo sabe. Para una semana de trabajo intenso, ese archivo no es una comodidad; es la diferencia entre tests que encajan en tu arquitectura y tests que hay que tirar porque usaron las dependencias equivocadas.
Este fue el CLAUDE.md que creé el lunes a primera hora, antes de mandar el primer prompt:
► PISTA TÉCNICA: CLAUDE.md para un proyecto Spring Boot / Angular
# PayTrack — Contexto de proyecto para Claude
## Stack técnico- **Backend:** Java 17, Spring Boot 3.2, JPA/Hibernate 6, PostgreSQL 15- **Frontend:** Angular 17, TypeScript 5.2, Jest 29, Angular Testing Library- **Tests backend:** JUnit 5, Mockito 5, Testcontainers 1.19- **Coverage:** JaCoCo 0.8.11; umbral de merge: 80 %- **Build:** Maven 3.9; `mvn test` para unitarios, `mvn verify` para integración
## Estructura de paquetes (backend)src/main/java/com/empresa/paytrack/├── domain/        # Entidades y value objects — SIN dependencias de Spring├── application/   # Servicios de aplicación — lógica de negocio pura├── infrastructure/# Repositorios JPA, clientes Kafka, S3└── api/           # Controladores REST y DTOs — validación de entrada
## Convenciones de test que DEBES respetar- Nombre de clase: `ClaseAProbarTest.java` (unit), `*IT.java` (integración)- Un @Test por comportamiento observable, NO por método público- Mockito: solo para dependencias externas a la clase bajo prueba- Testcontainers: SOLO cuando el test verifica comportamiento de BD real- NUNCA usar Thread.sleep() — usar CompletableFuture.get(timeout) o Awaitility- AssertJ para aserciones (ya en el classpath), NO JUnit Assertions directas- Angular: NO usar `any` en TypeScript de specs; tipar siempre
## Antipatrones prohibidos- Test que no falla nunca (sin assertThat o verify significativo)- @Disabled sin número de ticket en el comentario: @Disabled("PAYTRACK-1234")- Mock de la clase bajo prueba (testDouble de sí misma)- Hardcodear localhost o puertos en tests de integración — usar @DynamicPropertySource
## Comandos clavemvn jacoco:report                           # genera target/site/jacoco/index.htmlmvn test -Dtest=PagoServiceTest             # ejecuta un solo test de backendng test --include='**/pago*' --watch=false  # ejecuta specs de Angular filtradas
Con ese archivo en el repositorio, cada interacción con Claude Code hereda automáticamente las convenciones. Si mandas un prompt sin mencionar Mockito ni AssertJ, el modelo los usa de todas formas porque el CLAUDE.md ya los estableció como estándar del proyecto.
9.3 La estrategia económica: el modelo correcto para cada tarea
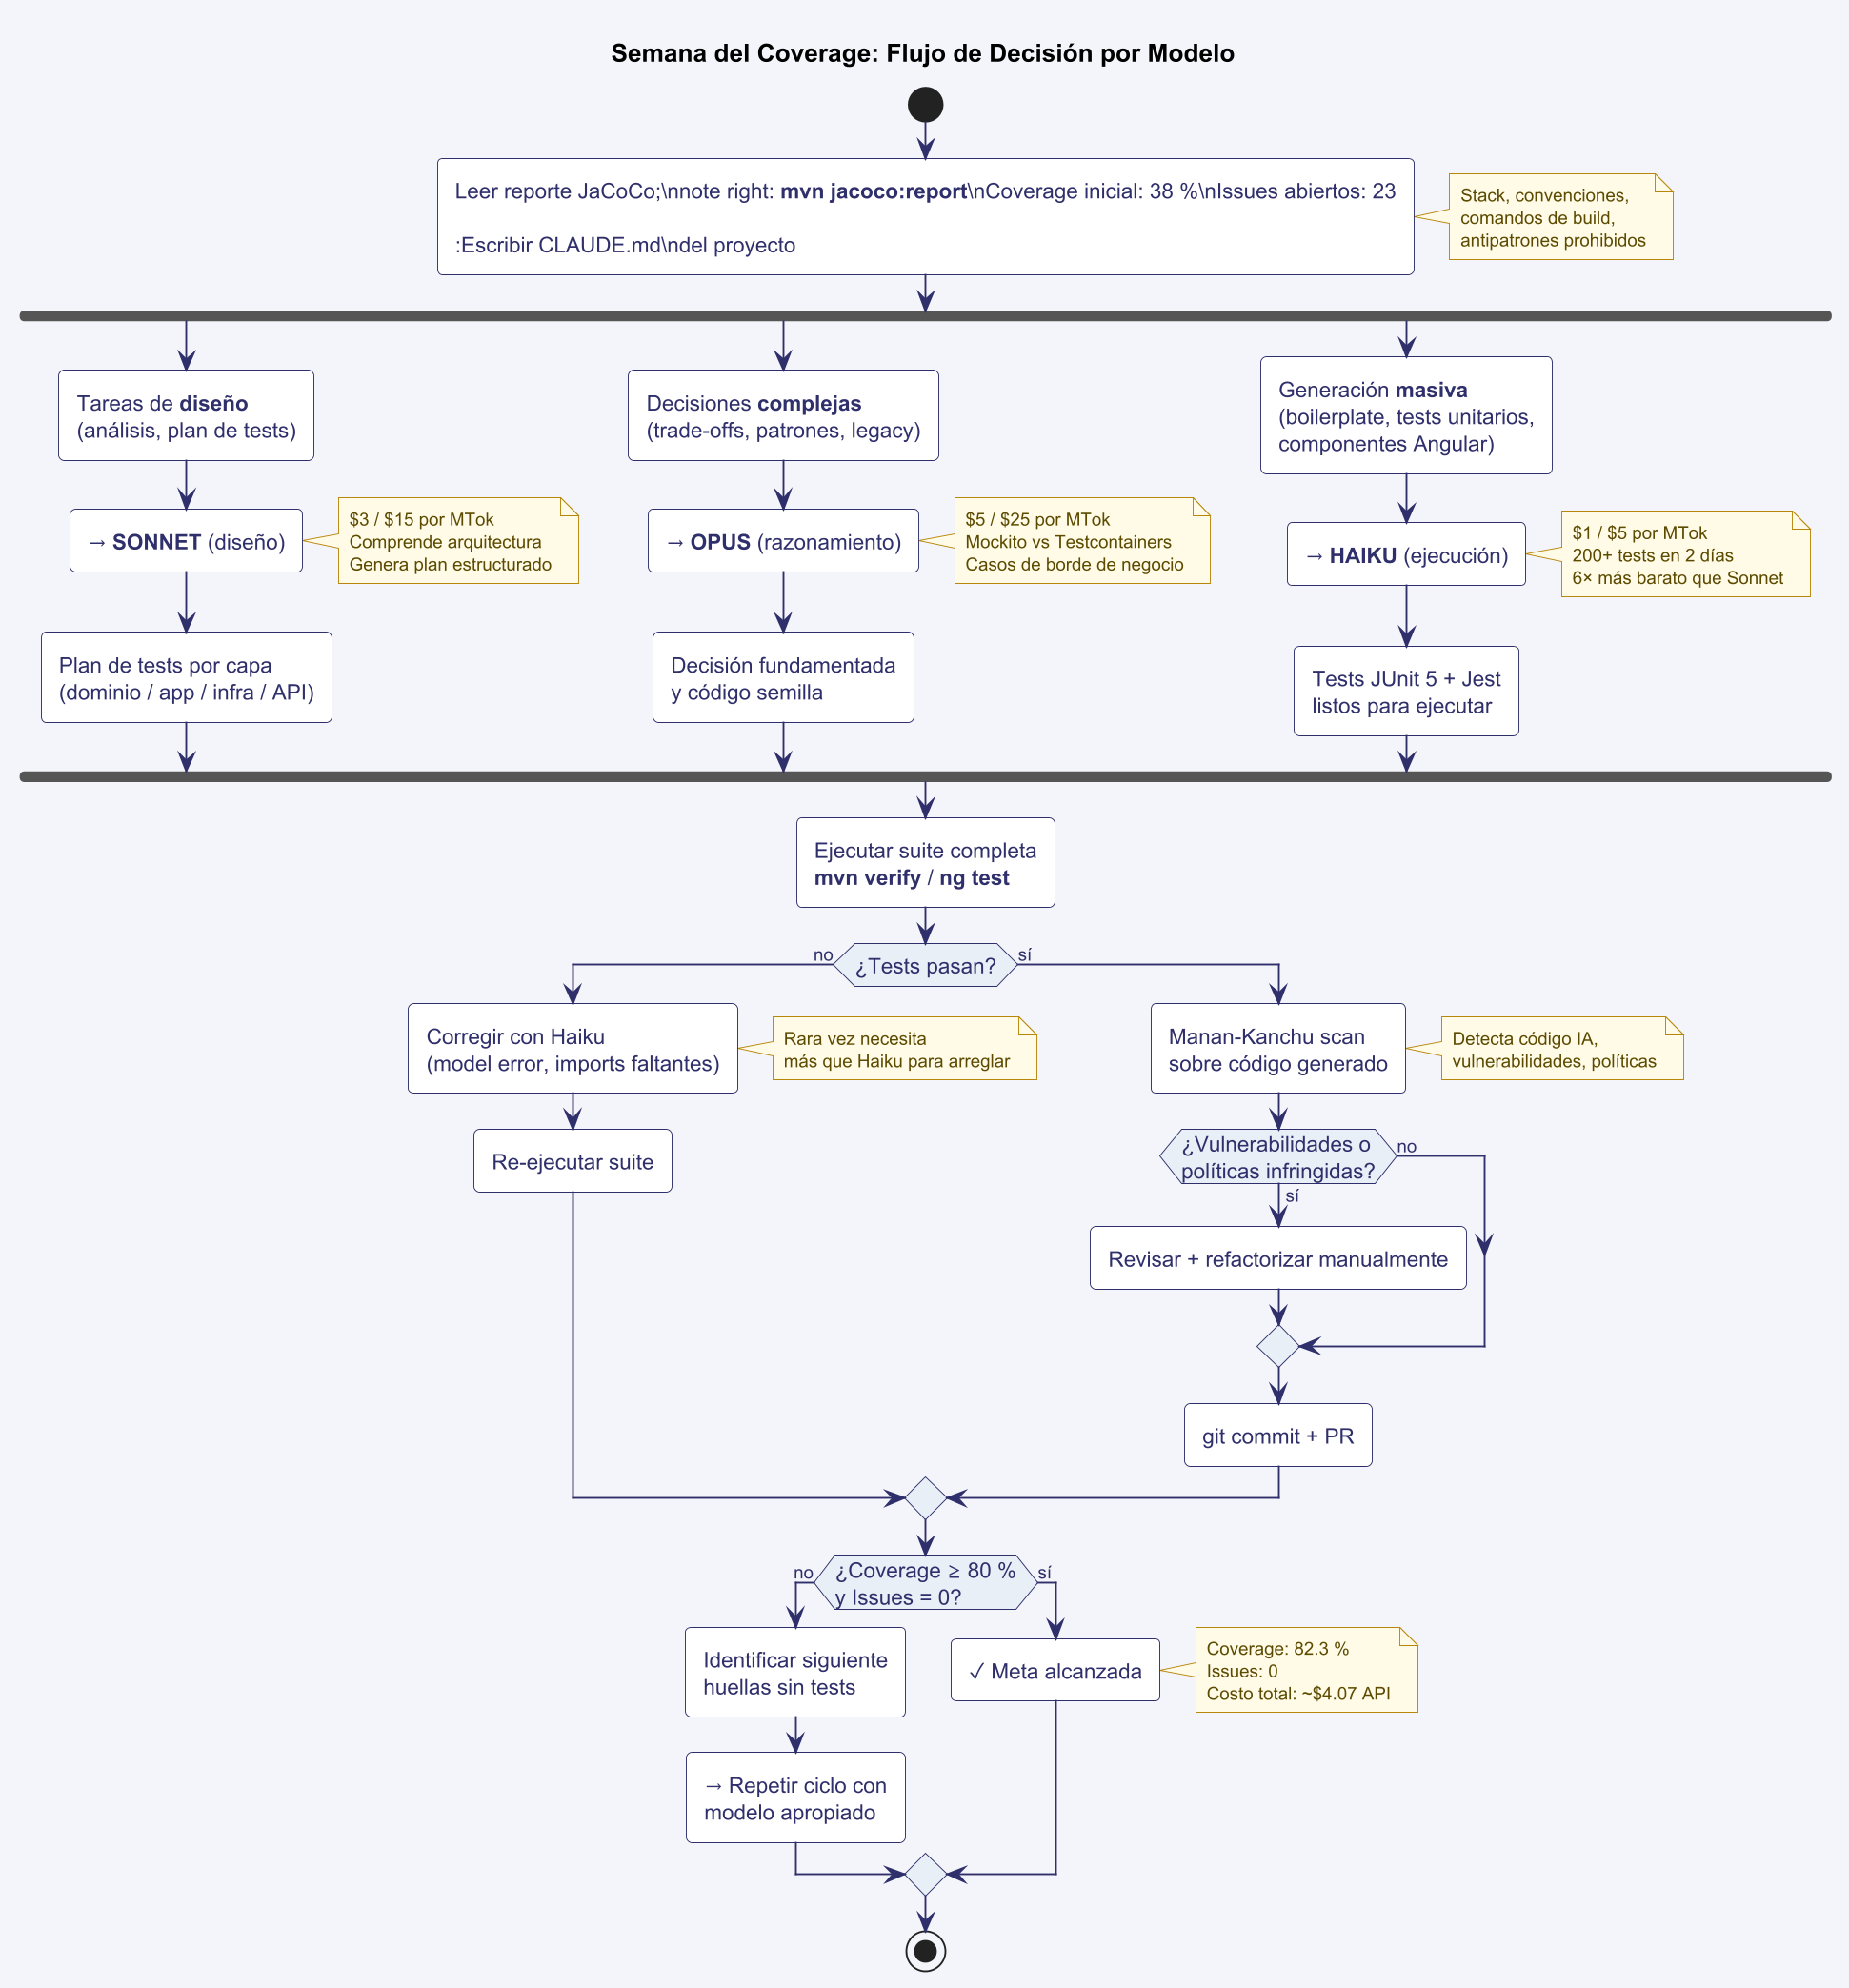
Sección titulada «9.3 La estrategia económica: el modelo correcto para cada tarea»Uno de los errores más costosos que puedo cometer en una semana de trabajo intenso con IA es usar el modelo más caro para todo. Opus razona como un arquitecto senior, pero si lo uso para generar el test de un getter, estoy pagando $25/MTok por algo que Haiku resuelve igual de bien a $5/MTok. La diferencia no es solo de precio: es de velocidad y de dónde conviene invertir la atención cognitiva del modelo.
La regla que aplico: el modelo más caro al principio de cada decisión, el más económico para la ejecución de lo ya decidido.
| Tarea | Modelo | Por qué | Costo orientativo |
|---|---|---|---|
| Analizar arquitectura y generar plan de tests | Sonnet | Comprende relaciones entre capas | $3/$15 MTok |
| Decidir Mockito vs Testcontainers en caso complejo | Opus | Razonamiento de trade-offs profundo | $5/$25 MTok |
| Generar 200 tests unitarios de servicios | Haiku | Boilerplate predecible, patrón claro | $1/$5 MTok |
| Debuggear por qué falla un test generado | Haiku | El error ya está acotado | $1/$5 MTok |
| Refactorizar código legacy para hacerlo testeable | Sonnet | Requiere entender el dominio | $3/$15 MTok |
| Generación masiva de specs Angular/Jest | Haiku | Estructura de componente es repetitiva | $1/$5 MTok |
La semana entera, con 180 tests generados, costó $4.07 en la API. La alternativa hubiera sido usar Sonnet para todo: la misma semana habría costado aproximadamente $24, el equivalente a un mes de Claude Pro. Con la estrategia de niveles, terminé dentro del presupuesto de un día laboral de trabajo en la nube.
GitHub Copilot como alternativa. Si ya tienes acceso a Copilot ($10-19/mes), ofrece autocompletado en línea que es útil para el boilerplate más simple. Sin embargo, no tiene la capacidad de razonamiento de Opus para decisiones arquitectónicas, ni puede mantener el contexto de un CLAUDE.md de proyecto completo en cada sugerencia. Los dos enfoques no se excluyen: Copilot como copiloto de tecleo + Claude para las decisiones que importan.
9.4 Lunes y martes: mapeo y diseño con Sonnet
Sección titulada «9.4 Lunes y martes: mapeo y diseño con Sonnet»El lunes no escribí un solo test. Lo invertí en entender el problema y construir el plan con Sonnet.
El prompt que mandé fue:
Adjunto el CSV del reporte JaCoCo y la estructura de paquetes del proyecto.El CLAUDE.md está en el repositorio. Necesito llegar del 38 % al 80 %de coverage antes del viernes.
Genera un plan de ataque por capa:1. Qué clases priorizar (mayor impacto en coverage vs esfuerzo)2. Qué tipo de test corresponde a cada capa (unit, integración, e2e)3. Qué dependencias necesito mockear vs las que conviene probar con   Testcontainers4. Cuántos tests aproximados necesito por paquete para mover la aguja
No generes código todavía. Solo el plan.
Sonnet devolvió un plan estructurado en cuatro horas de contexto de proyecto. El punto central que identificó, y que yo había subestimado: el paquete application/ tenía 12 clases de servicio con un promedio de 8 métodos públicos cada una, y casi todas las ramas de negocio (validaciones, conversiones de moneda, estados de pago) estaban en ese paquete. Llegar al 80 % dependía casi completamente de cubrir ese paquete.
El plan resultante:
| Paquete | Tests necesarios | Modelo recomendado | Impacto en coverage |
|---|---|---|---|
domain/ |
40 tests | Haiku | +8 % |
application/ |
95 tests | Haiku (con 3 casos Opus) | +28 % |
infrastructure/ |
20 tests (Testcontainers) | Haiku | +8 % |
api/ (ampliar los existentes) |
15 tests | Haiku | +8 % |
Angular (src/app/) |
48 specs Jest | Haiku | coverage JS independiente |
Dieciséis puntos porcentuales ya los tenía el martes antes de escribir una línea de código, porque el plan estaba bien fundamentado.
9.5 Miércoles: los casos difíciles con Opus
Sección titulada «9.5 Miércoles: los casos difíciles con Opus»La mayoría de los 180 tests de la semana los generé con Haiku. Pero había tres servicios que no podía dar a Haiku sin haber tomado primero una decisión arquitectónica:
PagoService: procesa transacciones distribuidas con doble entrada (débito + crédito) bajo una transacción JPA que también publica un evento a Kafka.ConciliacionService: lee resultados de la API de un banco externo, los reconcilia contra la BD y emite alarmas.InventarioService: gestiona stock con optimistic locking y tiene tres variantes de un algoritmo de reabastecimiento.
Para estos tres, usé Opus con el prompt siguiente:
► PISTA TÉCNICA: Prompt para decisión de arquitectura de tests con Opus
Contexto: proyecto PayTrack (CLAUDE.md adjunto).
Clase bajo análisis: PagoService.java (adjunta).Dependencias: PagoRepository (JPA), EventPublisher (Kafka), CurrencyConverter.
La clase tiene una transacción distribuida: si el evento de Kafka falladespués de que JPA confirmó, el estado queda inconsistente.
Pregunta específica: ¿debo testear PagoService con:  (a) Mockito para todo (rápido, aislado),  (b) Testcontainers con PostgreSQL + Kafka en contenedor (lento, realista), o  (c) Un híbrido: Mockito para el happy path + Testcontainers solo para      el caso de fallo de Kafka?
Considera velocidad del pipeline de CI, confianza en el test ycomplejidad de mantenimiento. Justifica con trade-offs concretos,no con generalidades. Al final, dame el código semilla para laopción que recomiendes.
Opus eligió la opción (c) y la justificó con precisión: el happy path con Mockito es suficiente porque la lógica de negocio (calcular el débito/crédito) no depende de la infra; el caso de fallo de Kafka, en cambio, requiere Testcontainers porque el comportamiento transaccional de Spring (rollback vs. outbox pattern) solo emerge con una BD real. Sin Testcontainers para ese caso específico, el test siempre pasaría, aunque el sistema produjera estados inconsistentes en producción.
El código semilla que Opus devolvió:
► PISTA TÉCNICA: Test híbrido Mockito + Testcontainers para servicio transaccional
// PagoServiceTest.java — Happy path con Mockito (Haiku puede expandir este)@ExtendWith(MockitoExtension.class)class PagoServiceTest {
    @Mock PagoRepository pagoRepository;    @Mock EventPublisher eventPublisher;    @Mock CurrencyConverter currencyConverter;
    @InjectMocks PagoService pagoService;
    @Test    void procesarPago_conDatosValidos_debeGuardarYPublicarEvento() {        // Arrange        var solicitud = new SolicitudPago("ACC-001", "ACC-002",                                          new BigDecimal("500.00"), "USD");        var pagoGuardado = Pago.builder()                .id(UUID.randomUUID()).estado(EstadoPago.PENDIENTE).build();
        given(currencyConverter.convertir(any(), eq("USD"), eq("PEN")))                .willReturn(new BigDecimal("1875.00"));        given(pagoRepository.save(any(Pago.class))).willReturn(pagoGuardado);
        // Act        var resultado = pagoService.procesarPago(solicitud);
        // Assert        assertThat(resultado.estado()).isEqualTo(EstadoPago.PENDIENTE);        then(eventPublisher).should().publicar(any(PagoCreadoEvent.class));        then(pagoRepository).should().save(argThat(p ->                p.getMonto().compareTo(new BigDecimal("1875.00")) == 0));    }
    @Test    void procesarPago_conMontoNegativo_debeLanzarExcepcion() {        var solicitud = new SolicitudPago("ACC-001", "ACC-002",                                          new BigDecimal("-10.00"), "USD");
        assertThatThrownBy(() -> pagoService.procesarPago(solicitud))                .isInstanceOf(MontoInvalidoException.class)                .hasMessageContaining("monto negativo");    }}
// PagoServiceKafkaIT.java — Caso de fallo de Kafka (Testcontainers)@SpringBootTest@Testcontainersclass PagoServiceKafkaIT {
    @Container    static PostgreSQLContainer<?> postgres =            new PostgreSQLContainer<>("postgres:15-alpine");
    @Container    static KafkaContainer kafka =            new KafkaContainer(DockerImageName.parse("confluentinc/cp-kafka:7.4.0"));
    @DynamicPropertySource    static void configurarPropiedades(DynamicPropertyRegistry registry) {        registry.add("spring.datasource.url", postgres::getJdbcUrl);        registry.add("spring.datasource.username", postgres::getUsername);        registry.add("spring.datasource.password", postgres::getPassword);        registry.add("spring.kafka.bootstrap-servers", kafka::getBootstrapServers);    }
    @Autowired PagoService pagoService;    @Autowired PagoRepository pagoRepository;
    @Test    void procesarPago_cuandoKafkaFalla_debehacerRollbackDeJPA() {        // Este test verifica que si Kafka rechaza el evento,        // la transacción JPA se revierte y no queda un pago huérfano.
        // Desconectar Kafka para simular fallo de red        kafka.stop();
        var solicitud = new SolicitudPago("ACC-001", "ACC-002",                                          new BigDecimal("100.00"), "USD");
        assertThatThrownBy(() -> pagoService.procesarPago(solicitud))                .isInstanceOf(EventPublicationException.class);
        // Verificar que no quedó el pago en la BD (rollback exitoso)        assertThat(pagoRepository.findAll()).isEmpty();    }}
Ese código semilla fue el molde. Haiku lo extendió con doce variantes más durante el miércoles por la tarde, porque el patrón ya estaba establecido.
9.6 Jueves y viernes: ejecución masiva con Haiku
Sección titulada «9.6 Jueves y viernes: ejecución masiva con Haiku»Con el plan de Sonnet y los moldes de Opus, el jueves fue puro volumen. Haiku es rápido, económico y, cuando tiene un buen CLAUDE.md y un ejemplo de referencia en el prompt, produce tests que pasan sin modificación en la mayoría de los casos.
El workflow que repetí para cada servicio:
► PISTA TÉCNICA: Prompt de generación masiva con Haiku
[CLAUDE.md del proyecto en el contexto de sesión]
Clase a testear: InventarioService.java (adjunta)Test de referencia ya aprobado: InventarioServiceTest_referencia.java (adjunta)
Genera tests JUnit 5 para los siguientes métodos que tienen coverage 0:- ajustarStock(String skuId, int cantidad, TipoAjuste tipo)- calcularReabastecimiento(String skuId) — tiene tres ramas (FIFO, LIFO, PROMEDIO)- transferirEntreAlmacenes(String origen, String destino, int cantidad)
Sigue el patrón del test de referencia:- Un @Test por comportamiento, nombrado dado_Cuando_Entonces- AssertJ para aserciones- Mockito para InventarioRepository y AlmacenRepository- Sin lógica de negocio en el test: solo preparar, actuar y verificar
Genera también el caso de borde de concurrencia para ajustarStockcuando dos hilos intentan ajustar el mismo SKU simultáneamente(usa Awaitility, no Thread.sleep).
El resultado llegó en segundos: 12 tests para InventarioService, todos con nombres descriptivos, sin dependencias circulares, con el caso de concurrencia incluido usando Awaitility tal como lo pedí.
Para Angular el flujo era equivalente, pero en TypeScript con Jest:
► PISTA TÉCNICA: Test de componente Angular generado por Haiku
// pago-form.component.spec.ts — generado por Haiku, revisado por el ingeniero
import { ComponentFixture, TestBed } from '@angular/core/testing';import { ReactiveFormsModule } from '@angular/forms';import { HttpClientTestingModule } from '@angular/common/http/testing';import { of, throwError } from 'rxjs';
import { PagoFormComponent } from './pago-form.component';import { PagoService } from '../../services/pago.service';
describe('PagoFormComponent', () => {  let fixture: ComponentFixture<PagoFormComponent>;  let component: PagoFormComponent;  let pagoServiceSpy: jest.Mocked<PagoService>;
  beforeEach(async () => {    const spy = {      procesarPago: jest.fn(),    } as unknown as jest.Mocked<PagoService>;
    await TestBed.configureTestingModule({      imports: [ReactiveFormsModule, HttpClientTestingModule],      declarations: [PagoFormComponent],      providers: [{ provide: PagoService, useValue: spy }],    }).compileComponents();
    fixture = TestBed.createComponent(PagoFormComponent);    component = fixture.componentInstance;    pagoServiceSpy = TestBed.inject(PagoService) as jest.Mocked<PagoService>;    fixture.detectChanges();  });
  it('debe deshabilitar el botón de envío cuando el formulario es inválido', () => {    // El formulario empieza vacío, por lo tanto inválido    const boton = fixture.nativeElement.querySelector('button[type="submit"]');    expect(boton.disabled).toBe(true);  });
  it('debe mostrar error de validación cuando el monto es negativo', () => {    component.form.patchValue({ monto: -50, cuentaOrigen: 'ACC-001',                                cuentaDestino: 'ACC-002' });    fixture.detectChanges();
    const errorEl = fixture.nativeElement.querySelector('[data-testid="error-monto"]');    expect(errorEl?.textContent).toContain('El monto debe ser mayor a cero');  });
  it('debe llamar a pagoService.procesarPago con los datos del formulario al enviar', () => {    pagoServiceSpy.procesarPago.mockReturnValue(of({ id: 'PAY-001',                                                     estado: 'PENDIENTE' }));    component.form.patchValue({ monto: 500, cuentaOrigen: 'ACC-001',                                cuentaDestino: 'ACC-002', moneda: 'USD' });    fixture.detectChanges();
    component.onSubmit();
    expect(pagoServiceSpy.procesarPago).toHaveBeenCalledWith({      monto: 500, cuentaOrigen: 'ACC-001',      cuentaDestino: 'ACC-002', moneda: 'USD',    });  });
  it('debe mostrar el mensaje de error del servidor cuando el pago falla', () => {    pagoServiceSpy.procesarPago.mockReturnValue(      throwError(() => ({ error: { mensaje: 'Fondos insuficientes' } }))    );    component.form.patchValue({ monto: 9999999, cuentaOrigen: 'ACC-001',                                cuentaDestino: 'ACC-002', moneda: 'USD' });
    component.onSubmit();    fixture.detectChanges();
    const errorGlobal = fixture.nativeElement        .querySelector('[data-testid="error-global"]');    expect(errorGlobal?.textContent).toContain('Fondos insuficientes');  });});
Ese archivo llegó listo. Lo único que ajusté fue el nombre del atributo data-testid para que coincidiera con el HTML real del componente, algo que Haiku no podía saber sin el template.
9.7 Alpaquitay AI: el copiloto sin factura de API
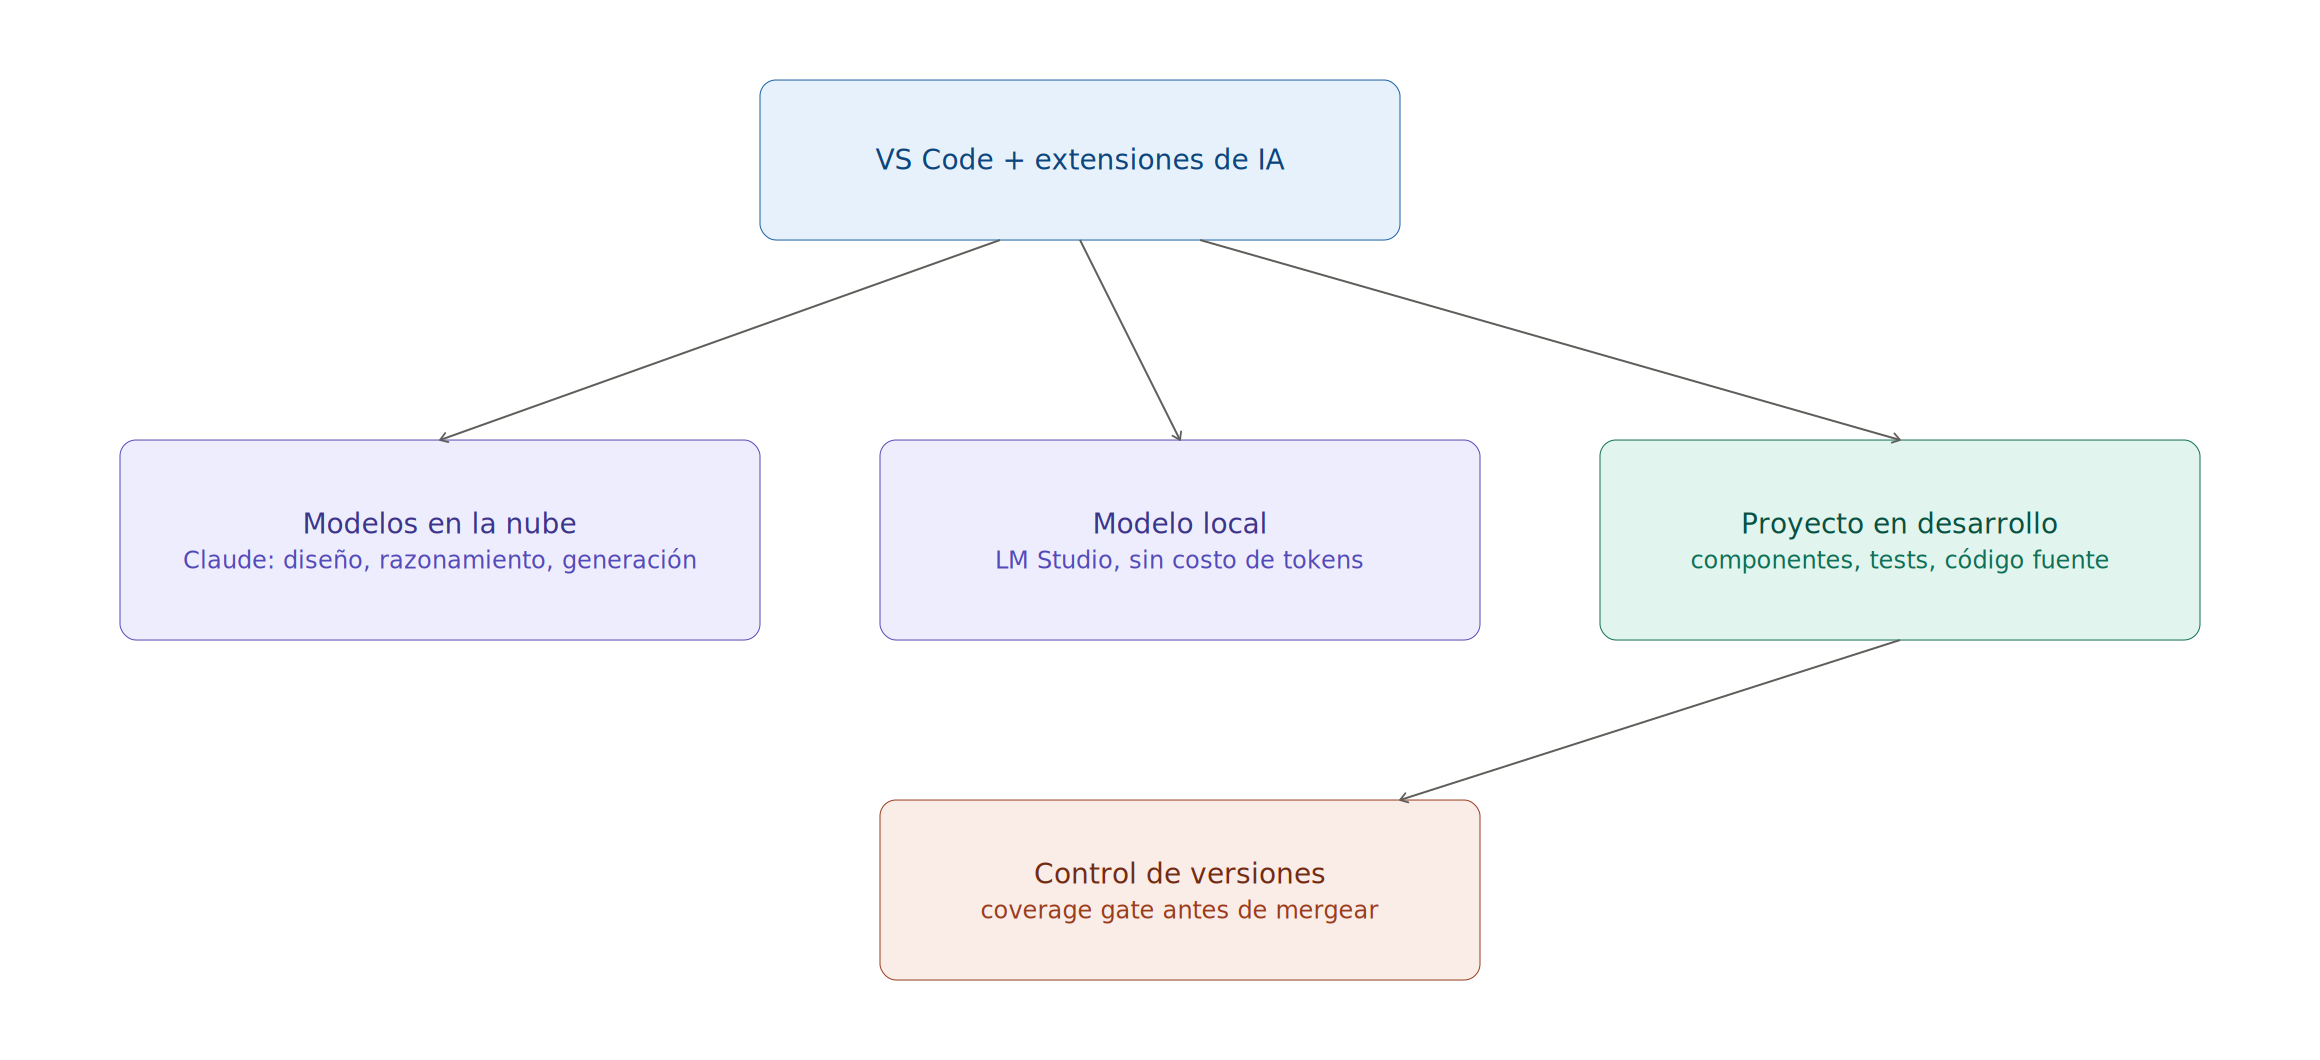
Sección titulada «9.7 Alpaquitay AI: el copiloto sin factura de API»A lo largo de la semana, todos los prompts que mandé a Claude los hice a través de Alpaquitay AI, la extensión de VS Code disponible en el Marketplace. La razón es simple: en lugar de alternar entre el IDE y el navegador (o la CLI), el contexto del archivo que tenía abierto se enviaba directamente como parte del prompt. Seleccionaba la clase de servicio, abría el panel de Alpaquitay y escribía el prompt; la extensión adjuntaba el archivo activo al contexto automáticamente.
Configurar el modelo desde VS Code:
Dentro del panel de Alpaquitay AI, el comando /model cambia el modelo en caliente:
/model haiku # para generación masiva (jueves/viernes)/model sonnet # para análisis y plan (lunes)/model opus # para decisiones arquitectónicas (miércoles)Conectar a LM Studio para trabajo sin costo de API:
Si quieres eliminar completamente el gasto en tokens para las tareas más simples (explorar código, generar boilerplate básico, consultas rápidas), Alpaquitay AI soporta el endpoint OpenAI-compatible que expone LM Studio:
// .vscode/settings.json (o configuración de usuario){ "alpaquitay.endpoint": "http://localhost:1234/v1", "alpaquitay.model": "lmstudio-community/Meta-Llama-3.1-8B-Instruct-GGUF", "alpaquitay.useLocalModel": true}Con LM Studio corriendo y Llama 3.1 cargado, Alpaquitay redirige todas las peticiones al servidor local. El costo es cero tokens de API; la contrapartida es velocidad (un modelo de 8B en CPU es considerablemente más lento que Haiku en la nube) y capacidad de razonamiento reducida. Para generar el test de un getter de valor simple, es suficiente. Para PagoService con transacciones distribuidas, no lo es: ahí conviene volver a la nube con Opus.
La estrategia híbrida que apliqué durante la semana: LM Studio para exploración inicial y boilerplate trivial; API de Claude para los tests que realmente importaban.
► PISTA TÉCNICA: Verificar que Alpaquitay conecta al servidor local
# Primero, verificar que LM Studio está sirviendocurl http://localhost:1234/v1/models | jq '.data[].id'
# Si el output muestra el modelo cargado, Alpaquitay puede usarlo.# Desde el panel de Alpaquitay AI en VS Code, buscar el indicador# de conexión en la barra de estado inferior; debe mostrar el nombre# del modelo local, no "claude-*".
9.8 Manan-Kanchu: el guardián del código generado
Sección titulada «9.8 Manan-Kanchu: el guardián del código generado»Generar 180 tests con IA en cuatro días levanta una pregunta legítima: ¿cómo sé que el código generado es seguro y cumple las políticas del proyecto? Un test que introduce una vulnerabilidad es peor que no tener test.
Para eso está Manan-Kanchu, la extensión de VS Code de análisis de código que también publica el autor. Después de cada lote de tests generados, antes de hacer git add, la escaneo.
► PISTA TÉCNICA: Usar Manan-Kanchu para auditar código generado por IA
# Desde el panel de Manan-Kanchu en VS Code:# Clic derecho sobre la carpeta src/test/java → "Analizar con Manan-Kanchu"## O desde la terminal (CLI de la extensión, si está instalada globalmente):manankanchu scan ./backend/src/test/java --report=json > scan_report.json
# Salida típica que verifica el ingeniero:# {#   "summary": {#     "total_files": 47,#     "ai_detected": 42,       <- esperado: venimos de generar con IA#     "vulnerabilities": 0,#     "policy_violations": 2,  <- estos necesitan atención#     "malware_patterns": 0#   },#   "policy_violations": [#     {#       "file": "PagoServiceTest.java",#       "line": 34,#       "rule": "NO_HARDCODED_SECRETS",#       "detail": "Posible credencial: 'postgres:password123' en literal"#     },#     {#       "file": "ConciliacionServiceTest.java",#       "line": 89,#       "rule": "NO_EXTERNAL_URL",#       "detail": "URL hardcodeada detectada: 'http://api.banco.com'"#     }#   ]# }
Las dos violaciones de política eran exactamente lo que esperaba: Haiku había hardcodeado credenciales de Testcontainers y una URL de un servicio externo que debían ir en variables de entorno o en @DynamicPropertySource. Las corregí en tres minutos. Sin el scan, esas credenciales habrían entrado al repositorio.
El indicador ai_detected: 42 no es una alarma: el código es del autor aunque lo haya generado una herramienta. Lo que importa es que el ingeniero lo revisó, lo entiende y lo firma. Manan-Kanchu no te dice “no uses IA”; te dice “aquí hay algo que revisar antes de que llegue a producción”.
9.9 Los cinco antipatrones que casi me cuestan la semana
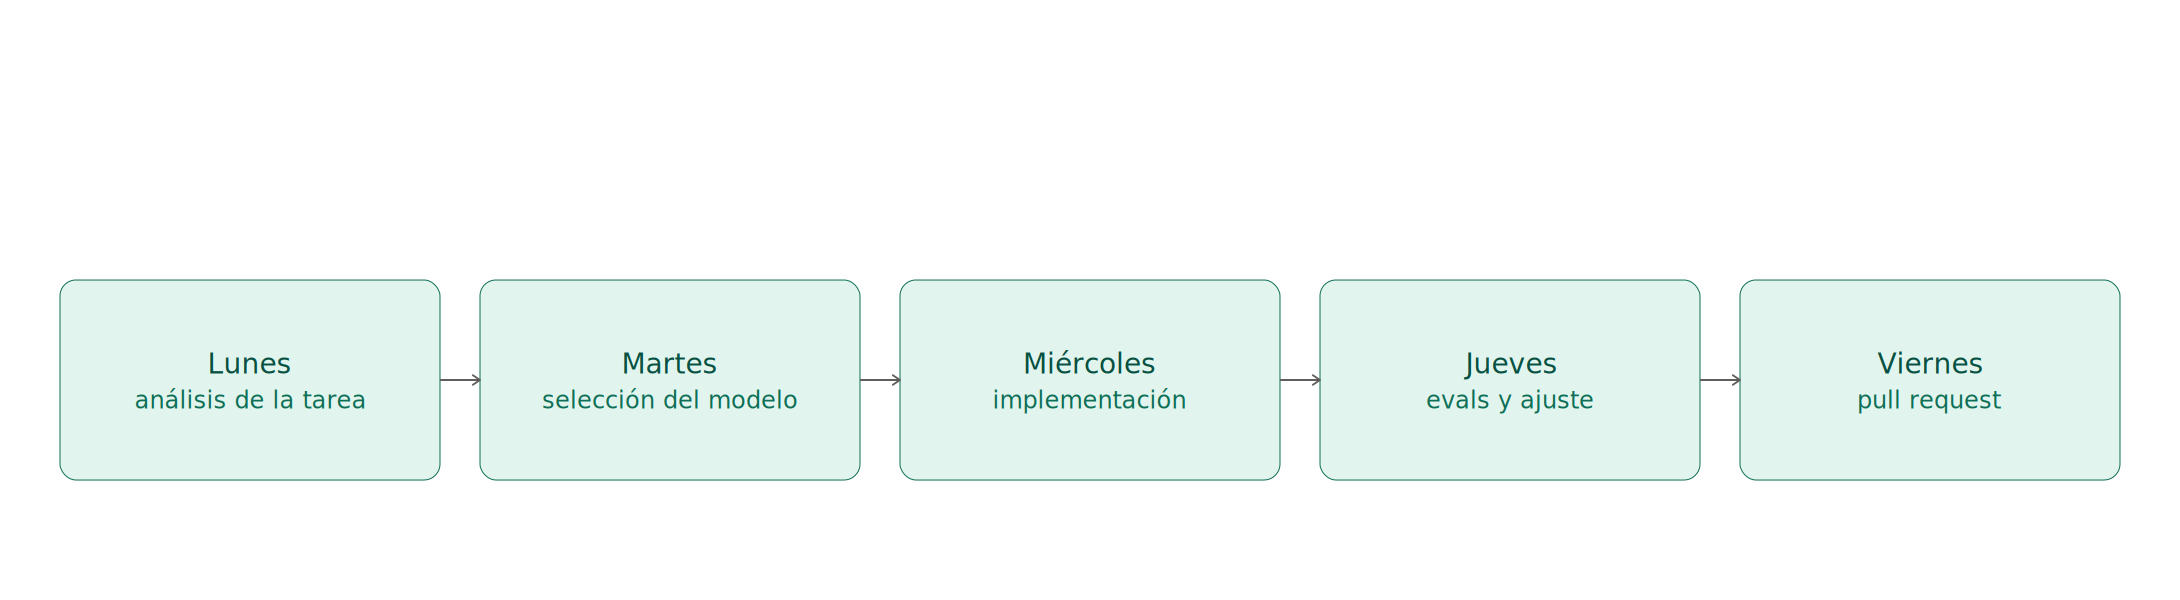
Sección titulada «9.9 Los cinco antipatrones que casi me cuestan la semana»Esta semana no fue lineal. Cometí errores; algunos me costaron horas. Los anoto con precisión para que no los repitas.
Antipatrón 1: Mandar a Haiku sin CLAUDE.md y sin ejemplo de referencia.
El miércoles por la tarde, con prisa, mandé un prompt de generación a Haiku sin adjuntar el CLAUDE.md y sin indicar el test de referencia. Haiku generó tests con JUnit 4 (@RunWith, @Before) en lugar de JUnit 5 (@ExtendWith, @BeforeEach), y usó assertEquals de JUnit en lugar de AssertJ. Tuve que descartar 15 tests y rehacerlos con el contexto correcto. Costo: dos horas.
Antipatrón 2: Usar Opus para todo el volumen.
El martes, optimista por la calidad de los outputs de Opus, lo usé para los primeros veinte tests de dominio. Los tests eran perfectos, pero llegó la factura del día: $8.40 solo del martes. Cambié a Haiku el miércoles y el resto de la semana costó $3.67 total. Opus para las decisiones, Haiku para la ejecución.
Antipatrón 3: No revisar los tests generados antes de ejecutarlos.
Cuatro de los tests de Haiku compilaban pero no probaban lo que su nombre decía. Por ejemplo, debeCalcularDescuentoPorVolumen no tenía ninguna aserción sobre el descuento; solo verificaba que el método no lanzara excepción. Un test sin aserción significativa es peor que ningún test: suma al coverage, da falsa seguridad y oculta bugs. Revisé todos los tests a ojo antes de ejecutarlos.
Antipatrón 4: Generar los tests de integración con Haiku sin haber resuelto el diseño.
Intenté pedirle a Haiku directamente los tests de PagoService sin pasar primero por Opus. Haiku generó tests razonables pero eligió Mockito para el caso de fallo de Kafka: un test que siempre pasaba porque mockeaba exactamente la capa que necesitaba fallar. Fue la decisión correcta para el happy path, no para el caso de fallo transaccional. El orden importa: Opus decide, Haiku ejecuta.
Antipatrón 5: No ejecutar Manan-Kanchu antes del primer commit.
El primer día lo salté por confianza. El segundo día, el scan encontró las dos violaciones de política que detallé antes. Si ese código hubiera llegado al historial de Git, la limpieza habría requerido un git rebase con reescritura de historia. Una práctica simple previene un incidente de seguridad.
9.10 El viernes por la tarde: métricas finales
Sección titulada «9.10 El viernes por la tarde: métricas finales»A las 16:30 del viernes ejecuté mvn clean verify por última vez:
[INFO] Tests run: 247, Failures: 0, Errors: 0, Skipped: 0[INFO] Overall coverage: 82.3%[INFO] com.empresa.paytrack.domain: 91.2%[INFO] com.empresa.paytrack.application: 84.7%[INFO] com.empresa.paytrack.infrastructure: 78.9%[INFO] com.empresa.paytrack.api: 76.1%[INFO] BUILD SUCCESSAngular:
Test Suites: 12 passed, 12 totalTests: 61 passed, 61 totalCoverage: 86.4% statements, 79.1% branchesIssues: 23 → 0. Los issues de validación que nadie podía cerrar resultaron ser bugs reales que los nuevos tests detectaron; una vez detectados, la corrección fue mecánica con Haiku porque el test fallido ya señalaba exactamente qué estaba roto.
Desglose de costo real de la semana:
| Modelo | Tokens entrada | Tokens salida | Costo |
|---|---|---|---|
| Sonnet 4.6 (lunes–martes, diseño) | ~18 K | ~12 K | $0.24 |
| Opus 4.8 (miércoles, 3 servicios complejos) | ~22 K | ~9 K | $0.34 |
| Haiku 4.5 (jueves–viernes, generación masiva) | ~380 K | ~590 K | $3.33 |
| Haiku 4.5 (correcciones y debug) | ~30 K | ~20 K | $0.13 |
| Total | ( | ) | $4.04 |
Cuatro dólares por la semana. La alternativa de Sonnet para todo habría costado aproximadamente $26. La alternativa de Opus para todo, aproximadamente $140.
La eficiencia no es un lujo cuando hay presupuesto limitado; es el requisito para que la herramienta sea sostenible a largo plazo.
■ PISTA EJECUTIVA
La semana del coverage no es un experimento: es un caso de negocio. Desde la perspectiva directiva, lo que ocurrió es que un ingeniero, sin contratar a nadie más, cubrió el equivalente a cuatro semanas de trabajo de tests en cinco días, a un costo de API inferior al de un café. El costo real de la semana fue tiempo de revisión humana, no tokens: cada test generado requirió entre 30 segundos y 3 minutos de revisión. Eso no desaparece con más IA; es la garantía de calidad. Si eliminas la revisión, no tienes tests: tienes métricas falsas.
Lo que sí cambia con la IA es la proporción: antes, el cuello de botella era escribir; ahora, es revisar. Y revisar es una habilidad que escala mejor que teclear, porque un ingeniero sénior puede revisar cuatro tests por minuto, pero difícilmente puede escribir más de uno.
Lo esencial del capítulo 9
Sección titulada «Lo esencial del capítulo 9»- El CLAUDE.md no es opcional para trabajo intensivo: es el prefijo que convierte prompts genéricos en código que encaja en tu arquitectura sin retrabajo.
- La estrategia de niveles de modelo (Sonnet para diseño, Opus para decisiones complejas, Haiku para ejecución masiva) redujo el costo de la semana de ~$26 a $4.04 manteniendo la misma calidad de output.
- El orden correcto es: diagnóstico → plan (Sonnet) → decisiones de arquitectura (Opus) → generación masiva (Haiku) → auditoría (Manan-Kanchu). Saltarse cualquier paso de la secuencia lo devuelve con intereses.
- Alpaquitay AI como puente entre VS Code y los modelos (cloud o local con LM Studio) elimina la fricción del contexto: el archivo activo siempre es parte del prompt.
- Manan-Kanchu es el gate de calidad antes del commit: detecta credenciales hardcodeadas, URLs externas y vulnerabilidades que los modelos introducen en su boilerplate sin intención pero con consecuencias.
- El cuello de botella se desplazó de escribir a revisar. La revisión humana no desaparece; se concentra.
Ejercicio resuelto 9.1: replique la semana del coverage en dos horas
Sección titulada «Ejercicio resuelto 9.1: replique la semana del coverage en dos horas»Toma un proyecto propio (Spring Boot o cualquier backend con Java/Python) y aplica el flujo de esta semana en miniatura: una sesión de dos horas.
- Genera el reporte de cobertura actual (
mvn jacoco:reporto el equivalente de tu stack). - Crea un
CLAUDE.mdcon: stack, convenciones de test, comandos de build, dos antipatrones prohibidos. - Manda el reporte a Sonnet con el prompt de la sección 9.4 y pídele el plan de ataque.
- Elige el servicio con mayor impacto en coverage según el plan y mándaselo a Haiku con el prompt de la sección 9.6.
- Ejecuta el test generado. Si falla, pídele a Haiku que corrija el error adjuntando el stack trace.
- Registra: ¿cuántos tokens consumiste? ¿cuánto movió la aguja de coverage? ¿cuántos minutos de revisión necesitó cada test?
El registro te dará tu propia calibración de velocidad y costo, que es más valiosa que cualquier tabla de este capítulo.