Capítulo 1: El silencioso Token-Burn
La deuda que no aparece en el balance
Sección titulada «La deuda que no aparece en el balance»En la contabilidad tradicional de proyectos de software, los costos son visibles: horas-persona, licencias, infraestructura. En la era agéntica emerge una categoría de costo que no aparece en ningún presupuesto inicial: el Token-Burn: el consumo acumulado de tokens generado por iteraciones mal diseñadas, contextos inflados sin necesidad y agentes que «piensan en voz alta» con verbosidad no gobernada.
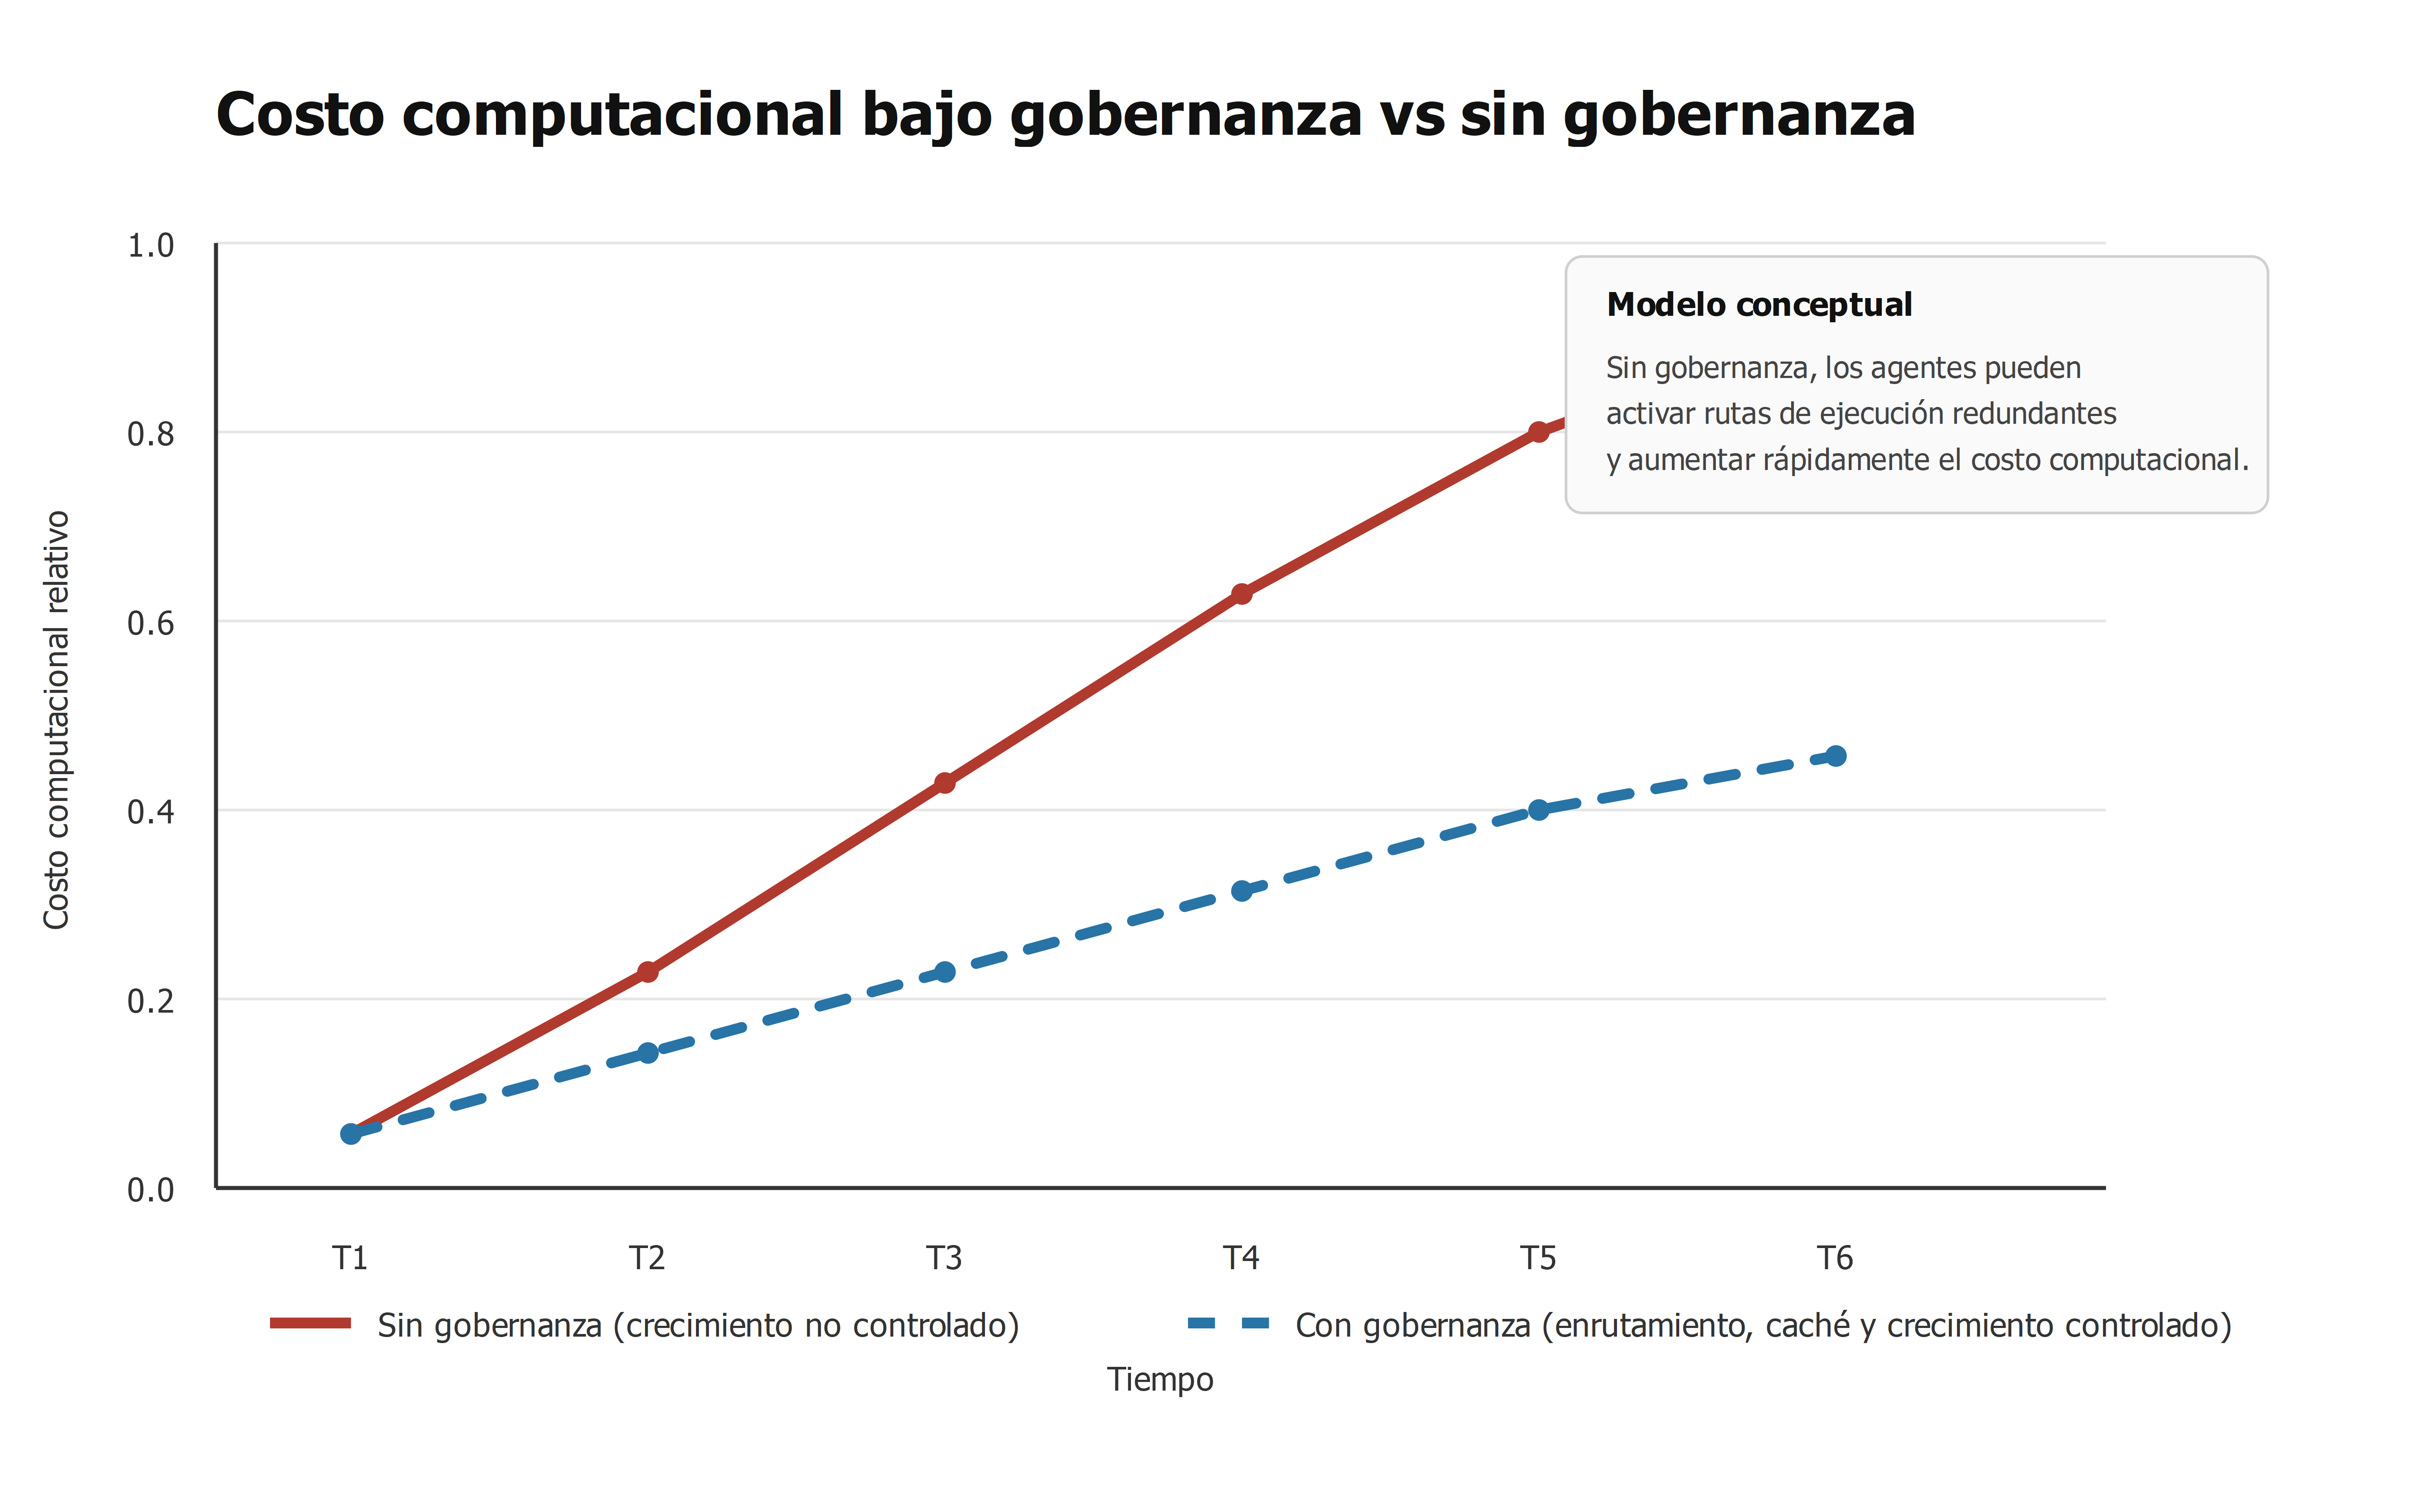
Es silencioso porque cada llamada individual parece trivial: unos centavos, quizás un dólar. El problema emerge a escala. Un equipo de diez ingenieros usando agentes sin gobernanza puede acumular decenas de miles de dólares mensuales en tokens sin que nadie en el liderazgo lo sepa, no porque alguien lo oculte, sino porque ningún sistema lo agrega. La analogía contable exacta es la deuda técnica de Boehm: el costo de corregir un defecto crece de forma no lineal con el tiempo que tarda en detectarse (Boehm, 1981). El Token-Burn es deuda económica con la misma estructura: cuanto más tarde se instala la gobernanza, más caro resulta el período sin ella.
La métrica CIU: Costo por Iteración Útil
Sección titulada «La métrica CIU: Costo por Iteración Útil»Introducimos el CIU (Costo por Iteración Útil) como métrica económica fundamental de la era agéntica:
$$CIU = \frac{\text{Costo total de tokens del pipeline}}{\text{Número de funcionalidades validadas y en producción}}$$
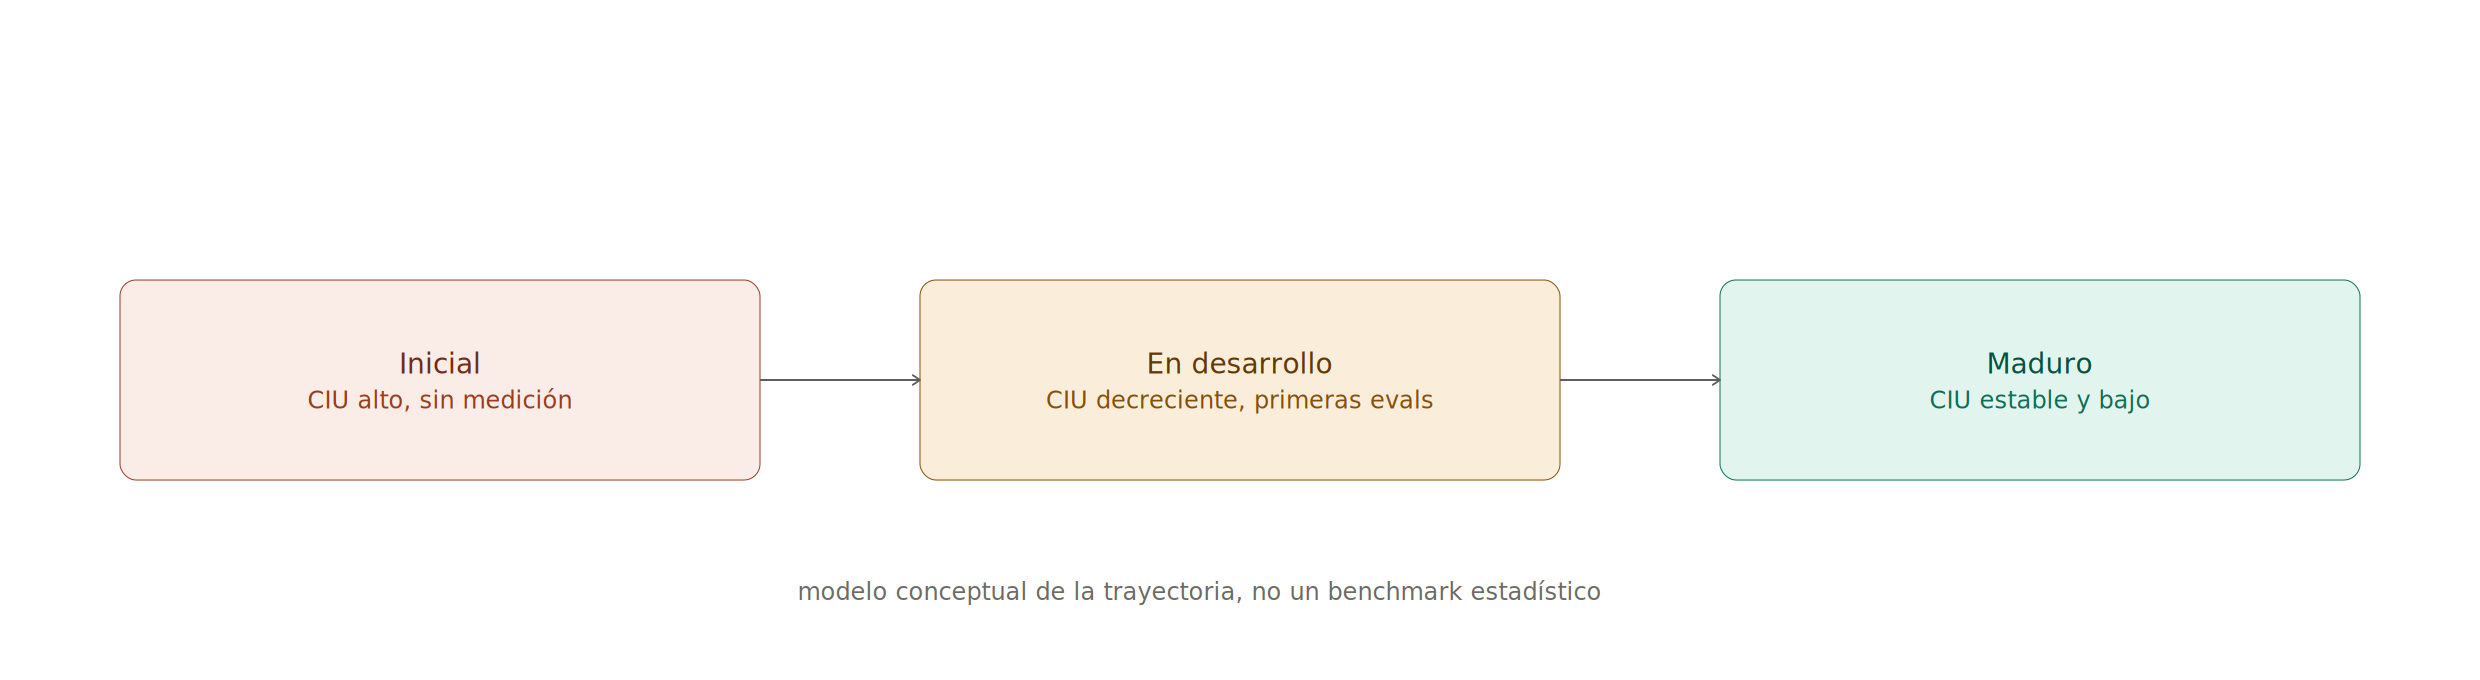
Dicho de otra manera, el CIU traduce el gasto en tokens a términos de negocio: ¿cuánto cuesta, en realidad, llevar una funcionalidad de la idea a producción usando agentes? El denominador es la palabra clave: validadas. Las iteraciones que no llegan a producción no son productividad; son costo. Un CIU que sube mientras el volumen de código generado crece es la firma inequívoca de la ilusión de velocidad descrita en el prefacio.
La métrica conecta con un resultado central de la investigación en evaluación de agentes: las comparaciones de sistemas agénticos que no controlan el costo no son ciencia ni ingeniería: son marketing (Kapoor et al., 2024). El CIU es el control de costo aplicado a la propia organización: cada arquitectura del capítulo 8 debe justificar su CIU contra la alternativa simple.
Las cinco causas principales del Token-Burn excesivo
Sección titulada «Las cinco causas principales del Token-Burn excesivo»- Contexto inflado. Inyectar documentación completa cuando solo se necesita un fragmento. Es la causa más común y la más cara, y además degrada la calidad: los modelos usan peor la información enterrada en contextos largos (Liu et al., 2024). Solución: RAG afinado y disciplina de contexto.
- Modelo equivocado. Usar el modelo premium para tareas que el modelo económico resuelve igual de bien. Con los precios vigentes al cierre de edición, la diferencia entre gamas es de 5× por token; multiplicada por miles de llamadas diarias, financia un ingeniero. Solución: enrutamiento por complejidad (capítulo 3).
- Bucles sin criterio de parada. Agentes que iteran más allá del punto de rendimiento decreciente. Solución: presupuestos de iteración explícitos (capítulo 4) y la métrica de este capítulo.
- Sin caché de prompts. Reenviar el mismo prefijo (sistema, contexto de dominio, herramientas) a precio completo en cada llamada. Las APIs modernas cachean prefijos estables: las lecturas de caché cuestan en torno al 10 % del precio normal de entrada, con un pequeño sobreprecio único de escritura. En agentes con prefijos largos y muchas iteraciones, el ahorro es del orden del 80–90 % del costo de entrada. La condición: el prefijo debe ser bytes-idéntico entre llamadas; un timestamp interpolado al inicio del prompt destruye silenciosamente todo el ahorro.
- Verbosidad no gobernada. No limitar los tokens de salida ni instruir el nivel de detalle. La salida cuesta típicamente cinco veces más que la entrada; pagar verbosidad es pagar prima por ruido.
A estas cinco se añade una palanca que es oportunidad, no causa: lo que no es urgente, en lote. Las APIs de procesamiento por lotes (Batch) de los principales proveedores ofrecen en torno al 50 % de descuento para cargas asíncronas: evaluaciones nocturnas, clasificación masiva, generación de documentación. Un pipeline maduro separa el tráfico interactivo del diferible y manda el segundo a mitad de precio.
► PISTA TÉCNICA: Sistema de control del Token-Burn
# Ejemplo 1.1: Tracker de CIU en tiempo real.# Detecta y alerta cuando el CIU supera umbrales definidos.# Integrar en el AI Gateway (capítulo 3) para cobertura automática.
import statisticsfrom dataclasses import dataclass, fieldfrom datetime import datetime, timedeltafrom typing import List
@dataclassclass IterationRecord:    feature_id: str    tokens_consumed: int    costo_usd: float    fue_a_produccion: bool    timestamp: datetime = field(default_factory=datetime.now)
class CIUTracker:    """    Trackea el CIU en tiempo real y emite alertas al superar umbrales.    """
    def __init__(self, alerta_ciu_usd: float = 5.0):        self.iteraciones: List[IterationRecord] = []        self.alerta_ciu_usd = alerta_ciu_usd
    def registrar(self, feature_id: str, tokens: int,                  costo_usd: float, validado: bool):        self.iteraciones.append(IterationRecord(            feature_id=feature_id,            tokens_consumed=tokens,            costo_usd=costo_usd,            fue_a_produccion=validado,        ))        ciu_actual = self.calcular_ciu_feature(feature_id)        if ciu_actual > self.alerta_ciu_usd:            self._emitir_alerta(feature_id, ciu_actual)
    def calcular_ciu_feature(self, feature_id: str) -> float:        """CIU para una funcionalidad específica."""        registros = [r for r in self.iteraciones if r.feature_id == feature_id]        if not registros:            return 0.0        costo_total = sum(r.costo_usd for r in registros)        validadas = sum(1 for r in registros if r.fue_a_produccion)        if validadas == 0:            return float("inf")  # en progreso: aún no hay denominador        return costo_total / validadas
    def calcular_ciu_global(self, ventana_dias: int = 30) -> float:        """CIU agregado del equipo en los últimos N días."""        limite = datetime.now() - timedelta(days=ventana_dias)        recientes = [r for r in self.iteraciones if r.timestamp >= limite]        if not recientes:            return 0.0        costo_total = sum(r.costo_usd for r in recientes)        validadas = sum(1 for r in recientes if r.fue_a_produccion)        return costo_total / max(validadas, 1)
    def reporte_mensual(self) -> dict:        limite = datetime.now() - timedelta(days=30)        registros = [r for r in self.iteraciones if r.timestamp >= limite]        cius_features = [            self.calcular_ciu_feature(r.feature_id)            for r in registros            if self.calcular_ciu_feature(r.feature_id) != float("inf")        ]        return {            "periodo": "últimos 30 días",            "total_iteraciones": len(registros),            "costo_total_usd": round(sum(r.costo_usd for r in registros), 2),            "features_a_produccion": sum(1 for r in registros                                         if r.fue_a_produccion),            "ciu_global": round(self.calcular_ciu_global(), 4),            "ciu_promedio_por_feature": round(                statistics.mean(cius_features), 4) if cius_features else 0.0,            "alerta_activa": self.calcular_ciu_global() > self.alerta_ciu_usd,        }
    def _emitir_alerta(self, feature_id: str, ciu: float):        # En producción: Slack, PagerDuty, dashboard.        print(f"ALERTA TOKEN-BURN: la feature '{feature_id}' tiene "              f"CIU=${ciu:.2f} (umbral: ${self.alerta_ciu_usd:.2f}). "              f"Revisar pipeline.")
■ PISTA EJECUTIVA: Las preguntas del CFO
El capítulo entero se resume en cuatro preguntas que un director financiero hará tarde o temprano, y que conviene poder responder antes:
- ¿Cuánto gastamos en inferencia el mes pasado, por equipo y por producto? Sin gateway central (capítulo 3), esta pregunta no tiene respuesta.
- ¿Cuál es nuestro CIU y cómo evoluciona? Es la única métrica que conecta el gasto en IA con el valor entregado.
- ¿Qué fracción del gasto es evitable? Auditar las cinco causas; en organizaciones sin gobernanza previa, encontrar 40–60 % de gasto evitable es lo habitual, dominado por contexto inflado y modelo equivocado.
- ¿El gasto crece más rápido o más despacio que el valor? Un gasto creciente con CIU decreciente es una inversión sana; un gasto creciente con CIU creciente es la definición operativa del Token-Burn.
Ejercicio resuelto 1.1: audite este pipeline
Sección titulada «Ejercicio resuelto 1.1: audite este pipeline»Enunciado. Un equipo reporta este pipeline de generación de descripciones de producto: modelo premium para todas las llamadas; el catálogo completo (90.000 tokens) inyectado en cada prompt «por contexto»; sin max_tokens configurado; bucle de reintento hasta que la descripción «suene bien» según el propio modelo; todo en tráfico interactivo aunque el lote corre de madrugada. Identifique las causas de Token-Burn y ordene las correcciones por ahorro.
Solución comentada. Las cinco causas están presentes: el ejercicio es un bestiario. Por ahorro descendente: (1) contexto inflado: el catálogo completo por llamada es el grueso de la factura; con RAG, cada producto necesita su propia ficha y poco más, con un ahorro estimado superior al 90 % de la entrada y mejora de calidad por añadidura (Liu et al., 2024). (2) Modelo equivocado: las descripciones de producto son tarea de gama económica, con 5× de ahorro inmediato sobre lo que quede. (3) Lote a mitad de precio: corre de madrugada, que es la definición del tráfico diferible. (4) Bucle sin criterio objetivo: «sonar bien» juzgado por el generador es el anti-patrón de autocomplacencia (capítulo 8); se reemplaza por criterios verificables (longitud, atributos obligatorios presentes, sin afirmaciones no contenidas en la ficha) con presupuesto de dos reintentos. (5) Salida sin límite: max_tokens acorde al formato. La trampa pedagógica del enunciado: la corrección (4) es la menos lucrativa en tokens pero la más importante en calidad; el orden por ahorro no siempre es el orden por valor, y saber distinguirlos es el oficio.
El costo bajo la línea del token: la infraestructura que ejecuta al agente
Sección titulada «El costo bajo la línea del token: la infraestructura que ejecuta al agente»El CIU mide el costo del token; no es el costo total. Cada llamada del agente corre sobre infraestructura que también factura: el gateway que la enruta, la caché que la abarata, el egreso de red que mueve sus datos y el almacenamiento donde viven los documentos que recupera. En sistemas pequeños esta línea es ruido frente a la factura del modelo; en sistemas que tocan datos regulados o de alto volumen, deja de serlo, y entonces la decisión de dónde corre cada pieza se vuelve una palanca de costo del mismo orden que las cinco causas anteriores.
La arquitectura híbrida es esa palanca. La idea, que el autor desarrolló en material publicado (véase «Obra pública del autor»), es separar dos cargas con economías opuestas: la inferencia, elástica y barata de pagar por uso en la nube, y los datos, que cuando son sensibles o voluminosos resultan caros de mover y de exponer. El patrón mantiene el dato cerca de su origen (en una nube privada o en on-premise) y lleva hacia él solo la computación que lo necesita, en lugar de arrastrar el dato hasta la inferencia en cada iteración.
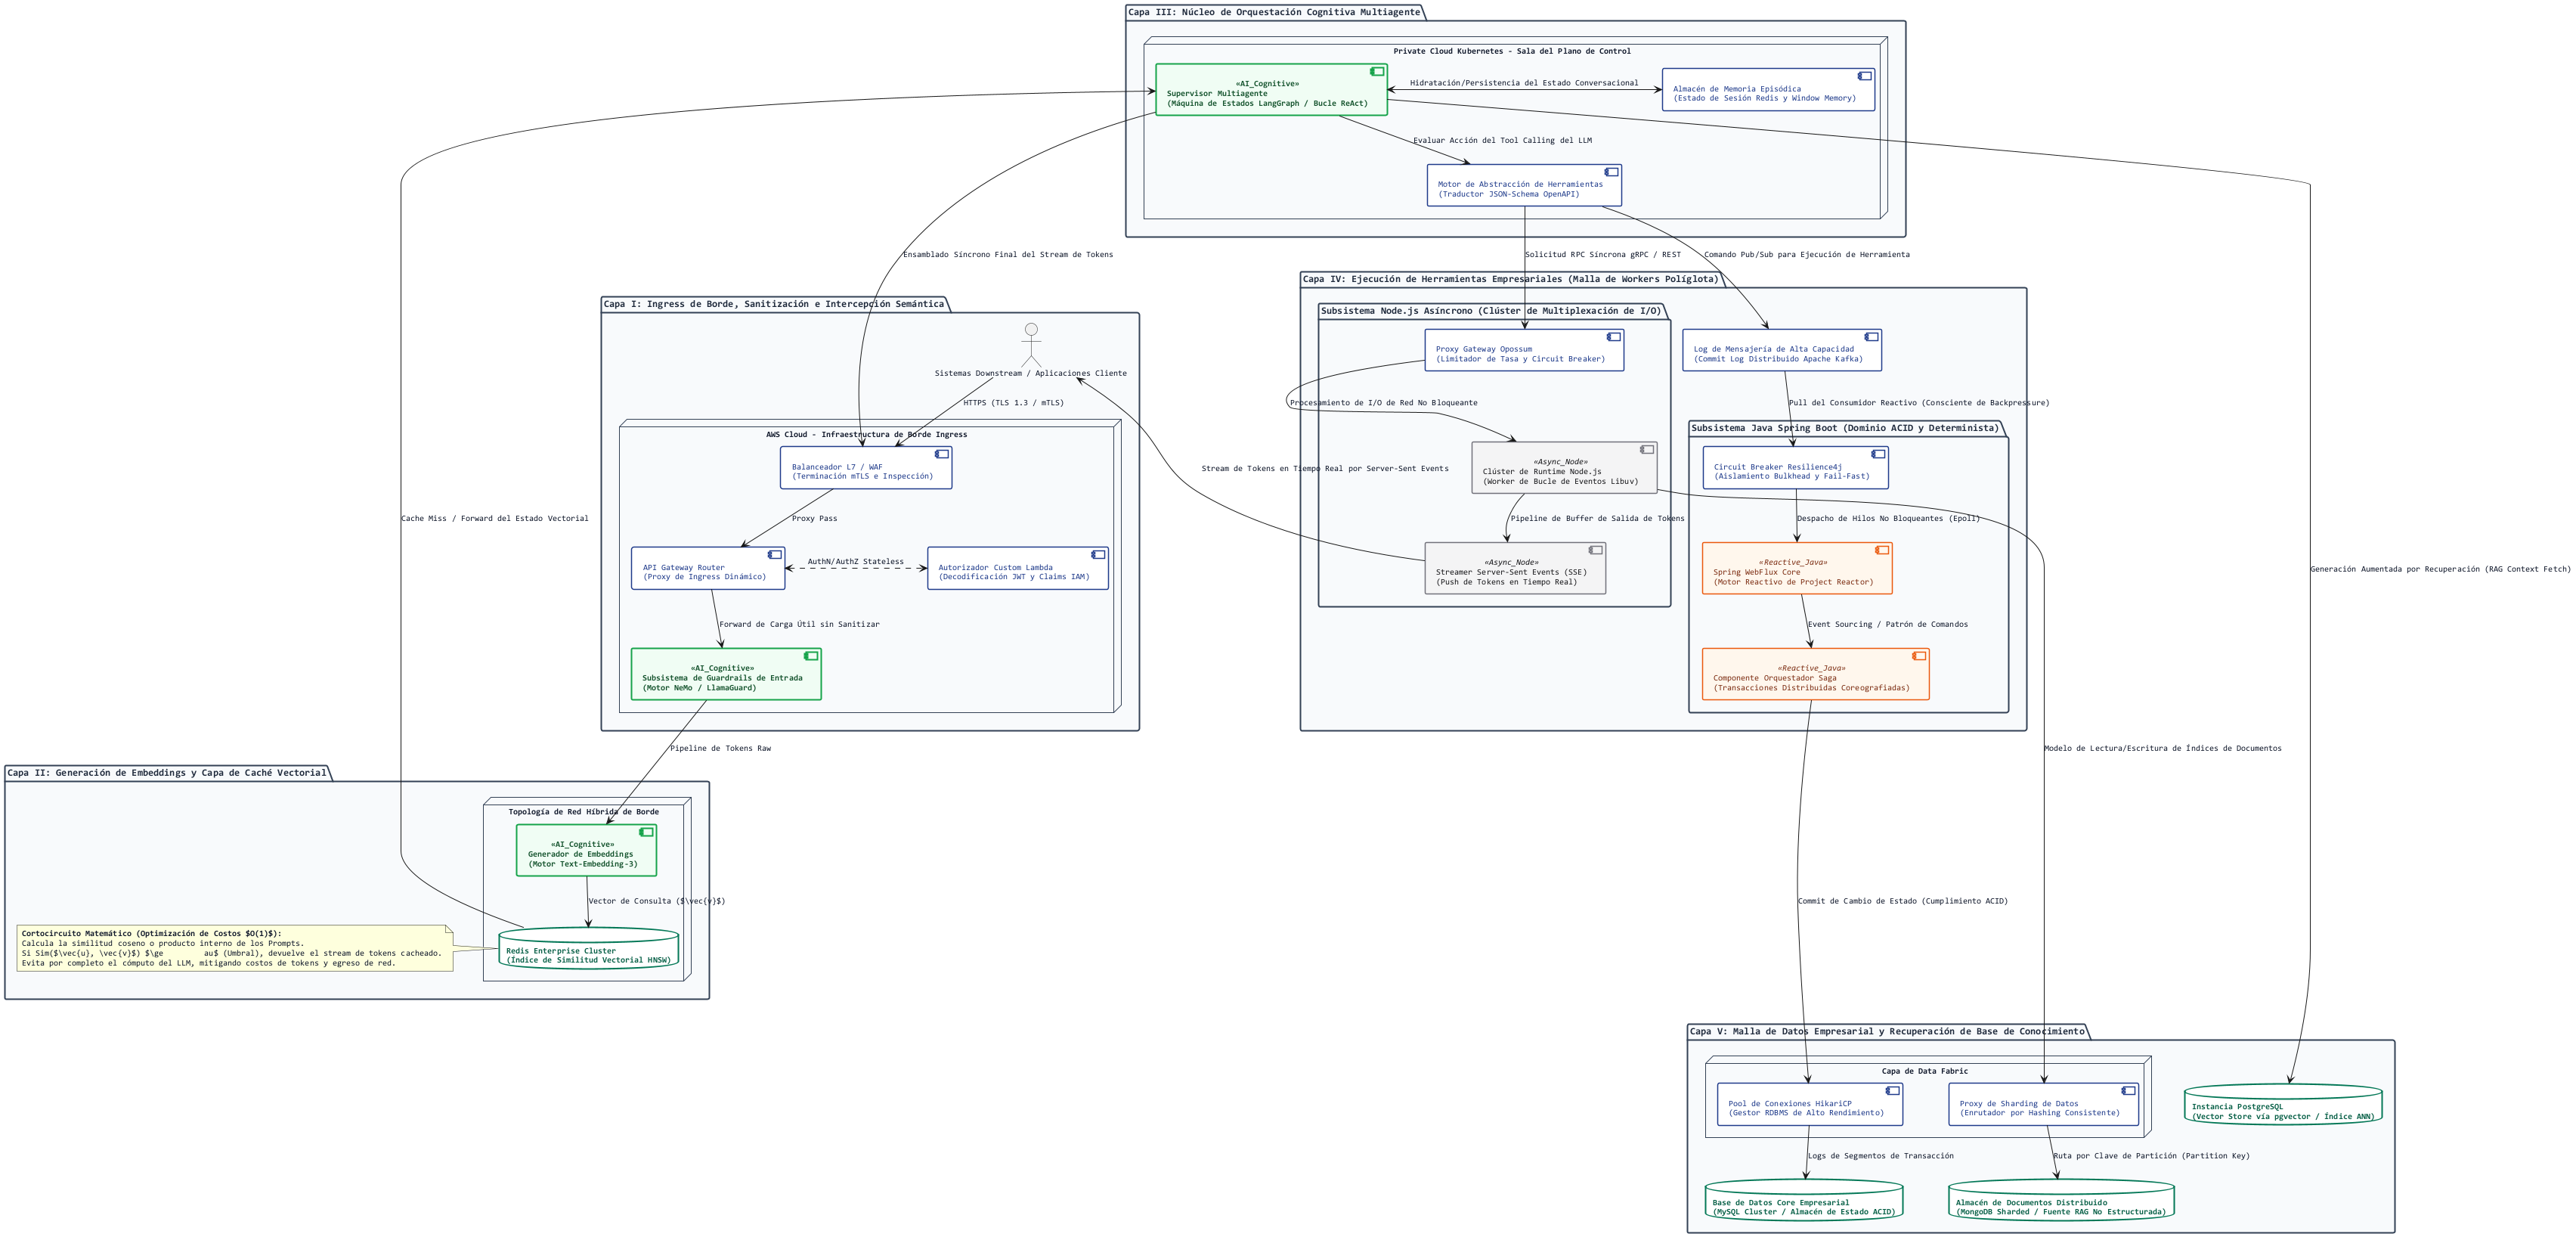
El diagrama hace concretas tres decisiones de costo que un agente en producción hereda de su infraestructura. Primero, la caché de lectura (Redis, al frente) no es solo latencia: cada acierto de caché es una consulta a la base de datos que no se paga y un egreso que no se mueve: el análogo, en la capa de infraestructura, de la caché de prompts del propio modelo. Segundo, el túnel cifrado entre nubes (VPN Gateway, Bastion, Firewall) y el perímetro de seguridad (WAF, protección DDoS) son el precio no negociable de mantener el dato sensible donde debe estar; presupuestarlos por adelantado evita la sorpresa de la factura de egreso, que es al tránsito de datos lo que el Token-Burn es al token: invisible llamada a llamada, brutal a fin de mes. Tercero, mantener el dato en on-premise o nube privada convierte un costo variable y creciente (egreso y almacenamiento gestionado en la nube pública) en uno fijo y amortizable, exactamente el cálculo que el capítulo 7 retomará al comparar el sincronizador por lotes con el flujo de eventos.
La honestidad obliga, sin embargo, al reverso: lo híbrido no es gratis ni universalmente mejor. Añade una frontera de red que operar, un plano de seguridad que auditar y una complejidad que solo se justifica cuando el volumen o la sensibilidad del dato lo exigen. Para un agente que consulta documentación pública, llevar todo a la nube es más barato y más simple. La regla es la misma que gobierna el resto del libro: la arquitectura se elige con la cuenta en la mesa, no con el entusiasmo del diagrama. El CIU mide el token; esa línea esconde una segunda factura, y que ignorarla es la versión de infraestructura de la deuda que no aparece en el balance.
Lo esencial del capítulo 1
Sección titulada «Lo esencial del capítulo 1»- El Token-Burn es silencioso por construcción: ninguna llamada parece cara; el agregado, sin sistema que lo mida, no existe para nadie.
- CIU = costo total de tokens / funcionalidades validadas en producción. El denominador es la palabra clave.
- Cinco causas: contexto inflado, modelo equivocado, bucles sin parada, sin caché, verbosidad sin gobierno. Y una palanca: lo diferible, en lote a mitad de precio.
- La caché exige prefijo byte-idéntico: un timestamp al inicio destruye el ahorro en silencio.
- Comparaciones de arquitecturas sin control de costo son marketing (Kapoor et al., 2024); el CIU es ese control aplicado a su propia casa.
- Bajo la línea del token hay una segunda factura: gateway, caché, egreso y almacenamiento. La arquitectura híbrida (inferencia elástica en la nube, datos cerca de su origen) es palanca de costo cuando el volumen o la sensibilidad lo justifican, y sobrecoste innecesario cuando no.