Capítulo 21: Cada línea de código como una responsabilidad del agente de IA y los multiagentes
El agente escribe la línea; el humano responde por ella. Esa asimetría es el corazón de todo.
La línea de código nunca es neutral
Sección titulada «La línea de código nunca es neutral»Conviene grabar un principio que subyace a toda práctica de ingeniería responsable: cada línea de código es una responsabilidad. Es un compromiso (con quien la mantendrá, con quien dependerá de ella, con el sistema que la albergará durante años), no un fragmento neutro. Cuando los agentes de IA empiezan a escribir líneas en masa, este principio no se diluye: se vuelve urgente. Porque un agente puede generar mil líneas en un minuto, pero la responsabilidad por esas mil líneas no se genera; se asume, y solo un humano puede asumirla.
La diferencia entre el código escrito por un humano y el código generado por un agente no reside en la corrección sintáctica ni en la funcionalidad inmediata (ambos pueden ser perfectos en esas dimensiones). Reside en la trazabilidad del razonamiento: cuando un humano escribe una línea, hay en su mente un modelo de por qué esa solución y no otra, qué invariantes mantiene, qué supuestos asume. Cuando un agente genera esa misma línea, el razonamiento es opaco por naturaleza; el artefacto existe, pero el proceso que lo produjo no es directamente inspeccionable.
Versión académica: Se constata que la adopción masiva de sistemas de generación de código basados en modelos de lenguaje de gran escala introduce una disociación estructural entre la velocidad de producción de artefactos de software y la capacidad de comprensión y responsabilización humana sobre dichos artefactos. Esta disociación configura lo que podría denominarse deuda epistemológica agéntica: una forma de deuda técnica cualitativamente distinta de la clásica, en la que el código es funcionalmente correcto pero cognitivamente opaco para el equipo que lo mantiene.
La asimetría fundamental: velocidad vs. responsabilización
Sección titulada «La asimetría fundamental: velocidad vs. responsabilización»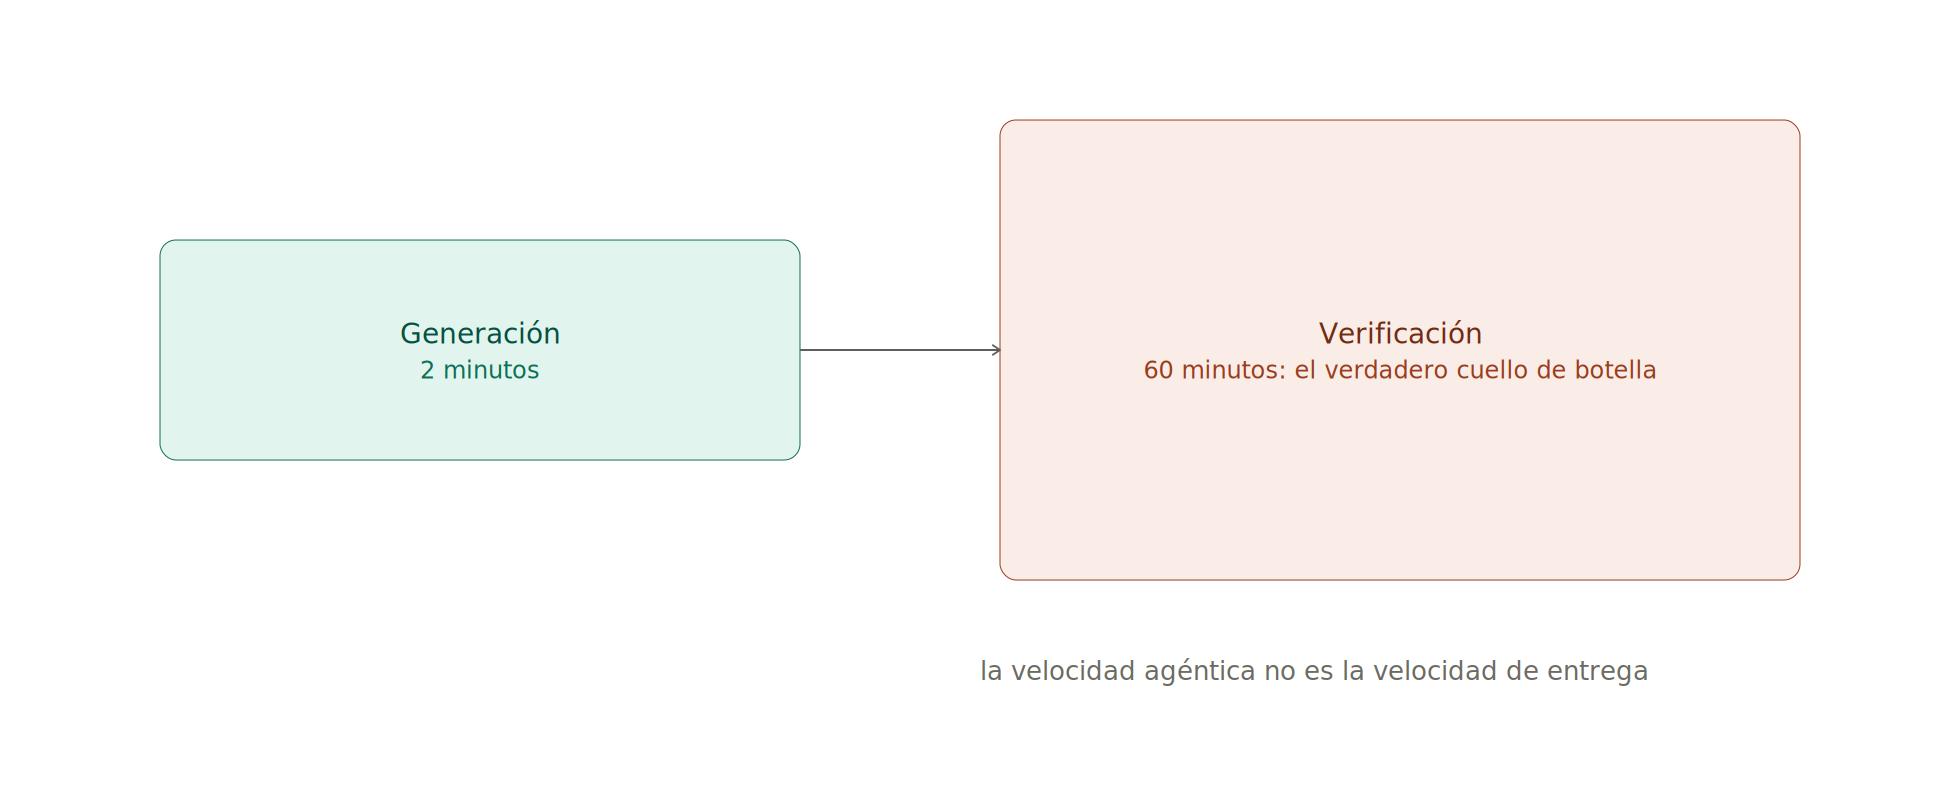
He aquí la tensión central de la programación asistida por agentes: la velocidad de generación se ha desacoplado de la velocidad de responsabilización. El agente produce código a un ritmo que ningún humano puede revisar con la misma profundidad con que lo habría escrito.
La matemática es implacable. Un agente genera 1.000 líneas en 2 minutos. Un senior engineer revisa con profundidad suficiente (comprendiendo lógica, edge cases, implicaciones de seguridad) a razón de 50 líneas por hora. El tiempo de revisión es, por tanto, 20 horas para esas 1.000 líneas. El agente contribuye 2 minutos del proceso total; el humano, 1.200 minutos. Matemáticamente: optimizar el agente de 2 minutos a 30 segundos ahorra el 0,1% del tiempo total. Optimizar la revisión humana de 20 horas a 10 horas ahorra el 50%. El cuello de botella es el juicio humano, no la generación.
Esta inversión de la intuición tiene consecuencias estratégicas profundas. Los equipos que invierten masivamente en tooling de generación sin invertir proporcionalmente en infraestructura de revisión (tests automatizados, análisis estático especializado, revisión por pares estructurada) están optimizando el 0,1% mientras descuidan el 99,9%.
Pearce et al. (2022) publicaron en el IEEE Symposium on Security and Privacy un análisis riguroso del código generado por GitHub Copilot: el 40% de los fragmentos de código generados en contextos de seguridad contenían vulnerabilidades que superaban la detección superficial. No eran errores sintácticos obvios; eran vulnerabilidades lógicas que requerían comprensión profunda del contexto de uso para ser detectadas. La implicación es directa: la revisión superficial (leer el código sin comprenderlo) no es revisión; es teatro de seguridad.
Surge así un riesgo silencioso: aceptar líneas que funcionan sin comprender por qué, acumulando un sistema cuya lógica nadie posee del todo. Esto es diferente a la deuda técnica clásica: la deuda clásica es “mal hecho pero funciona”. La deuda agéntica es “bien hecho por máquina, pero humano no lo entiende”. Es deuda epistemológica, no de calidad. Y es más peligrosa, porque el código funciona hasta que no funciona, súbitamente, sin causa obvia.
La crisis epistemológica del código sintético
Sección titulada «La crisis epistemológica del código sintético»La distinción más importante que emerge en la era agéntica es la que separa la deuda técnica clásica de la deuda epistemológica agéntica.
La deuda técnica clásica, formalizada por Ward Cunningham (1992) con su metáfora financiera, describe código que funciona pero está implementado de forma subóptima: las soluciones rápidas tomadas conscientemente con la intención de refactorizar después. Este código es comprensible (el equipo sabe por qué está mal) y la deuda es, al menos en principio, cuantificable y pagable.
La deuda epistemológica agéntica es de naturaleza diferente. El código generado por un agente puede ser perfectamente correcto en términos de funcionalidad, pasar todos los tests, cumplir todos los criterios de aceptación… y sin embargo, nadie en el equipo comprende por qué funciona. No es “mal hecho pero funciona”: es “bien hecho por máquina, pero humano no lo entiende”. Es deuda en el plano del conocimiento, no de la calidad técnica.
Lo que resulta menos evidente es que esta deuda es más peligrosa que la clásica, precisamente porque el código funciona (hasta que deja de hacerlo), y cuando falla, no hay modelo mental en el equipo que permita diagnosticar la causa. El sistema colapsa súbitamente, en producción, frente a un dato de entrada que nadie había anticipado porque nadie había razonado sobre los límites del algoritmo.
Versión académica: La deuda epistemológica agéntica representa una categoría ontológicamente distinta dentro de la taxonomía de la deuda técnica. A diferencia de la deuda de implementación (código subóptimo con lógica comprensible) y la deuda de diseño (arquitectura subóptima con decisiones rastreables), la deuda epistemológica se caracteriza por la opacidad del proceso de razonamiento que produjo el artefacto, generando una asimetría entre la calidad observable del código y la capacidad del equipo de mantenerlo responsablemente.
Taxonomía de la responsabilidad agéntica
Sección titulada «Taxonomía de la responsabilidad agéntica»La responsabilidad sobre el código agéntico no es monolítica: se distribuye en tres dimensiones que deben identificarse y asignarse explícitamente en el proceso de desarrollo:
Responsabilidad de generación. ¿Qué agente generó este código, con qué instrucciones, en qué fecha, usando qué modelo y versión? Esta dimensión es técnicamente tratable: los metadatos de generación pueden anotarse en el commit. Un esquema de anotación propuesto: @agent-generated: claude-sonnet-5 · task: implement OAuth2 flow · date: 2025-03-14 · risk-level: high.
Responsabilidad de integración. ¿Qué humano identificado revisó este código, lo comprendió y decidió integrarlo al sistema? Esta es la responsabilidad que ningún agente puede asumir. La aceptación de un pull request que contiene código agéntico sin comprensión real de su funcionamiento no es responsabilidad de integración: es su simulacro. El EU AI Act (Art. 13-14, Regulación 2024/1689) establece que la responsabilidad por sistemas de IA de alto riesgo recae en el deployer humano, no en el modelo; por extensión, la responsabilidad de integración de código agéntico en sistemas críticos recae en el ingeniero que lo aceptó.
Responsabilidad de mantenimiento. ¿Quién responderá cuando este código falle (en seis meses, en dos años, bajo condiciones que nadie anticipó) y quién tendrá el conocimiento necesario para diagnosticar y remediar? Los equipos que aceptan código agéntico sin documentar el razonamiento implícito están transfiriendo esta responsabilidad a un futuro yo que tendrá menos contexto, más presión y un sistema más complejo.
Disciplinas para responsabilizar el código agéntico
Sección titulada «Disciplinas para responsabilizar el código agéntico»Frente a esta realidad, tres disciplinas resultan no solo recomendables sino operativamente necesarias:
Revisión proporcional al riesgo. No toda línea agéntica merece el mismo escrutinio. La que toca lógica de autenticación, manejo de datos personales, transacciones financieras o control de infraestructura exige revisión profunda. La que genera un formatter de texto o calcula una suma merece verificación funcional básica. Esta diferenciación es la única forma de hacer sostenible la revisión en sistemas de generación de código a gran escala.
Comprensión antes que aceptación. La regla de oro, irrenunciable: no integrar código agéntico que no se comprende. “Funciona” no es criterio suficiente. Si nadie en el equipo puede explicar por qué este algoritmo converge, por qué este índice de base de datos es adecuado, por qué este manejo de errores es correcto, entonces nadie podrá arreglarlo cuando falle en producción.
Trazabilidad del origen. Saber qué agente generó qué, cuándo, con qué instrucciones y qué humano lo integró. Kochhar et al. (2024) proponen en ICSE un marco de accountability para desarrollo asistido por IA que incluye seis metadatos obligatorios en cada commit que contiene código agéntico: modelo usado, prompt original, criterios de aceptación aplicados, revisor humano identificado, nivel de riesgo evaluado y trazabilidad hacia el requisito de negocio correspondiente.
El programador como garante, no como mecanógrafo
Sección titulada «El programador como garante, no como mecanógrafo»En consecuencia, el rol del programador se transforma profundamente, pero no se devalúa: asciende. Deja de ser quien teclea cada línea y pasa a ser el garante de cada línea (quien decide cuáles merecen confianza, cuáles exigen revisión y cuáles deben rechazarse). Esta es, paradójicamente, una responsabilidad mayor que la de escribir. Escribir una línea exige conocimiento; responder por mil líneas que otro escribió exige criterio, y el criterio es justamente lo que distingue a un ingeniero de un generador de texto.
Esta transformación del rol tiene implicaciones directas para la evaluación del rendimiento. Los equipos que miden productividad en líneas de código generadas están evaluando la velocidad del agente, no la del ingeniero. Los equipos que miden productividad en decisiones de integración fundamentadas (código aceptado con comprensión documentada, código rechazado con justificación técnica) están evaluando la competencia real del ingeniero en la era agéntica.
Perspectiva de QA: la verificación como nueva primera línea
Sección titulada «Perspectiva de QA: la verificación como nueva primera línea»► PISTA TÉCNICA
Desde la perspectiva del Senior QA, la proliferación de código agéntico reconfigura completamente la estrategia de calidad. La verificación agéntica requiere dos capas adicionales al enfoque clásico.
La primera es la verificación de comprensión: confirmar que el equipo entiende por qué el código funciona, no solo que funciona. Esto puede hacerse mediante revisiones técnicas donde el autor explica el razonamiento del código agéntico (ejercicio que, si resulta imposible, indica que el código no debería haberse integrado).
La segunda es la verificación de límites: identificar explícitamente los supuestos del código agéntico y testear su comportamiento en los límites de esos supuestos. Los agentes optimizan para los casos de uso promedio; los QA deben cubrir los casos extremos que el agente no anticipó.
Liu et al. (2023) analizan en NeurIPS la tasa de corrección de código generado por LLMs: mientras que el 85% de los programas generados pasan los tests funcionales básicos, solo el 62% pasan suites de tests más exhaustivas que incluyen edge cases y condiciones de fallo. La brecha del 23% representa exactamente la superficie de riesgo que la revisión superficial deja expuesta.
Lo esencial del capítulo 21
Sección titulada «Lo esencial del capítulo 21»- Cada línea de código es un compromiso; con agentes, el principio se vuelve urgente porque la velocidad de generación se desacopló de la velocidad de responsabilización.
- La deuda epistemológica agéntica es más peligrosa que la técnica clásica: el código funciona hasta que falla súbitamente, sin modelo mental disponible para el diagnóstico.
- La taxonomía de responsabilidad tiene tres dimensiones: generación (¿qué agente?), integración (¿qué humano aceptó?) y mantenimiento (¿quién responderá en el futuro?).
- Las tres disciplinas irrenunciables: revisión proporcional al riesgo, comprensión antes de aceptación, trazabilidad del origen.
- El programador asciende de mecanógrafo a garante; responder por mil líneas exige más criterio que escribir una.