Capítulo 5: El playbook del orquestador, casos de uso completos
Este capítulo aterriza todo lo anterior en seis sistemas completos. Los tres primeros (revisión de código continua, asistencia de onboarding y documentación automática) son la mejor relación valor/riesgo para una primera adopción seria, y comparten una propiedad deliberada: fallan barato. Un mal review se ignora; una mala respuesta de onboarding se corrige preguntando a un colega; una mala documentación se regenera. Los tres siguientes (soporte al cliente, investigación asistida y la plataforma empresarial de agentes) elevan la apuesta: tocan usuarios externos, decisiones de negocio y la organización completa, y exigen la madurez que los tres primeros construyen. Para cada caso: el problema, la arquitectura, el código o diseño esencial y las métricas para gobernarlo.
Caso 1: Sistema de code review continuo
Sección titulada «Caso 1: Sistema de code review continuo»Contexto. Un equipo de quince ingenieros con tres a cinco pull requests diarios. El primer feedback de revisión tarda horas, bloqueando la entrega; los revisores humanos queman su atención en problemas mecánicos (estilo, errores obvios, vulnerabilidades de catálogo) en lugar de en el diseño.
Solución agéntica. Un pipeline (capítulo 8, patrón 1) disparado por cada PR: el agente revisor analiza el diff con el contexto de dominio (capítulo 6) inyectado; el agente de seguridad, en modelo económico, barre el catálogo OWASP; un sintetizador publica un comentario único, estructurado, con confianza declarada por hallazgo. Los hallazgos de confianza baja se marcan como tales en lugar de omitirse (capítulo 5).
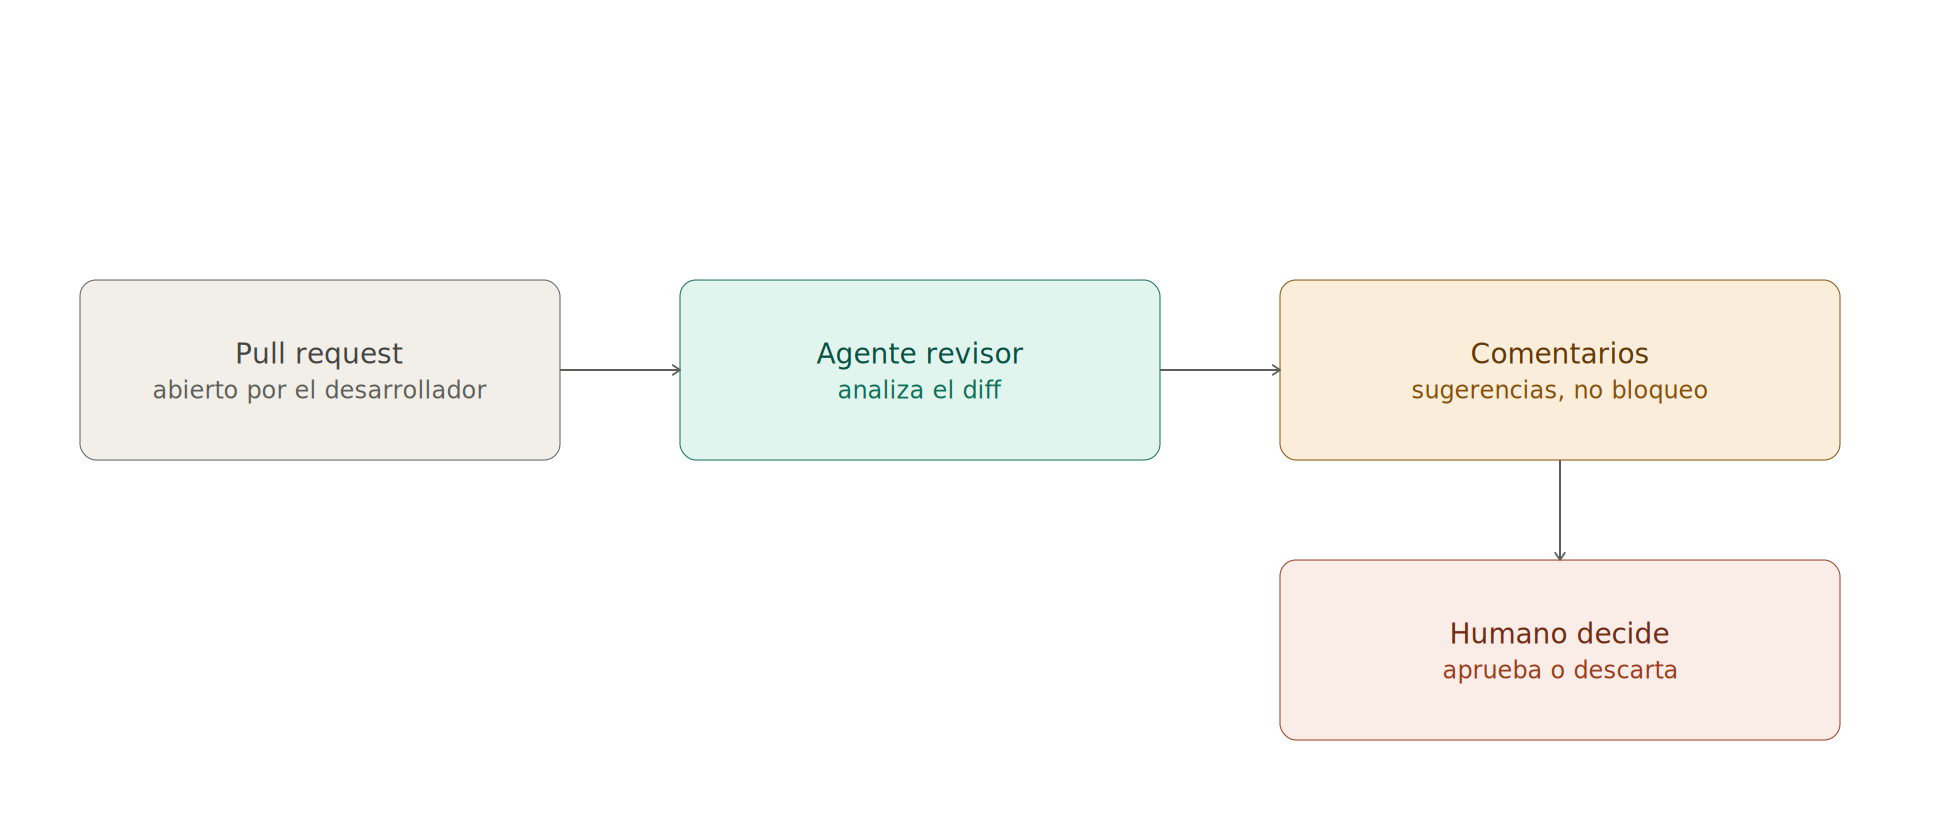
El punto de diseño decisivo: el sistema comenta, no bloquea. El humano decide. Esto mantiene al sistema en la categoría de «falla barato» y construye la confianza del equipo con evidencia: la fracción de comentarios útiles se mide con reacciones (👍/👎) que alimentan la suite de evals (capítulo 13).
Resultados típicos del patrón (rangos observados en implantaciones del patrón; los valores exactos dependen del equipo y del repositorio): primer feedback en minutos en lugar de horas; detección temprana de una fracción sustancial de los defectos mecánicos antes de la revisión humana; costo por PR de centavos: calcúlelo con su propio CIUTracker y compárelo con el costo de una hora de ingeniero senior. La evidencia pública sobre asistencia de IA en tareas de desarrollo respalda la dirección del efecto (Peng et al., 2023; Ziegler et al., 2024); la magnitud en su equipo la dirá su instrumentación, no este libro.
Caso 2: Asistente de onboarding técnico
Sección titulada «Caso 2: Asistente de onboarding técnico»Problema. Un ingeniero nuevo tarda semanas en ser productivo, y durante ese tiempo consume el recurso más caro del equipo: la atención de los seniors, respondiendo preguntas cuya respuesta ya está escrita (en el wiki, en los ADRs, en los commits) pero es inencontrable.
Solución. Un agente RAG (Lewis et al., 2020) con acceso de solo lectura a: documentación interna, historial de commits, tickets resueltos y código. Responde con citas a sus fuentes (el anclaje que mitiga la alucinación; Ji et al., 2023) y, cuando no sabe, lo dice y sugiere a quién preguntar.
# Ejemplo 5.1: Agente de onboarding con RAG.# Clave del diseño: responde SOLO desde los documentos recuperados,# cita las fuentes, y declara cuando no sabe.
import anthropic
client = anthropic.Anthropic()
def onboarding_agent(pregunta: str, contexto_engineer: dict,                     vector_store) -> str:    docs = vector_store.search(pregunta, top_k=5)    fuentes = "\n\n".join(        f"[FUENTE {i+1}: {d['path']}]\n{d['content']}"        for i, d in enumerate(docs)    )
    response = client.messages.create(        model="claude-opus-4-8",        max_tokens=2048,        system=f"""Eres el mentor técnico de {contexto_engineer['nombre']},        que se unió al equipo hace {contexto_engineer['dias_en_empresa']} días.        Su background: {contexto_engineer['background']}.
        REGLAS:        1. Responde ÚNICAMENTE con información de las fuentes proporcionadas.        2. Cita la fuente de cada afirmación: [FUENTE n].        3. Si las fuentes no contienen la respuesta, dilo explícitamente           y sugiere a quién preguntar. NUNCA inventes información           sobre el sistema.""",        messages=[{            "role": "user",            "content": f"{pregunta}\n\nFuentes internas relevantes:\n{fuentes}",        }],    )    return next(b.text for b in response.content if b.type == "text")
Métricas de gobierno: fracción de preguntas respondidas con cita verificable; tasa de «no sé» (un «no sé» honesto es un éxito del sistema, no un fallo); horas de senior liberadas por semana, medidas por encuesta breve.
Caso 3: Documentación técnica que no se desactualiza
Sección titulada «Caso 3: Documentación técnica que no se desactualiza»Problema. La documentación siempre está desactualizada, porque mantenerla compite con entregar funcionalidades, y pierde siempre.
Solución. Un skill de generación (capítulo 7, patrón 2) ejecutado en el CI tras cada merge a la rama principal: detecta los archivos modificados, regenera la documentación de las interfaces públicas afectadas y abre un PR de documentación que un humano aprueba en segundos. El procesamiento es asíncrono: candidato perfecto para la API batch a mitad de precio (capítulo 11).
# .claude/skills/auto-docs.md (extracto del procedimiento)### Proceso1. `git diff HEAD~1 HEAD --name-only` -> archivos cambiados2. Para cada archivo Python/TypeScript modificado: a. Leer el archivo actual b. Identificar funciones/clases públicas nuevas o modificadas c. Generar docstring + ejemplo de uso d. Actualizar el archivo docs/ correspondiente3. Abrir un PR con los cambios de docs/ (nunca commit directo a main)El detalle que importa: el agente abre un PR, no escribe directo a la rama principal. El costo de la aprobación humana es de segundos; el valor (que ningún error del agente llegue a la documentación canónica sin ojos humanos) es el principio de los capítulos 14 y 19 aplicado a un caso cotidiano.
Caso 4: Soporte al cliente con escalamiento honesto
Sección titulada «Caso 4: Soporte al cliente con escalamiento honesto»Problema. Un equipo de soporte atiende consultas donde el 60–70 % son repetitivas (estado de pedidos, configuración, facturación) y el resto exige juicio humano. Los chatbots de la generación anterior fracasaron por un defecto de diseño: no sabían no saber.
Arquitectura. Un enrutador económico clasifica cada consulta en tres rutas. Ruta verde: consultas resueltas con herramientas de solo lectura (estado del pedido vía API, artículos de ayuda vía RAG con citas): el agente responde directamente. Ruta amarilla: el agente redacta una propuesta de respuesta que un humano aprueba con un clic, el patrón del caso 3 aplicado a clientes. Ruta roja: escalamiento inmediato a humano con el contexto ya recopilado y resumido, y la contribución del agente es que el cliente no repita su historia. La regla de diseño que gobierna todo: ante duda de ruta, la más conservadora. El umbral de confianza del enrutador es configuración versionada, no juicio del modelo.
Las métricas que importan: y las que engañan: la tasa de resolución automática es la métrica vanidosa; sube fácilmente empeorando el sistema (respuestas seguras pero inútiles). Las honestas: tasa de reapertura por ruta (¿la respuesta verde resolvió de verdad?), tasa de escalamiento correcto (muestreada por humanos: ¿la ruta roja era roja?), y satisfacción medida por ruta, nunca agregada. El costo por consulta (centavos en la ruta verde) se compara contra el costo del canal humano solo para las consultas que el humano ya no atiende; comparar promedios totales es contabilidad creativa.
Por qué este caso es el cuarto y no el primero: toca clientes. Exige la suite de evals madura (capítulo 13), los guardarraíles del capítulo 4 (el canal de soporte es superficie de inyección directa por definición) y una política de acciones críticas (capítulo 1 (Vol. 3)): el agente de soporte propone reembolsos; jamás los ejecuta.
Caso 5: El agente de investigación con citas o silencio
Sección titulada «Caso 5: El agente de investigación con citas o silencio»Problema. Decisiones técnicas y de producto que exigen sintetizar fuentes dispersas (documentación, comparativas, literatura, discusiones internas) consumen días de las personas más caras de la organización, y el resultado suele vivir en un hilo de chat que nadie reencuentra.
Arquitectura. Un pipeline de tres fases con presupuesto explícito por fase. Recolección: búsqueda paralela (fan-out, capítulo 8) sobre fuentes internas (RAG) y externas (búsqueda web con herramientas), con límite de fuentes y de tokens. Síntesis: el modelo de gama alta produce un informe estructurado donde cada afirmación lleva su fuente: la regla del onboarding (caso 2) elevada a entregable. Contraste: un segundo agente (el adversario del patrón council) busca activamente evidencia contraria a las conclusiones del primero y anexa las tensiones encontradas. Esta tercera fase, que casi todos omiten por costo, es la que separa un informe útil de uno peligroso: la práctica de la refutación con evidencia (entender la tesis antes de rebatirla, respaldar cada refutación con pruebas) aplicada por diseño (véase «Obra pública del autor»).
Las métricas: fracción de afirmaciones con fuente verificable (auditada por muestreo); tasa de alucinación detectada en el contraste (si es cero sostenido, el adversario no está trabajando); tiempo de experto ahorrado, medido por encuesta; y el límite duro de presupuesto por informe: la investigación es el caso de uso con mayor riesgo de Token-Burn del catálogo, porque «buscar un poco más» siempre parece justificado.
Caso 6: La plataforma empresarial de agentes
Sección titulada «Caso 6: La plataforma empresarial de agentes»Problema. Tras los casos 1 a 5, la organización tiene media docena de agentes en producción, y cada uno nació con su propia infraestructura. El problema ya no es construir agentes: es que veinte equipos puedan construirlos sin repetir los errores que los primeros cinco ya pagaron.
Arquitectura. Este caso no añade un agente: añade el producto interno que los contiene a todos, y es la culminación del libro entero. Sus componentes son los capítulos anteriores convertidos en servicio: el gateway multiproveedor con presupuestos (capítulo 3) como única puerta; el catálogo de servidores MCP con dueños y revisión de seguridad (capítulo 9); la biblioteca de skills y prompts maestros versionados (capítulos 5 y 7); el arnés de evals como servicio de CI (capítulo 13); la observabilidad con trazas y señales sintéticas (capítulo 8); y el registro de agentes con propietario humano nombrado, lista de acciones críticas y auditoría (capítulos 14 y 19). El equipo de plataforma lo opera como producto: con hoja de ruta, usuarios internos y métricas de adopción (Skelton & Pais, 2019).
La métrica que resume todas: el tiempo desde «un equipo tiene una idea de agente» hasta «ese agente opera en producción gobernado»: con inventario, presupuesto, evals y dueño. Sin plataforma se mide en meses y el gobierno es opcional; con ella, en días y el gobierno es el camino de menor resistencia. Esa inversión, hacer que lo correcto sea lo fácil, es la definición operativa de una plataforma madura, y el estado final al que este playbook conduce.
Caso 7: Paralelismo de enjambre multiproveedor
Sección titulada «Caso 7: Paralelismo de enjambre multiproveedor»El problema que introduce este caso
Sección titulada «El problema que introduce este caso»Los casos 1 a 6 asumen que un agente, o un grupo pequeño y homogéneo, basta. A partir de cierto volumen (procesar miles de tickets, refactorizar un monorepo completo, investigar en paralelo docenas de fuentes) la restricción deja de ser el modelo y pasa a ser cuántos agentes puede coordinar un solo orquestador sin perder consistencia. Este caso documenta cómo los cuatro proveedores más relevantes resuelven ese problema hoy, con la sintaxis real de cada uno, para que la decisión de a cuál enjambre acoplarse sea de ingeniería y no de preferencia de marca.
Arquitectura común, sintaxis distinta Los cuatro convergen en el mismo patrón: un orquestador descompone la tarea, reparte subtareas independientes a trabajadores que corren en paralelo, y una fase de síntesis reúne los resultados, el mismo fan-out/gather del capítulo 8, ahora expuesto como primitiva de SDK en vez de patrón dibujado a mano. El principio de Backend Agnóstico (Vol. 2) exige tratar esa primitiva como intercambiable:
Sección titulada «Arquitectura común, sintaxis distinta Los cuatro convergen en el mismo patrón: un orquestador descompone la tarea, reparte subtareas independientes a trabajadores que corren en paralelo, y una fase de síntesis reúne los resultados, el mismo fan-out/gather del capítulo 8, ahora expuesto como primitiva de SDK en vez de patrón dibujado a mano. El principio de Backend Agnóstico (Vol. 2) exige tratar esa primitiva como intercambiable:»- Claude (Agent SDK / Claude Code). El Task tool despacha subagentes desde una conversación; cada uno corre en su propio contexto y, si toca archivos, en su propio git worktree para evitar colisiones de escritura. Para enjambres que superan lo que una sola conversación puede coordinar turno a turno, el SDK expone un Workflow tool: Claude escribe el guion de orquestación en código y lo entrega a un runtime que lo ejecuta en segundo plano, con tres primitivas,
agent()para un trabajador individual,parallel()como barrera de sincronización, ypipeline()para encadenar resultados sin barrera.
// Extracto conceptual de un workflow del Agent SDKconst hallazgos = await parallel([ agent('investigador-A', { fuente: 'documentacion-interna' }), agent('investigador-B', { fuente: 'busqueda-web' }), agent('investigador-C', { fuente: 'issues-github' }),]);const informe = await agent('sintesis', { entradas: hallazgos });- OpenAI (Agents SDK). El primitivo de coordinación es el handoff: un agente cede el control a otro, tratándolo casi como una herramienta más, sin un despachador jerárquico central. Para trabajo verdaderamente paralelo, el SDK ejecuta agentes o llamadas a herramientas en paralelo y agrega los resultados; los guardrails (validaciones de entrada y salida) corren también en paralelo con la llamada principal, para fallar rápido sin penalizar la latencia del camino feliz.
from agents import Agent, handoff
triage = Agent( name="Triage", handoffs=[handoff(investigador_a), handoff(investigador_b)],)- Google (Agent Development Kit). Es el más explícito de los cuatro:
ParallelAgentejecuta sub-agentes en ramas aisladas (sin memoria compartida entre ellas durante la ejecución) y cada uno escribe su resultado en una clave de estado de sesión (output_key) que un agente final, normalmente unSequentialAgent, lee para sintetizar. El despacho a un sub-agente es una llamada a función tipada (transfer_to_agent), lo que hace que las fallas de coordinación aparezcan en la traza como fallas de tool-calling ordinarias, auditables con el mismo tablero que audita cualquier otra herramienta.
from google.adk.agents import ParallelAgent, SequentialAgent
recoleccion = ParallelAgent( name="recoleccion", sub_agents=[investigador_a, investigador_b, investigador_c],)pipeline = SequentialAgent(sub_agents=[recoleccion, sintesis])- Kimi K2.6 (Moonshot AI, código abierto). Es el más agresivo en escala y el más relevante para Backend Agnóstico por precio: su modo Agent Swarm despacha hasta 300 subagentes especializados y encadena hasta 4.000 pasos de herramienta en una sola corrida autónoma, a una fracción del costo por token de los tres anteriores (Moonshot reporta reducciones de tiempo de ejecución de hasta 80% frente a un solo agente). No expone una clase
ParallelAgentpropia: la paralelización ocurre dentro de la llamada a herramientas, el modelo devuelve varias entradas en un mismo arreglotool_callscuando detecta subtareas independientes, y el cliente las ejecuta y responde en el mismo turno.
La tabla que un comité de arquitectura necesita ver
Sección titulada «La tabla que un comité de arquitectura necesita ver»| Proveedor | Primitiva de paralelismo | Techo documentado | Aislamiento entre trabajadores | Coste relativo |
|---|---|---|---|---|
| Claude (Agent SDK) | parallel() / pipeline() en Workflow tool; Task tool para subagentes en conversación |
Decenas, acotado por el diseño de la tarea, no por el SDK | Contexto propio; worktree de git opcional | Alto (frontera) |
| OpenAI (Agents SDK) | Handoffs + ejecución paralela de agentes y herramientas | Sin límite duro publicado | Sesión propia por agente | Alto (frontera) |
| Google (ADK) | ParallelAgent con output_key + SequentialAgent de síntesis |
Sin límite duro publicado | Ramas aisladas, sin memoria compartida | Medio-alto |
| Kimi K2.6 (Moonshot) | Agent Swarm dentro de tool_calls |
300 subagentes / 4.000 pasos (documentado) | Por subagente especializado | Bajo (código abierto) |
Por qué esto refuerza el Backend Agnóstico y no lo contradice Ningún proveedor inventó el patrón: los cuatro implementan la misma pareja orquestador-trabajador que el capítulo 8 describió antes de que existiera una sola línea de SDK para ella. Lo que cambia entre filas de la tabla es la sintaxis de despacho y el techo de escala, no la arquitectura de fondo. Un gateway multiproveedor bien diseñado (capítulo 3) no adopta un SDK de enjambre como decisión de plataforma: expone una interfaz interna de “despachar N subtareas independientes y sintetizar” y traduce esa interfaz al SDK vigente. Cuando el sucesor de Kimi K2.6 o el de Astra publiquen un techo de mil subagentes, el cambio se absorbe en esa capa de traducción, sin tocar el código que orquesta el negocio.
Sección titulada «Por qué esto refuerza el Backend Agnóstico y no lo contradice Ningún proveedor inventó el patrón: los cuatro implementan la misma pareja orquestador-trabajador que el capítulo 8 describió antes de que existiera una sola línea de SDK para ella. Lo que cambia entre filas de la tabla es la sintaxis de despacho y el techo de escala, no la arquitectura de fondo. Un gateway multiproveedor bien diseñado (capítulo 3) no adopta un SDK de enjambre como decisión de plataforma: expone una interfaz interna de “despachar N subtareas independientes y sintetizar” y traduce esa interfaz al SDK vigente. Cuando el sucesor de Kimi K2.6 o el de Astra publiquen un techo de mil subagentes, el cambio se absorbe en esa capa de traducción, sin tocar el código que orquesta el negocio.»Astra como caso de estudio del límite superior GPT-6 Astra (OpenAI, septiembre 2026) no introduce una primitiva de SDK nueva (usa el mismo Agents SDK descrito arriba), pero es la prueba de campo más citada de hasta dónde escala el patrón: evaluadores independientes documentan corridas de 20 a 96 subagentes coordinados por un único agente gestor, aplicados a tareas de mantenimiento (etiquetar datos, leer logs, depurar despliegues, mantener pipelines saturados) a un costo medido bajo los seis dólares por hora de cómputo. Esto automatiza justamente la porción del trabajo del AI Engineer (capítulo 2) que ese capítulo ya identificaba como de menor valor añadido: la supervisión rutinaria de corridas. Deja intacta la porción que el capítulo 2 exige que siga siendo humana, el criterio arquitectónico, la verificación de lo irreversible y la responsabilidad de la firma. El Platform Engineer (capítulo 3) cubre un terreno distinto al de Astra: decide dónde se permite que un enjambre de 96 agentes actúe sin supervisión síncrona, y dónde no.
Sección titulada «Astra como caso de estudio del límite superior GPT-6 Astra (OpenAI, septiembre 2026) no introduce una primitiva de SDK nueva (usa el mismo Agents SDK descrito arriba), pero es la prueba de campo más citada de hasta dónde escala el patrón: evaluadores independientes documentan corridas de 20 a 96 subagentes coordinados por un único agente gestor, aplicados a tareas de mantenimiento (etiquetar datos, leer logs, depurar despliegues, mantener pipelines saturados) a un costo medido bajo los seis dólares por hora de cómputo. Esto automatiza justamente la porción del trabajo del AI Engineer (capítulo 2) que ese capítulo ya identificaba como de menor valor añadido: la supervisión rutinaria de corridas. Deja intacta la porción que el capítulo 2 exige que siga siendo humana, el criterio arquitectónico, la verificación de lo irreversible y la responsabilidad de la firma. El Platform Engineer (capítulo 3) cubre un terreno distinto al de Astra: decide dónde se permite que un enjambre de 96 agentes actúe sin supervisión síncrona, y dónde no.»Caso 8: Promoción entre entornos y dependencias entre equipos y terceros
Sección titulada «Caso 8: Promoción entre entornos y dependencias entre equipos y terceros»El problema que introduce este caso
Sección titulada «El problema que introduce este caso»Los siete casos anteriores describen arquitectura dentro de un entorno. En la práctica, todo agente nace en desarrollo, pasa por stage, a veces por QA como entorno separado, y solo al final llega a producción, y en cada salto cambian las credenciales, el presupuesto de tokens, la superficie de fallo tolerable y, sobre todo, a qué servidores MCP de otros equipos o de terceros tiene acceso. Un agente que en desarrollo llama sin fricción al servidor MCP de facturación del equipo de Pagos no puede heredar ese acceso en producción sin que Pagos lo sepa, lo apruebe y le asigne su propio presupuesto de error. Este es el caso donde la mayoría de los incidentes de este libro empiezan: no por un mal diseño del agente, sino por un salto de entorno que nadie modeló.
El entorno como parámetro de autonomía, no solo de configuración Lo que suele variar entre entornos (URLs, claves, límites de tasa) sigue variando aquí, pero se le añade una dimensión que casi ningún equipo versiona explícitamente: el techo de autonomía permitido por el marco de niveles del capítulo 1. Un mismo agente puede operar en Nivel 3 (herramientas, con presupuesto) en desarrollo y estar restringido a Nivel 1 (cadena fija, revisada) en producción hasta acumular evidencia suficiente.
Sección titulada «El entorno como parámetro de autonomía, no solo de configuración Lo que suele variar entre entornos (URLs, claves, límites de tasa) sigue variando aquí, pero se le añade una dimensión que casi ningún equipo versiona explícitamente: el techo de autonomía permitido por el marco de niveles del capítulo 1. Un mismo agente puede operar en Nivel 3 (herramientas, con presupuesto) en desarrollo y estar restringido a Nivel 1 (cadena fija, revisada) en producción hasta acumular evidencia suficiente.»| Entorno | Techo de autonomía | Acceso a MCP de terceros | Quién aprueba el ascenso |
|---|---|---|---|
| Desarrollo | Nivel 3–4 (agente con herramientas o multiagente) | Sandboxes o mocks del contrato, nunca el servicio real | El propio equipo |
| Stage | Nivel 2–3 | Réplica del servicio real con datos sintéticos | El equipo, con revisión de plataforma |
| QA | Nivel 2 | Servicio real de terceros, en modo shadow (solo lectura, sin escritura) | Plataforma + dueño del servicio dependido |
| Producción | El nivel que la evidencia de QA sostenga, nunca más | Servicio real, con presupuesto y alcance firmados por el equipo dueño | Comité de arquitectura o su delegado (capítulo 6) |
El ascenso de un entorno a otro no es un deploy más: es una solicitud de autonomía que debe presentar su propia evidencia, con el mismo rigor que el capítulo 6 exige para el arnés de evals.
Dependencias entre equipos: el contrato de MCP versionado El catálogo de servidores MCP con dueños (capítulo 9, retomado en el caso 6) resuelve quién es responsable de cada herramienta, pero no resuelve qué pasa cuando ese dueño cambia la forma de su herramienta. La respuesta, tomada de una disciplina ya madura en APIs REST, es el contrato dirigido por el consumidor (consumer-driven contract testing, popularizado por herramientas como Pact): cada equipo que consume el servidor MCP de otro publica, junto a su propio agente, un contrato ejecutable de lo que espera recibir. El pipeline del equipo dueño corre esos contratos antes de cada cambio; si el contrato de otro equipo se rompe, el CI/CD lo bloquea antes de llegar a stage, no después de que el agente consumidor falle en producción sin que nadie entienda por qué.
Sección titulada «Dependencias entre equipos: el contrato de MCP versionado El catálogo de servidores MCP con dueños (capítulo 9, retomado en el caso 6) resuelve quién es responsable de cada herramienta, pero no resuelve qué pasa cuando ese dueño cambia la forma de su herramienta. La respuesta, tomada de una disciplina ya madura en APIs REST, es el contrato dirigido por el consumidor (consumer-driven contract testing, popularizado por herramientas como Pact): cada equipo que consume el servidor MCP de otro publica, junto a su propio agente, un contrato ejecutable de lo que espera recibir. El pipeline del equipo dueño corre esos contratos antes de cada cambio; si el contrato de otro equipo se rompe, el CI/CD lo bloquea antes de llegar a stage, no después de que el agente consumidor falle en producción sin que nadie entienda por qué.»Dependencias con terceros externos: el mismo principio, con menos control Cuando el servidor MCP no pertenece a otro equipo interno sino a un proveedor externo (un banco, una pasarela de pagos, una API gubernamental como las del caso sectorial), el contrato ejecutable rara vez es negociable. Lo que sí es negociable es el presupuesto de degradación: definir por adelantado qué hace el agente cuando el tercero cambia sin aviso, responde más lento de lo esperado o directamente cae (modo de solo lectura, cola de reintento con backoff, o escalamiento inmediato a un humano) y probar ese modo degradado en stage con el mismo rigor que se prueba el camino feliz. Un enjambre de 96 agentes coordinados (caso 7) que depende de un tercero sin modo degradado no es un enjambre resiliente: es una única API externa con un multiplicador de daño.
Sección titulada «Dependencias con terceros externos: el mismo principio, con menos control Cuando el servidor MCP no pertenece a otro equipo interno sino a un proveedor externo (un banco, una pasarela de pagos, una API gubernamental como las del caso sectorial), el contrato ejecutable rara vez es negociable. Lo que sí es negociable es el presupuesto de degradación: definir por adelantado qué hace el agente cuando el tercero cambia sin aviso, responde más lento de lo esperado o directamente cae (modo de solo lectura, cola de reintento con backoff, o escalamiento inmediato a un humano) y probar ese modo degradado en stage con el mismo rigor que se prueba el camino feliz. Un enjambre de 96 agentes coordinados (caso 7) que depende de un tercero sin modo degradado no es un enjambre resiliente: es una única API externa con un multiplicador de daño.»El registro de dependencias, no solo de agentes El registro de agentes con dueño humano nombrado (capítulo 6, caso 6) se extiende aquí a un registro de dependencias: por cada agente en producción, qué servidores MCP internos y externos consume, con qué nivel de autonomía, y qué modo degradado tiene si cada uno falla. Cuando el equipo de Pagos anuncia que retira una versión de su servidor MCP, este registro es lo que permite responder en minutos «estos tres agentes de estos dos equipos dependen de ella» en vez de descubrirlo por un incidente en producción.
Sección titulada «El registro de dependencias, no solo de agentes El registro de agentes con dueño humano nombrado (capítulo 6, caso 6) se extiende aquí a un registro de dependencias: por cada agente en producción, qué servidores MCP internos y externos consume, con qué nivel de autonomía, y qué modo degradado tiene si cada uno falla. Cuando el equipo de Pagos anuncia que retira una versión de su servidor MCP, este registro es lo que permite responder en minutos «estos tres agentes de estos dos equipos dependen de ella» en vez de descubrirlo por un incidente en producción.»En suma, los nueve casos forman una escalera deliberada. Los tres primeros enseñan las capacidades básicas con riesgo acotado: agentes que leen (caso 1), que responden desde conocimiento interno (caso 2), que escriben con aprobación humana (caso 3). Los cinco siguientes las componen a escala: hacia el cliente (caso 4), hacia las decisiones (caso 5), hacia la organización entera (caso 6), hacia el techo de paralelismo que cada proveedor permite hoy (caso 7), hacia el cruce de entornos y equipos que decide si todo lo anterior sobrevive a producción (caso 8), y hacia la operación desatendida o remota que libera al humano del escritorio sin liberarlo de la responsabilidad (caso 9). Cada peldaño reutiliza la infraestructura del anterior (gateway, evals, auditoría) y produce los datos de CIU para decidir si el siguiente peldaño vale su costo. Saltarse peldaños es posible; pagarlos dos veces, lo habitual.
Caso 9: Agentes de fondo a escala y orquestación remota
Sección titulada «Caso 9: Agentes de fondo a escala y orquestación remota»El problema que introduce este caso
Sección titulada «El problema que introduce este caso»Los ocho casos anteriores asumen que alguien está frente a la pantalla dirigiendo al agente. A partir de cierta escala organizacional, esa suposición se rompe: la tarea es demasiado grande para una sesión interactiva (miles de migraciones en un monorepo de veinte millones de líneas) o el ingeniero responsable simplemente no está frente a su computadora cuando el agente necesita una decisión. Este caso documenta cómo dos soluciones reales, de naturaleza distinta, resuelven cada mitad del problema.
Spotify: el agente de fondo como trabajador de plantilla, no como copiloto Spotify opera un agente de codificación construido sobre el Claude Agent SDK que corre en segundo plano, no en una sesión interactiva: recibe una tarea de migración (actualizar una dependencia, propagar un cambio de API a través de miles de servicios), la ejecuta sin supervisión síncrona, y abre un pull request para revisión humana. La cifra que hace tangible la escala: más de 650 PRs generados por este agente se fusionan a producción cada mes, sobre una base de código de más de veinte millones de líneas (Spotify Engineering, 2026). Los prompts que dirigen al agente viven versionados en Git (el mismo patrón de migraciones del capítulo 8 aplicado a la fuente, no solo al historial de aplicación), y un bot de Slack dispara tareas puntuales para casos que no ameritan una ejecución programada.
Sección titulada «Spotify: el agente de fondo como trabajador de plantilla, no como copiloto Spotify opera un agente de codificación construido sobre el Claude Agent SDK que corre en segundo plano, no en una sesión interactiva: recibe una tarea de migración (actualizar una dependencia, propagar un cambio de API a través de miles de servicios), la ejecuta sin supervisión síncrona, y abre un pull request para revisión humana. La cifra que hace tangible la escala: más de 650 PRs generados por este agente se fusionan a producción cada mes, sobre una base de código de más de veinte millones de líneas (Spotify Engineering, 2026). Los prompts que dirigen al agente viven versionados en Git (el mismo patrón de migraciones del capítulo 8 aplicado a la fuente, no solo al historial de aplicación), y un bot de Slack dispara tareas puntuales para casos que no ameritan una ejecución programada.»Lo que hace transferible este caso, más allá de la cifra, es la arquitectura: el agente de fondo no reemplaza el patrón fan-out del capítulo 8 (Vol. 1), lo despliega a la escala de una organización completa de ingeniería. Cada PR que produce es, en efecto, un trabajador anónimo de un enjambre implícito, con el mismo requisito de aspecto de trazabilidad del capítulo 8: sin un registro de qué prompt versionado produjo cada PR, ese volumen sería imposible de auditar cuando algo sale mal.
Orquestación remota: el mismo patrón, con el humano en movimiento El segundo problema (el ingeniero que necesita intervenir pero no está en su escritorio) lo resuelve una capacidad distinta: control remoto de una sesión de Claude Code desde el teléfono (claude --remote-control, en vista previa desde febrero de 2026), que genera un código QR o enlace para continuar la sesión desde la app móvil o el navegador. La sesión sigue corriendo en la máquina local del ingeniero (el sistema de archivos, los servidores MCP y las herramientas nunca salen de ahí); el teléfono es solo la interfaz para aprobar acciones, encolar tareas o redirigir el trabajo a mitad de camino.
Sección titulada «Orquestación remota: el mismo patrón, con el humano en movimiento El segundo problema (el ingeniero que necesita intervenir pero no está en su escritorio) lo resuelve una capacidad distinta: control remoto de una sesión de Claude Code desde el teléfono (claude --remote-control, en vista previa desde febrero de 2026), que genera un código QR o enlace para continuar la sesión desde la app móvil o el navegador. La sesión sigue corriendo en la máquina local del ingeniero (el sistema de archivos, los servidores MCP y las herramientas nunca salen de ahí); el teléfono es solo la interfaz para aprobar acciones, encolar tareas o redirigir el trabajo a mitad de camino.»Guía mínima para probarlo
Sección titulada «Guía mínima para probarlo»- Iniciar una sesión de Claude Code en la máquina de trabajo con la bandera de control remoto activada.
- Escanear el código QR generado desde la app móvil de Claude.
- Definir de antemano qué acciones requieren aprobación explícita desde el teléfono (la valla de permisos del capítulo 20, Vol. 3, sigue aplicando igual desde un celular que desde un teclado).
- Usar la cola de tareas para dejar trabajo preparado que el agente ejecute apenas se libere presupuesto de cómputo, sin necesidad de que el ingeniero esté presente al iniciar.
Por qué estos dos casos son la misma arquitectura, no dos herramientas distintas El agente de fondo de Spotify elimina al humano del bucle síncrono para tareas de bajo riesgo y alto volumen; el control remoto mantiene al humano en el bucle, pero lo desacopla de un escritorio fijo. Ambos son variaciones del mismo principio del capítulo 5, caso 8: el techo de autonomía no es una propiedad del agente, es una decisión de arquitectura sobre cuándo y desde dónde se ejerce la supervisión humana.
Sección titulada «Por qué estos dos casos son la misma arquitectura, no dos herramientas distintas El agente de fondo de Spotify elimina al humano del bucle síncrono para tareas de bajo riesgo y alto volumen; el control remoto mantiene al humano en el bucle, pero lo desacopla de un escritorio fijo. Ambos son variaciones del mismo principio del capítulo 5, caso 8: el techo de autonomía no es una propiedad del agente, es una decisión de arquitectura sobre cuándo y desde dónde se ejerce la supervisión humana.»Caso 10 (sectorial): agentes acotados en un sistema de misión crítica
Sección titulada «Caso 10 (sectorial): agentes acotados en un sistema de misión crítica»Los nueve casos anteriores son horizontales: aplican a casi cualquier organización de software. Cierra el capítulo un caso vertical (un sistema de misión crítica en un dominio regulado y de alto riesgo) porque enseña una lección que los horizontales no pueden: en estos sistemas, la pregunta correcta es «¿dónde no debe haber uno, y cuán estrecho debe ser donde sí?», no «¿dónde meto un agente?». El ejemplo, basado en una arquitectura que el autor diseñó y publicó (véase «Obra pública del autor»), es una plataforma para reportar denuncias de extorsión que integra ciudadanía, policía, fiscalía e incluso captura de datos por IoT y drones.
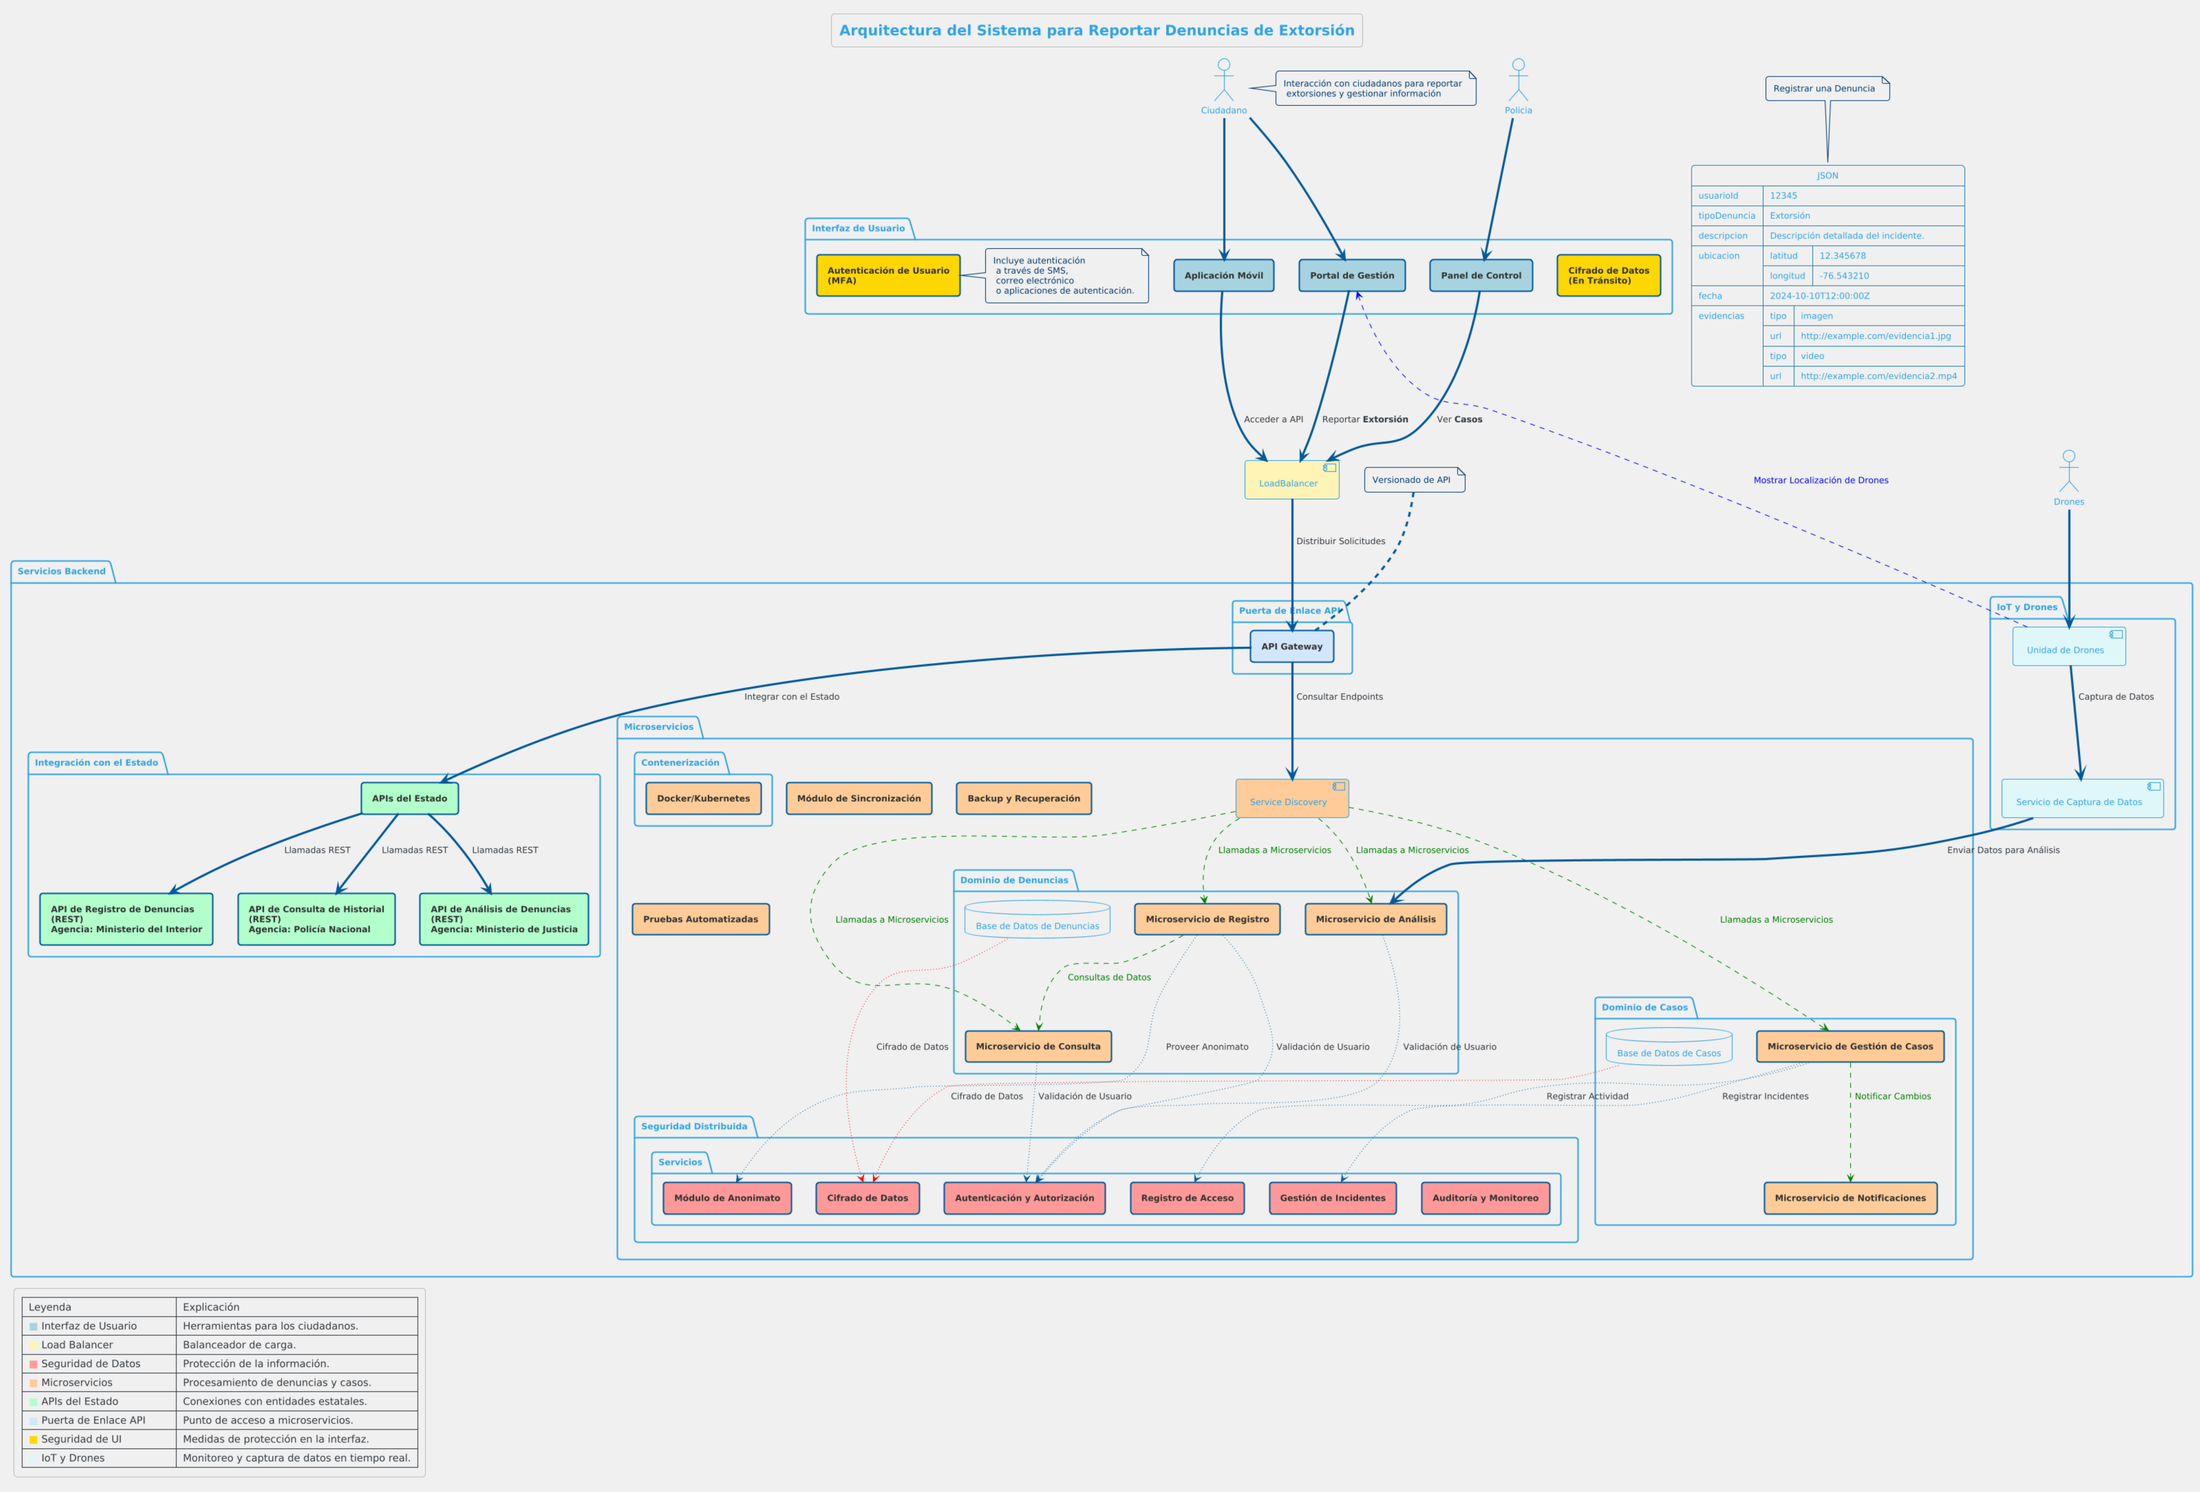
Lo primero que enseña el diagrama es cuánto no es IA El entorno PCI con autenticación multifactor, el balanceador y el versionado de API, los microservicios separados por dominio (registro, análisis, consulta, gestión de casos, notificaciones), la integración por REST con las APIs del Ministerio del Interior, la Policía Nacional y la Fiscalía, y la capa de seguridad distribuida (anonimato del denunciante, cifrado en tránsito y en reposo, registro de acceso, auditoría y monitoreo) son ingeniería clásica, y deben seguir siéndolo. En un sistema donde un fallo pone en riesgo la integridad física de una persona, el determinismo no es una preferencia de estilo: es un requisito de seguridad. La regla del capítulo 1 (Vol. 3) (el agente propone, el humano aprueba lo irreversible) aquí se endurece a un principio de diseño: ninguna acción con consecuencia legal o de seguridad cuelga de una decisión probabilística.
Sección titulada «Lo primero que enseña el diagrama es cuánto no es IA El entorno PCI con autenticación multifactor, el balanceador y el versionado de API, los microservicios separados por dominio (registro, análisis, consulta, gestión de casos, notificaciones), la integración por REST con las APIs del Ministerio del Interior, la Policía Nacional y la Fiscalía, y la capa de seguridad distribuida (anonimato del denunciante, cifrado en tránsito y en reposo, registro de acceso, auditoría y monitoreo) son ingeniería clásica, y deben seguir siéndolo. En un sistema donde un fallo pone en riesgo la integridad física de una persona, el determinismo no es una preferencia de estilo: es un requisito de seguridad. La regla del capítulo 1 (Vol. 3) (el agente propone, el humano aprueba lo irreversible) aquí se endurece a un principio de diseño: ninguna acción con consecuencia legal o de seguridad cuelga de una decisión probabilística.»Dónde encaja el agente, entonces, y por qué tan estrecho Tres puntos, todos de lectura o redacción supervisada, ninguno de acción autónoma. El primero es el microservicio de análisis: clasifica y prioriza las denuncias entrantes (urgencia, patrón de reincidencia, vínculo con casos abiertos) para que un analista humano atienda primero lo que más importa; es triaje, el caso 4 elevado a un dominio donde equivocarse es caro, y por eso su salida es una recomendación de prioridad con su evidencia, nunca un archivado automático. El segundo es el anonimato como redacción asistida: un agente acotado detecta y enmascara información que podría identificar a la víctima antes de que la denuncia circule entre entidades, con revisión humana sobre la fracción de baja confianza (el patrón del caso 3). El tercero es el enriquecimiento del dato de IoT y drones: clasificar y resumir el flujo de telemetría y evidencia para el panel de control, el patrón CDC → agente enriquecedor → consumidores que el capítulo 7 formaliza, operando sobre el flujo sin tocar las bases de origen (mínimo privilegio estructural, capítulo 4).
Sección titulada «Dónde encaja el agente, entonces, y por qué tan estrecho Tres puntos, todos de lectura o redacción supervisada, ninguno de acción autónoma. El primero es el microservicio de análisis: clasifica y prioriza las denuncias entrantes (urgencia, patrón de reincidencia, vínculo con casos abiertos) para que un analista humano atienda primero lo que más importa; es triaje, el caso 4 elevado a un dominio donde equivocarse es caro, y por eso su salida es una recomendación de prioridad con su evidencia, nunca un archivado automático. El segundo es el anonimato como redacción asistida: un agente acotado detecta y enmascara información que podría identificar a la víctima antes de que la denuncia circule entre entidades, con revisión humana sobre la fracción de baja confianza (el patrón del caso 3). El tercero es el enriquecimiento del dato de IoT y drones: clasificar y resumir el flujo de telemetría y evidencia para el panel de control, el patrón CDC → agente enriquecedor → consumidores que el capítulo 7 formaliza, operando sobre el flujo sin tocar las bases de origen (mínimo privilegio estructural, capítulo 4).»La lección que generaliza En los dominios de alto riesgo, el valor del agente no está en automatizar la decisión sino en afilar la atención humana hacia ella: priorizar, enmascarar, resumir, enriquecer. El sistema sigue siendo determinista en su columna vertebral; el agente vive en sus márgenes, donde un error se traduce en «un humano mira algo en distinto orden», no en «una denuncia se pierde». Diseñar así no es timidez tecnológica: es la aplicación literal de los principios de seguridad (capítulo 4) y de la política de acciones críticas (capítulo 1 (Vol. 3)) a un dominio que no perdona. El playbook completo, entonces, no es una lista de lugares donde poner agentes; es el criterio para decidir cuán estrecho debe ser cada uno; y en los sistemas que más importan, la respuesta correcta suele ser «más estrecho de lo que el entusiasmo sugiere».
Sección titulada «La lección que generaliza En los dominios de alto riesgo, el valor del agente no está en automatizar la decisión sino en afilar la atención humana hacia ella: priorizar, enmascarar, resumir, enriquecer. El sistema sigue siendo determinista en su columna vertebral; el agente vive en sus márgenes, donde un error se traduce en «un humano mira algo en distinto orden», no en «una denuncia se pierde». Diseñar así no es timidez tecnológica: es la aplicación literal de los principios de seguridad (capítulo 4) y de la política de acciones críticas (capítulo 1 (Vol. 3)) a un dominio que no perdona. El playbook completo, entonces, no es una lista de lugares donde poner agentes; es el criterio para decidir cuán estrecho debe ser cada uno; y en los sistemas que más importan, la respuesta correcta suele ser «más estrecho de lo que el entusiasmo sugiere».»Lo esencial del capítulo 5
Sección titulada «Lo esencial del capítulo 5»- Empiece por lo que falla barato: review que comenta, onboarding que cita, documentación que propone PRs.
- Los casos avanzados exigen la madurez de los básicos: soporte con tres rutas y duda conservadora; investigación con citas y adversario; plataforma como producto.
- Las métricas vanidosas (resolución automática, volumen generado) suben empeorando el sistema; las honestas tienen denominador de valor y se miden por ruta.
- El agente propone; el humano aprueba lo irreversible. En los seis casos, sin excepción.
- La plataforma convierte el gobierno en el camino de menor resistencia: esa es la meta final del playbook.
- En dominios de misión crítica el agente vive en los márgenes (priorizar, enmascarar, resumir, enriquecer), no en la columna vertebral determinista: afila la atención humana, no reemplaza la decisión.
- Claude, OpenAI, Google y Kimi implementan el mismo patrón orquestador-trabajador con sintaxis distinta (Task tool/Workflow, handoffs, ParallelAgent, Agent Swarm): el gateway multiproveedor traduce, el negocio no se reescribe.
- El entorno no solo cambia credenciales: cambia el techo de autonomía permitido. Ascender de stage a producción es una solicitud de autonomía con evidencia, no un deploy más.
- Las dependencias entre equipos se gobiernan con contratos dirigidos por el consumidor; las dependencias con terceros externos, con un presupuesto de degradación probado en stage. Ambas se registran junto al agente que las usa, no solo el agente.
- Un agente de fondo sin sesión interactiva (Spotify) y una sesión remota controlada desde el celular son la misma decisión de arquitectura vista desde dos ángulos: dónde y cuándo se ejerce la supervisión humana, no si existe.