Capítulo 3: Platform Engineering en la era agéntica
La plataforma como producto interno
Sección titulada «La plataforma como producto interno»La ingeniería de plataforma (Platform Engineering) es la disciplina que construye los caminos pavimentados por donde transitan los equipos de desarrollo de una organización. No es infraestructura: es la abstracción que convierte operaciones complejas (desplegar una aplicación, conectar una base de datos, configurar observabilidad) en acciones de un clic, o de una instrucción en lenguaje natural.
El marco de referencia es Team Topologies Skelton & Pais, 2019: la estructura de los equipos debe diseñarse para minimizar la carga cognitiva de los equipos alineados al flujo de valor (stream-aligned teams). El equipo de plataforma existe para absorber esa carga cognitiva, y su producto, la plataforma interna, se gestiona como cualquier producto: con usuarios, hoja de ruta y métricas de adopción.
En la era agéntica, el equipo de plataforma adquiere una responsabilidad adicional: exponer las capacidades de IA como primitivas de primera clase de la plataforma interna. Si cada equipo negocia su propia clave de API, elige su propio modelo, implementa su propio control de costos y resuelve su propia seguridad, la organización tiene tantos puntos de fallo (técnicos, económicos y regulatorios) como equipos.
► PISTA TÉCNICA: Arquitectura de una AI Platform
Justificación de diseño: diagrama de secuencia para modelado de interacción
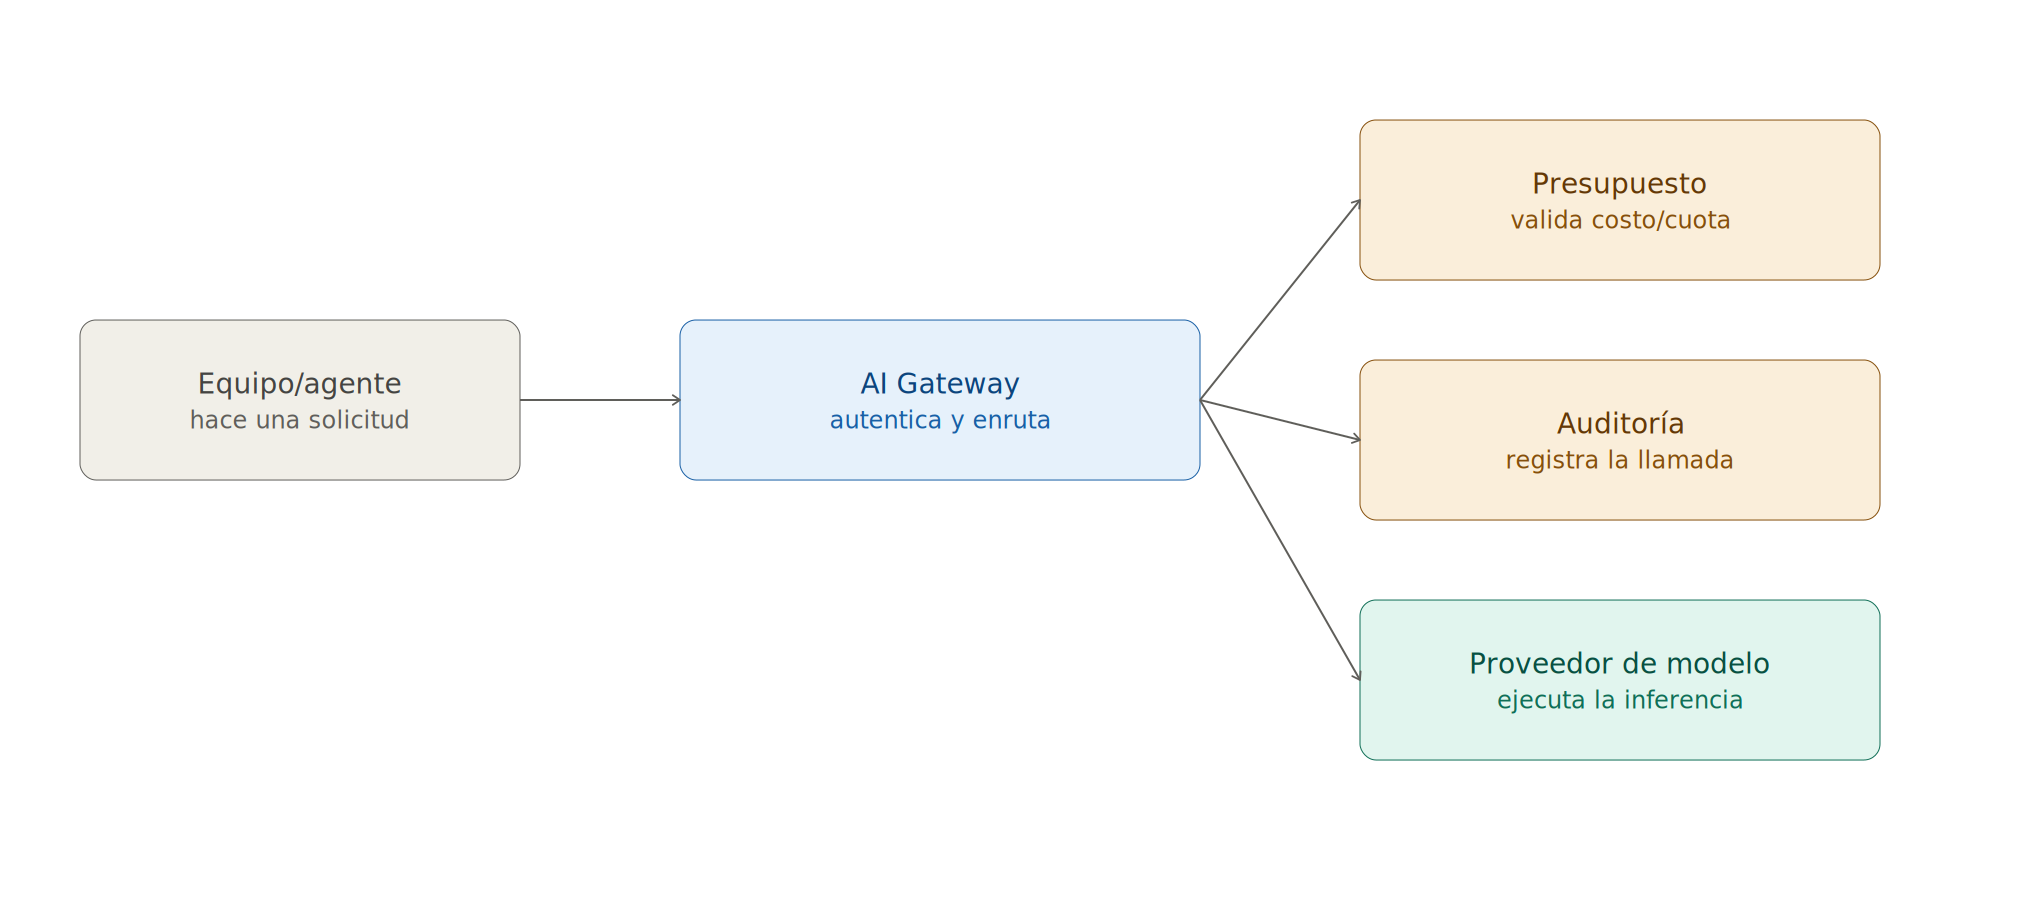
El AI Gateway es ante todo un flujo: una solicitud entra, pasa por capas (validación, enrutamiento, ejecución, registro), y sale con un costo. Lo que importa es el orden temporal de esos pasos: cuánto cuesta cada uno, cuánto tiempo toma, dónde se revisa antes de proseguir.
Un diagrama de componentes mostraría dónde vive el gateway en la arquitectura; un diagrama de clases mostraría sus partes internas. Aquí necesitamos el flujo en el tiempo, la secuencia de decisiones y gastos que definen si la solicitud prospera o se rechaza.
En este libro reaparece el diagrama de secuencia en el Capítulo 7 (Vol. 4) (el flujo CDC → Agente → Consumidores), donde nuevamente el tiempo y el desacoplamiento temporal son el mensaje central.
El AI Gateway: el componente más crítico
Sección titulada «El AI Gateway: el componente más crítico»El AI Gateway es el punto de entrada único a todos los modelos de IA de la organización. Sus responsabilidades mínimas: enrutamiento por complejidad de tarea, contabilidad de costos por equipo, presupuestos con cortes automáticos, registro de auditoría y lógica de reserva (fallback) entre proveedores.
# Ejemplo 3.1: AI Gateway mínimo viable# Centraliza routing, cost tracking y presupuestos por equipo.## NOTA SOBRE PRECIOS: los valores corresponden a la documentación pública# de Anthropic al cierre de edición (2026). Los precios y los identificadores# de modelo cambian: consúltelos en https://platform.claude.com/docs antes# de usar este código en producción. El PATRÓN es lo estable.
import timefrom dataclasses import dataclass, fieldfrom typing import Optional
import anthropic
@dataclassclass ModelConfig:    model_id: str    cost_per_million_input: float   # USD por millón de tokens de entrada    cost_per_million_output: float  # USD por millón de tokens de salida    max_context_tokens: int    latency_tier: str               # "fast" | "balanced" | "quality"
MODEL_REGISTRY = {    "quality": ModelConfig(        model_id="claude-opus-4-8",        cost_per_million_input=5.00,        cost_per_million_output=25.00,        max_context_tokens=1_000_000,        latency_tier="quality",    ),    "balanced": ModelConfig(        model_id="claude-sonnet-4-6",        cost_per_million_input=3.00,        cost_per_million_output=15.00,        max_context_tokens=1_000_000,        latency_tier="balanced",    ),    "fast": ModelConfig(        model_id="claude-haiku-4-5",        cost_per_million_input=1.00,        cost_per_million_output=5.00,        max_context_tokens=200_000,        latency_tier="fast",    ),}
class BudgetExceededError(Exception):    pass
class AIGateway:    """    Punto único de acceso a modelos de IA en la organización.    Responsable de: routing, cost tracking, presupuesto, auditoría.    """
    def __init__(self, team_id: str, budget_usd_monthly: float):        self.client = anthropic.Anthropic()  # usa ANTHROPIC_API_KEY del entorno        self.team_id = team_id        self.budget_usd_monthly = budget_usd_monthly        self.cost_this_month = 0.0        self.request_log: list[dict] = []
    def _select_model(self, task_complexity: str,                      force_model: Optional[str] = None) -> ModelConfig:        """Selección automática de modelo según complejidad declarada."""        if force_model:            return MODEL_REGISTRY[force_model]        # Routing por complejidad: tareas simples no deben pagar precio premium        routing = {            "simple": "fast",       # clasificación, extracción, resumen corto            "moderate": "balanced", # generación de código, análisis, Q&A            "complex": "quality",   # arquitectura, razonamiento multi-paso        }        return MODEL_REGISTRY[routing.get(task_complexity, "balanced")]
    def _calculate_cost(self, model: ModelConfig,                        input_tokens: int, output_tokens: int) -> float:        return (            (input_tokens / 1_000_000) * model.cost_per_million_input            + (output_tokens / 1_000_000) * model.cost_per_million_output        )
    def complete(        self,        messages: list,        system: str = "",        task_complexity: str = "moderate",        force_model: Optional[str] = None,        max_tokens: int = 2048,    ) -> dict:        model_config = self._select_model(task_complexity, force_model)
        # Verificar presupuesto ANTES de ejecutar        if self.cost_this_month >= self.budget_usd_monthly * 0.95:            raise BudgetExceededError(                f"Equipo {self.team_id}: 95% del presupuesto mensual consumido. "                f"Costo actual: ${self.cost_this_month:.2f} / "                f"${self.budget_usd_monthly:.2f}"            )
        start_time = time.time()        response = self.client.messages.create(            model=model_config.model_id,            max_tokens=max_tokens,            system=system,            messages=messages,        )        latency_ms = (time.time() - start_time) * 1000
        cost = self._calculate_cost(            model_config,            response.usage.input_tokens,            response.usage.output_tokens,        )        self.cost_this_month += cost
        # Audit log: cada request queda registrado para análisis posterior        self.request_log.append({            "team": self.team_id,            "model": model_config.model_id,            "complexity": task_complexity,            "input_tokens": response.usage.input_tokens,            "output_tokens": response.usage.output_tokens,            "cost_usd": cost,            "latency_ms": round(latency_ms),            "timestamp": time.time(),        })
        text = next(b.text for b in response.content if b.type == "text")        return {            "content": text,            "model_used": model_config.model_id,            "cost_usd": cost,            "tokens": {                "input": response.usage.input_tokens,                "output": response.usage.output_tokens,            },        }

# Uso típico en un equipo:# gateway = AIGateway(team_id="backend-platform", budget_usd_monthly=500.0)# result = gateway.complete(#     system="Eres un experto en revisión de código.",#     messages=[{"role": "user", "content": f"Revisa este código:\n\n{code}"}],#     task_complexity="moderate",  # el Gateway selecciona el modelo balanceado# )# print(f"Costo de esta operación: ${result['cost_usd']:.4f}")
Gateway multiproveedor
Sección titulada «Gateway multiproveedor»Un gateway de producción rara vez habla con un solo proveedor. La buena noticia es que las tres APIs dominantes comparten la misma forma conceptual (mensajes con roles, herramientas con esquemas JSON, conteo de tokens en la respuesta), de modo que la capa de abstracción es delgada:
# Ejemplo 3.2: Adaptadores mínimos para Claude, OpenAI y Gemini.# Cada proveedor tiene su SDK oficial; el contrato interno es común.# Verifique modelos y precios vigentes en la documentación de cada proveedor.
class ClaudeAdapter:    def __init__(self):        import anthropic        self.client = anthropic.Anthropic()
    def complete(self, system: str, user: str, model: str, max_tokens: int) -> str:        resp = self.client.messages.create(            model=model, max_tokens=max_tokens,            system=system, messages=[{"role": "user", "content": user}],        )        return next(b.text for b in resp.content if b.type == "text")
class OpenAIAdapter:    def __init__(self):        from openai import OpenAI        self.client = OpenAI()  # usa OPENAI_API_KEY del entorno
    def complete(self, system: str, user: str, model: str, max_tokens: int) -> str:        resp = self.client.chat.completions.create(            model=model, max_completion_tokens=max_tokens,            messages=[{"role": "system", "content": system},                      {"role": "user", "content": user}],        )        return resp.choices[0].message.content
class GeminiAdapter:    def __init__(self):        from google import genai        self.client = genai.Client()  # usa GEMINI_API_KEY del entorno
    def complete(self, system: str, user: str, model: str, max_tokens: int) -> str:        resp = self.client.models.generate_content(            model=model, contents=user,            config={"system_instruction": system,                    "max_output_tokens": max_tokens},        )        return resp.text
La decisión de cuándo enrutar a cada proveedor es de negocio, no de fe: se toma con evaluaciones propias (capítulo 3 (Vol. 4)) sobre las tareas propias, y se revisa trimestralmente, porque la frontera de calidad-precio entre proveedores se mueve varias veces al año.
■ PISTA EJECUTIVA: El ROI del Platform Engineering agéntico
Un equipo de plataforma de cuatro a seis ingenieros que construye una AI-IDP bien diseñada puede multiplicar la productividad de cincuenta a cien ingenieros de producto. El modelo económico es el mismo que el de la infraestructura cloud: en lugar de que cada equipo configure sus propios servidores, la plataforma abstrae esa complejidad. La diferencia en la era agéntica es que el «servidor» es el acceso a la inteligencia, y la «configuración» incluye selección de modelos, gestión de costos, evaluación de calidad y gobernanza de datos.
Hay además un argumento de riesgo que suele pesar más que el de productividad: sin gateway central no hay inventario de uso, y sin inventario de uso no hay forma de responder a un auditor, interno o regulatorio, qué datos salieron hacia qué proveedor. El marco de gestión de riesgos de IA del NIST (2023) y el Reglamento Europeo de IA Unión Europea, 2024 convergen en la misma exigencia práctica: trazabilidad. La plataforma es el lugar natural donde esa trazabilidad se implementa una vez y se hereda gratis.
Métricas clave para medir el éxito de una AI Platform:
| Métrica | Línea base (sin plataforma) | Objetivo (6 meses post-plataforma) |
|---|---|---|
| Tiempo de integración de IA en una funcionalidad nueva | 2–3 semanas | 2–3 días |
| Costo por request a LLM | Sin visibilidad | Visible y < $0,01 en tareas simples |
| % de requests enrutados al modelo de costo correcto | 0 % (manual) | > 80 % (automático) |
| Incidentes por alucinaciones en producción | Sin métricas | Medidos, con presupuesto de error explícito |
| Cobertura de evaluación automática de agentes | 0 % | > 70 % de los casos núcleo |
Ejercicio resuelto 3.1: añada el corte por proyecto al gateway
Sección titulada «Ejercicio resuelto 3.1: añada el corte por proyecto al gateway»Enunciado. El AIGateway del ejemplo 3.1 presupuesta por equipo. Finanzas pide presupuesto por proyecto dentro de cada equipo, con una política distinta: al agotarse, no fallar, degradar al modelo económico y avisar. Diseñe el cambio mínimo.
Solución comentada. Tres cambios, ninguno estructural. Primero, complete() recibe project_id y el registro de presupuestos pasa de un escalar a un diccionario {project_id: Budget}; el log de auditoría ya registra todo lo necesario para reconstruir el gasto por proyecto retroactivamente, dividendo directo de haberlo registrado desde el día uno. Segundo, la política de agotamiento se vuelve explícita y enumerada (HARD_STOP, la actual, o DEGRADE, la nueva), porque una política implícita es un incidente esperando ocurrir. Tercero, en DEGRADE, _select_model fuerza el tier fast y el resultado lleva "degraded": True: el consumidor debe saber que recibió calidad reducida. Degradar en silencio es mentir con infraestructura. El matiz que separa al senior: la degradación también se registra como métrica; si un proyecto pasa el 30 % del mes degradado, el problema no es el presupuesto, es la estimación (capítulo 2 (Vol. 4)) o las cinco causas de Token-Burn (capítulo 1 (Vol. 4)).
Lo esencial del capítulo 3
Sección titulada «Lo esencial del capítulo 3»- La plataforma interna es un producto Skelton & Pais, 2019; en la era agéntica expone la IA como primitiva de primera clase.
- El AI Gateway es el componente crítico: enrutamiento por complejidad, costo por equipo, presupuestos con corte, auditoría, fallback.
- Sin gateway no hay inventario; sin inventario no hay respuesta para el auditor (NIST, 2023; Unión Europea, 2024).
- Las tres APIs dominantes comparten forma conceptual: la capa multiproveedor es delgada y el enrutamiento se decide con evals propios, trimestralmente.
- Un equipo de plataforma de 4–6 multiplica a 50–100 ingenieros de producto: la economía del cloud, aplicada a la inteligencia.
Preguntas para discusión
Sección titulada «Preguntas para discusión»- ¿Cuántos equipos de su organización usan hoy modelos de IA con claves de API propias, fuera de cualquier inventario central?
- Si mañana un proveedor duplicara sus precios o degradara un modelo, ¿cuánto tardaría su organización en redirigir el tráfico a otro?
- ¿Quién es, hoy, el «dueño de producto» de la plataforma interna de IA? Si la respuesta es «nadie», ¿qué incidente tendrá que ocurrir para que exista?